什么是LLM-as-judge?用一个AI来给另一个AI的答案打分
 什么是LLM-as-judge?用一个AI来给另一个AI的答案打分
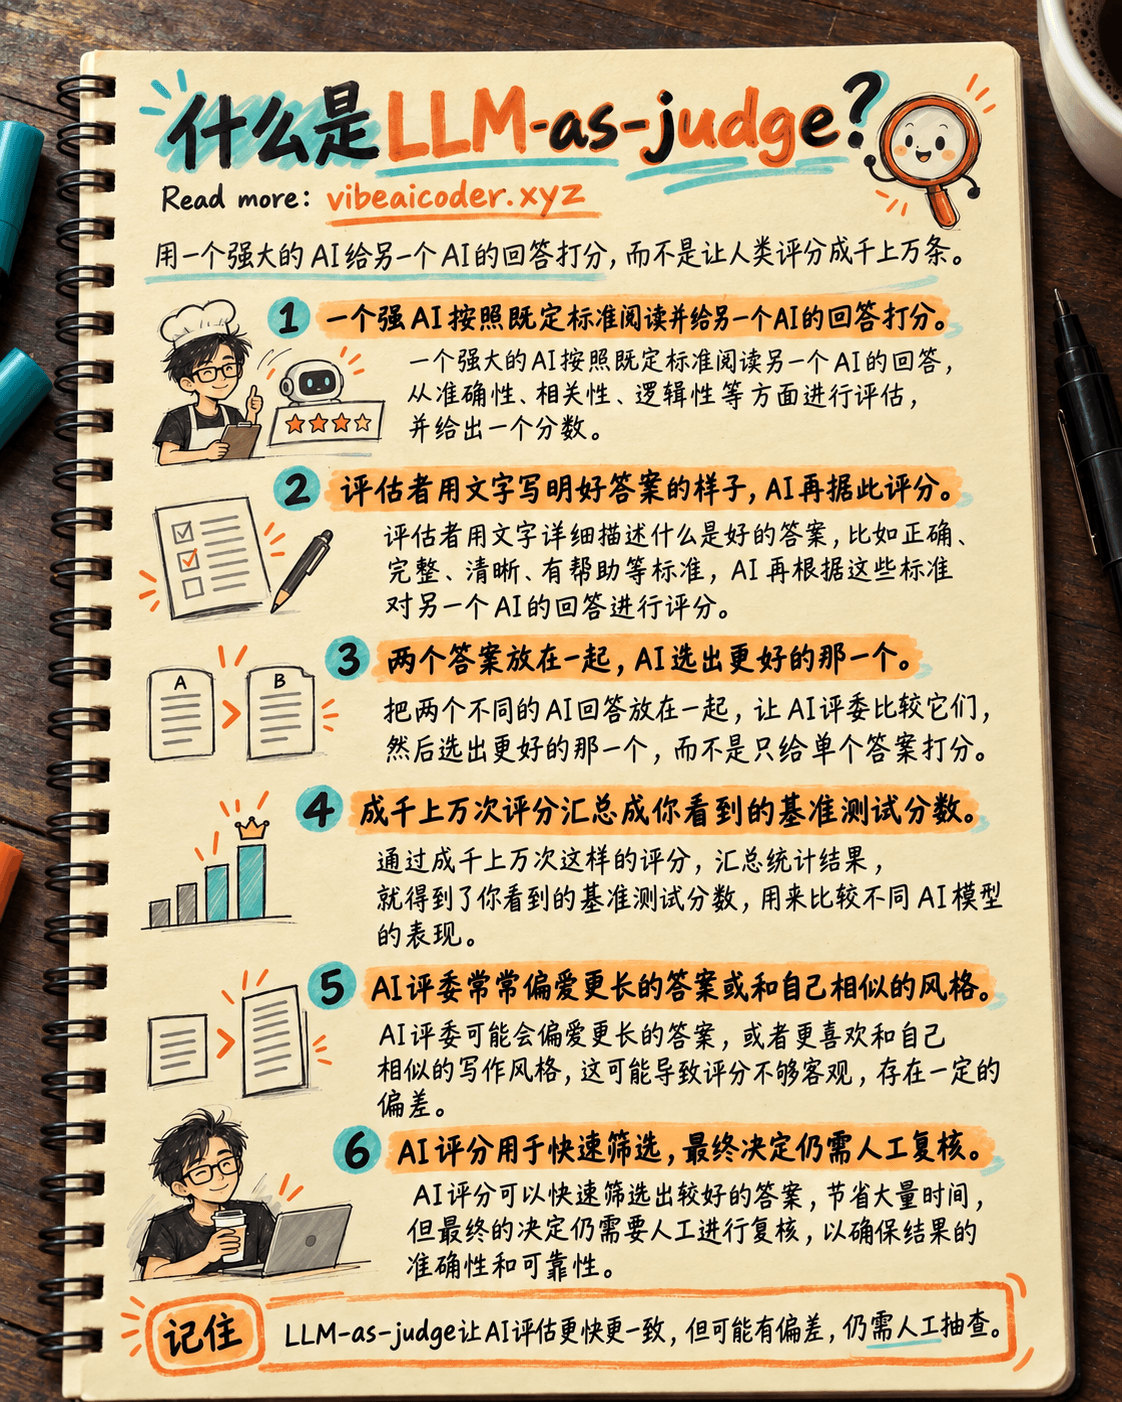
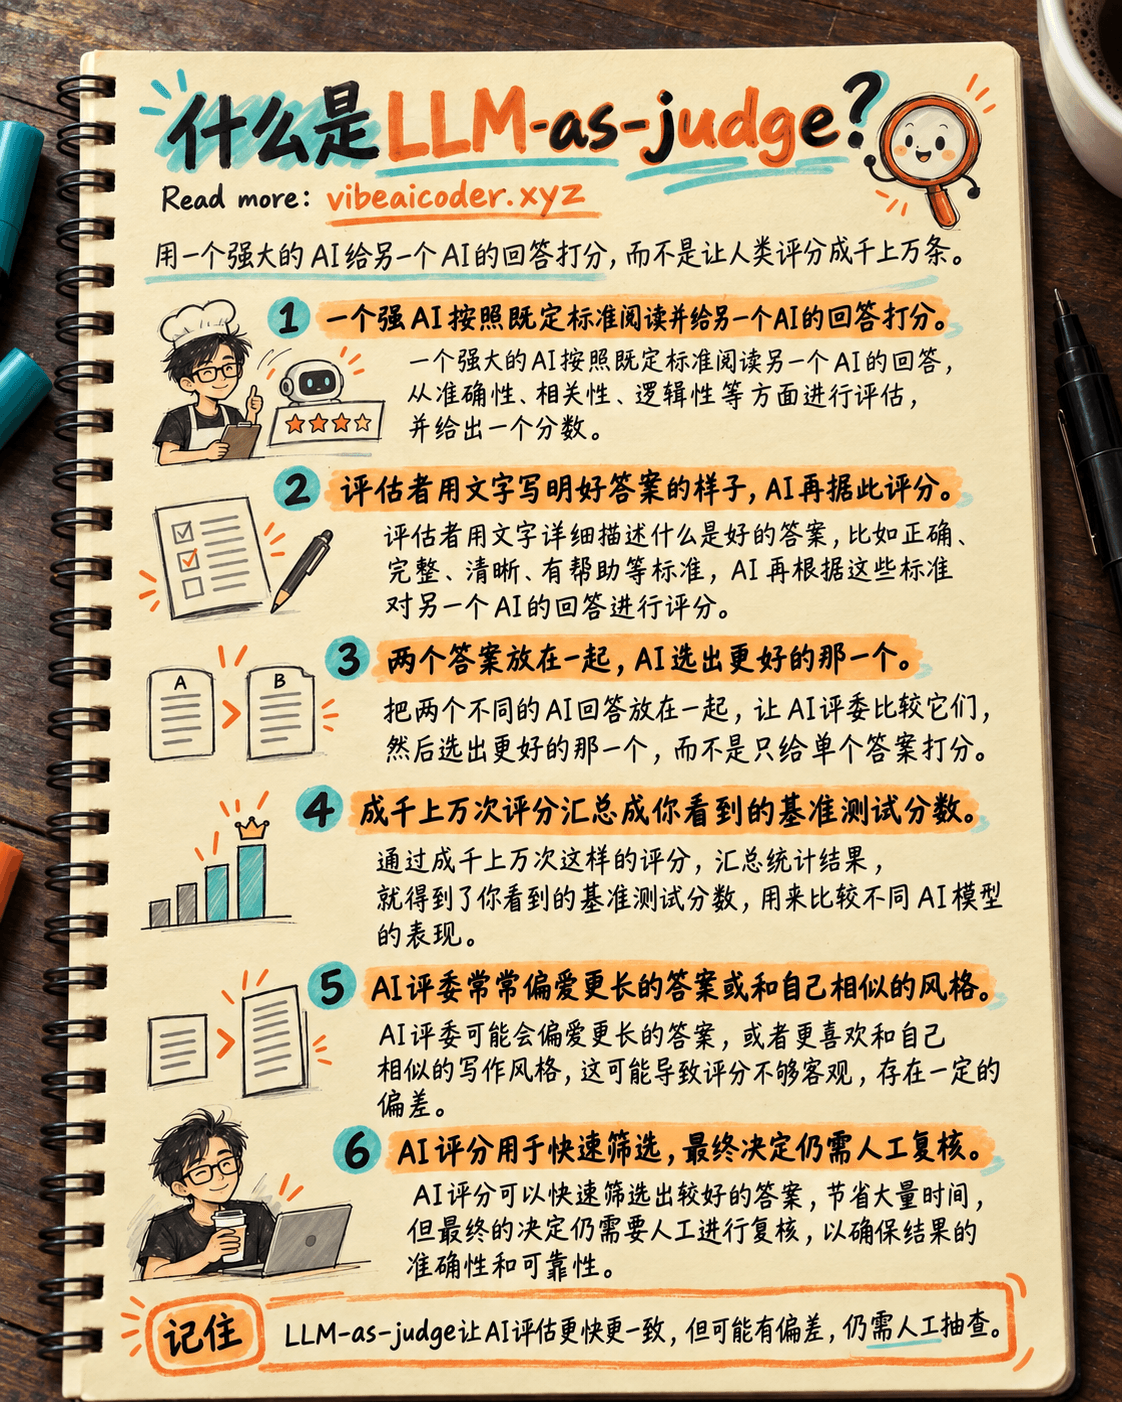
LLM-as-judge(AI评委)是一种方法:用一个大语言模型给另一个AI(或者它自己)生成的答案打分或者做比较,而不是让人类逐条阅读和评分每一个答案。这是Anthropic、OpenAI、谷歌等公司在发布基准测试排行榜之前,用来检验新模型是否真的比旧模型更好的主要工具。了解它可以帮助你更理性地看待"模型X比模型Y高出Z%"这类新闻。
 用生活中的例子快速理解
想象一场有1000名选手参加的烹饪比赛,每人提交一道菜。如果请人类评委品尝全部1000道菜,写评语再排名,会非常耗时耗钱,而且两位评委也可能因为口味不同而给出不同的评价。
AI公司的做法更接近于请一位优秀的厨师来做唯一的评委,只不过这位厨师不是人,而是一个强大的AI模型(通常是目前最强的模型,比如Claude Opus或GPT-4)。你给这位"AI厨师"一套评分标准(菜够不够好吃、是否做熟、是否符合菜谱),它就能在几分钟内给成千上万道菜打分,而且每次都按照同样的标准,保持一致。这正是LLM-as-judge的核心:一个AI阅读另一个AI的答案,根据事先写好的标准打分或者选出更好的那个。
 它是怎么运作的
LLM-as-judge的流程通常包括以下几步:
- 写出评分标准:评估者用文字描述什么样的答案算好,比如"信息准确、直接回答问题、不啰嗦、语气礼貌"。
- 准备需要评分的问题和答案:可以是单个模型的答案(打1到10分),也可以是两个模型的答案放在一起比较,让评委选出哪个更好(称为"成对比较")。
- 把这些内容发给AI评委:系统会把原始问题、需要评分的答案、评分标准,有时还有一个参考答案组合成一个提示词,发给评委模型。
- AI评委返回结构化结果:给出一个分数,或者在"答案A获胜 / 答案B获胜 / 平局"之间做出选择,并附上简短理由。
- 把成千上万次的评分结果汇总成一个总体数字,这正是排行榜上显示的内容。
这种方法在2023年论文《Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena》发表后被广泛采用。该研究显示,用一个强大的模型(当时是GPT-4)作为评委时,它的判断与人类评价的一致率超过80%,接近两位人类评委之间的一致程度。因此,许多评估工具,包括让用户投票的Chatbot Arena这类评分系统,现在都会用AI评委来处理人类根本来不及手动评分的海量答案。
 这对你意味着什么
你不需要自己搭建一套LLM-as-judge系统,也能用上这个思路:
- 更理性地看待"模型X比模型Y高出Z分"这类新闻:问问自己这个数字是人类评出来的,还是另一个AI评出来的,评分标准又是什么。换一个AI评委或换一套标准,排名可能完全不同。
- 为自己的工作搭建一个迷你"评委":如果你经常让AI为同一件事写出好几个版本(比如5个广告文案),可以让同一个AI(或另一个AI)按照你设定的标准给这5个版本打分,比如"简洁、有明确的行动号召、语气积极",然后再自己阅读分数最高的那一版。示例提示词:"请按1到10分,根据以下3个标准给下面5个文案打分:简洁、有明确的行动号召、语气积极。每个分数请给出简短理由。"
- 理解为什么两个排行榜结果不一样:一个排行榜用GPT做评委,另一个用Claude做评委,每个评委都可能略微偏爱风格和自己相似的答案,所以不要把任何一个排行榜当成绝对真理。
 常见误解
- "AI评委一定比人类更客观。" 并不尽然。研究发现AI评委存在几种系统性偏差:倾向于偏爱更长的答案(冗长偏差)、倾向于偏爱某个位置的答案(位置偏差,交换答案A和B的顺序可能改变结果)、尤其是倾向于偏爱风格与自己相似的答案(自我偏好偏差)。
- "LLM-as-judge完全取代了人类。" 实际上它通常是和人类配合使用:AI快速给大量样本打分,筛选出值得关注的情况,然后人类再抽查一小部分样本,确认AI的评分是否准确。这也是核实AI答案的一种方式,而不是跳过人工检查这一步。
- "分数高就意味着答案一定正确。" AI评委是按照写好的标准打分,并不会独立核实现实世界中的事实。一个表述流畅、语气自信但内容是编造的答案,类似于前面提到的AI幻觉现象,如果评分标准没有要求核实事实,这样的答案仍然可能得到高分。
常见问题
LLM-as-judge和普通的基准测试有什么区别? 基准测试是一套固定的题目,有明确的对错答案,机器可以自动判分(比如有确定答案的数学题)。LLM-as-judge用于没有唯一正确答案的开放式问题,比如写作、建议、对话,这类问题需要判断"好不好",而不只是"对不对"。
做评委的AI需要比被评分的AI更强吗? 通常是的,因为评委需要有足够的能力去理解和分析复杂的答案。很多研究都用当时最强的模型来给所有其他模型(包括比它弱的模型)当评委。
我可以用这种方法给学生作业或员工工作打分吗? 技术上可以,但需要谨慎:AI评委可能偏爱篇幅更长或者风格它熟悉的文章,所以最好只用来做初步筛选或提供建议。真正会影响成绩或绩效评价的最终决定,仍然应该由人来审核。
为什么AI公司不只用固定的基准测试,还需要LLM-as-judge? 因为现代AI的很多能力,比如自然对话、创意写作、回答开放式问题,都没有机器能自动核对的"唯一正确答案",所以需要一个能阅读和理解的AI来评判整体质量,这更接近人类阅读后给出评价的方式。
LLM-as-judge和RLHF有关系吗? 两者相关但不是一回事。RLHF是一个训练步骤,模型通过反馈(最初主要来自人类,现在也有一部分来自AI)学习如何回答得更好。LLM-as-judge是一种评估工具,用来衡量一个模型的答案已经达到什么水平,它既可以单独使用,也可以作为训练过程的一部分。
如果你刚开始从零学习AI,可以先阅读什么是AI,面向初学者的简单解释,打好基础之后再回来深入了解AI质量是如何被评估的。
#AI #LLM #AI评估 #基准测试 #vibeaicoder
 为什么打越南语比打英语消耗更多token?



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制