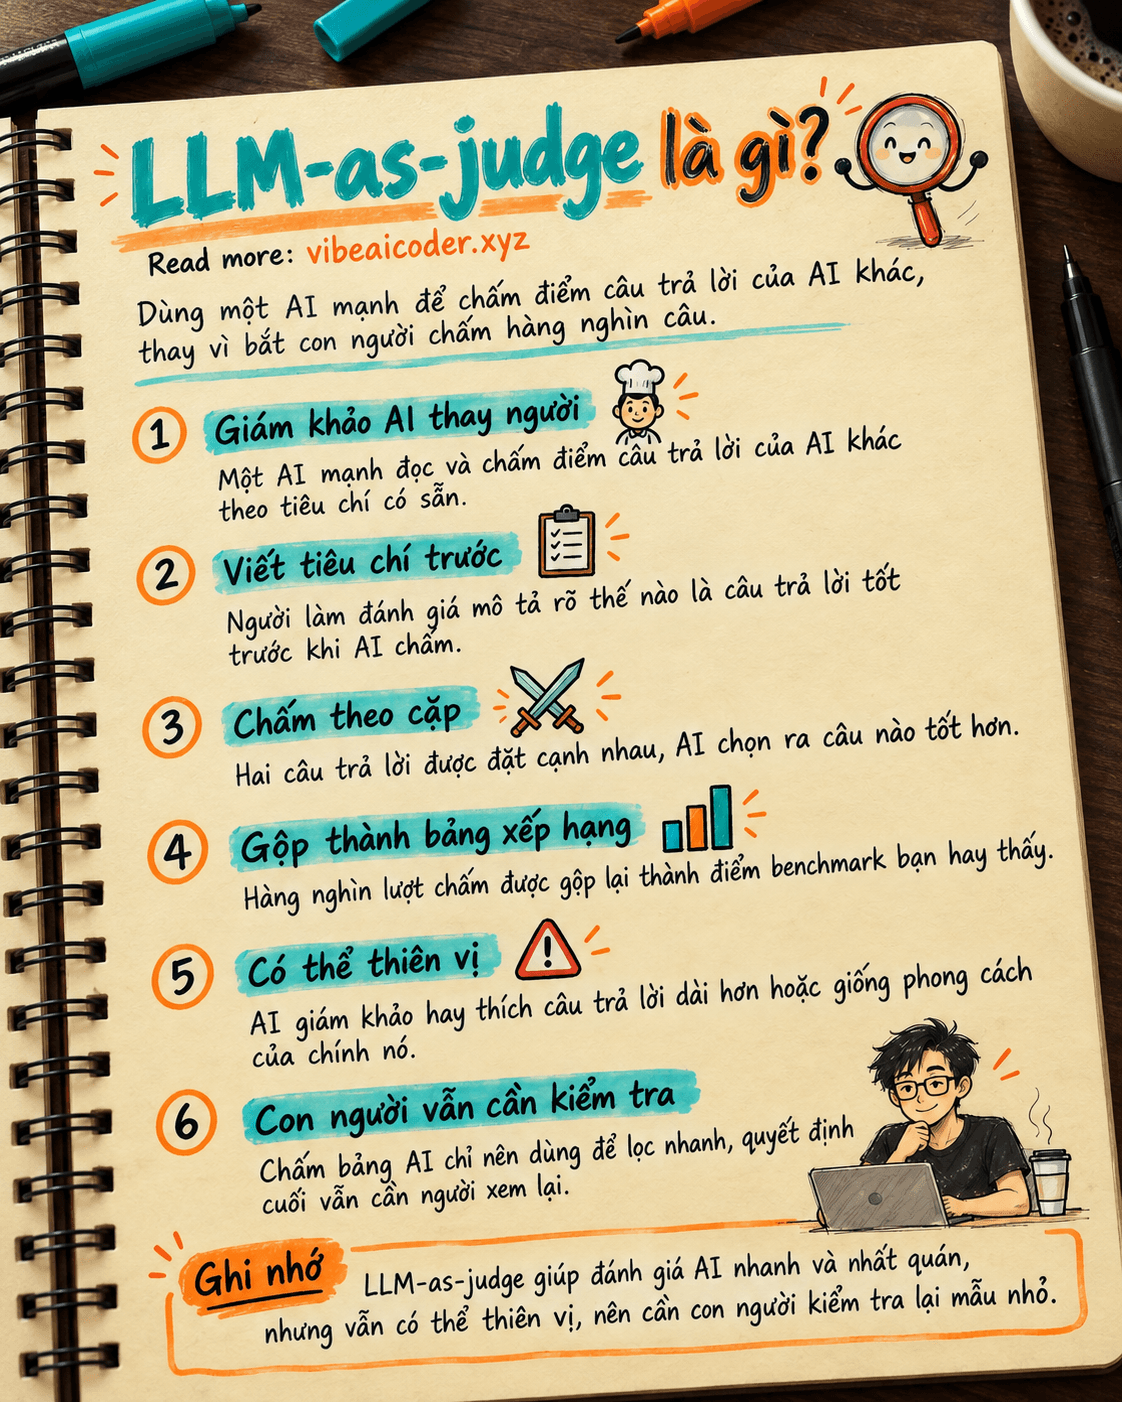
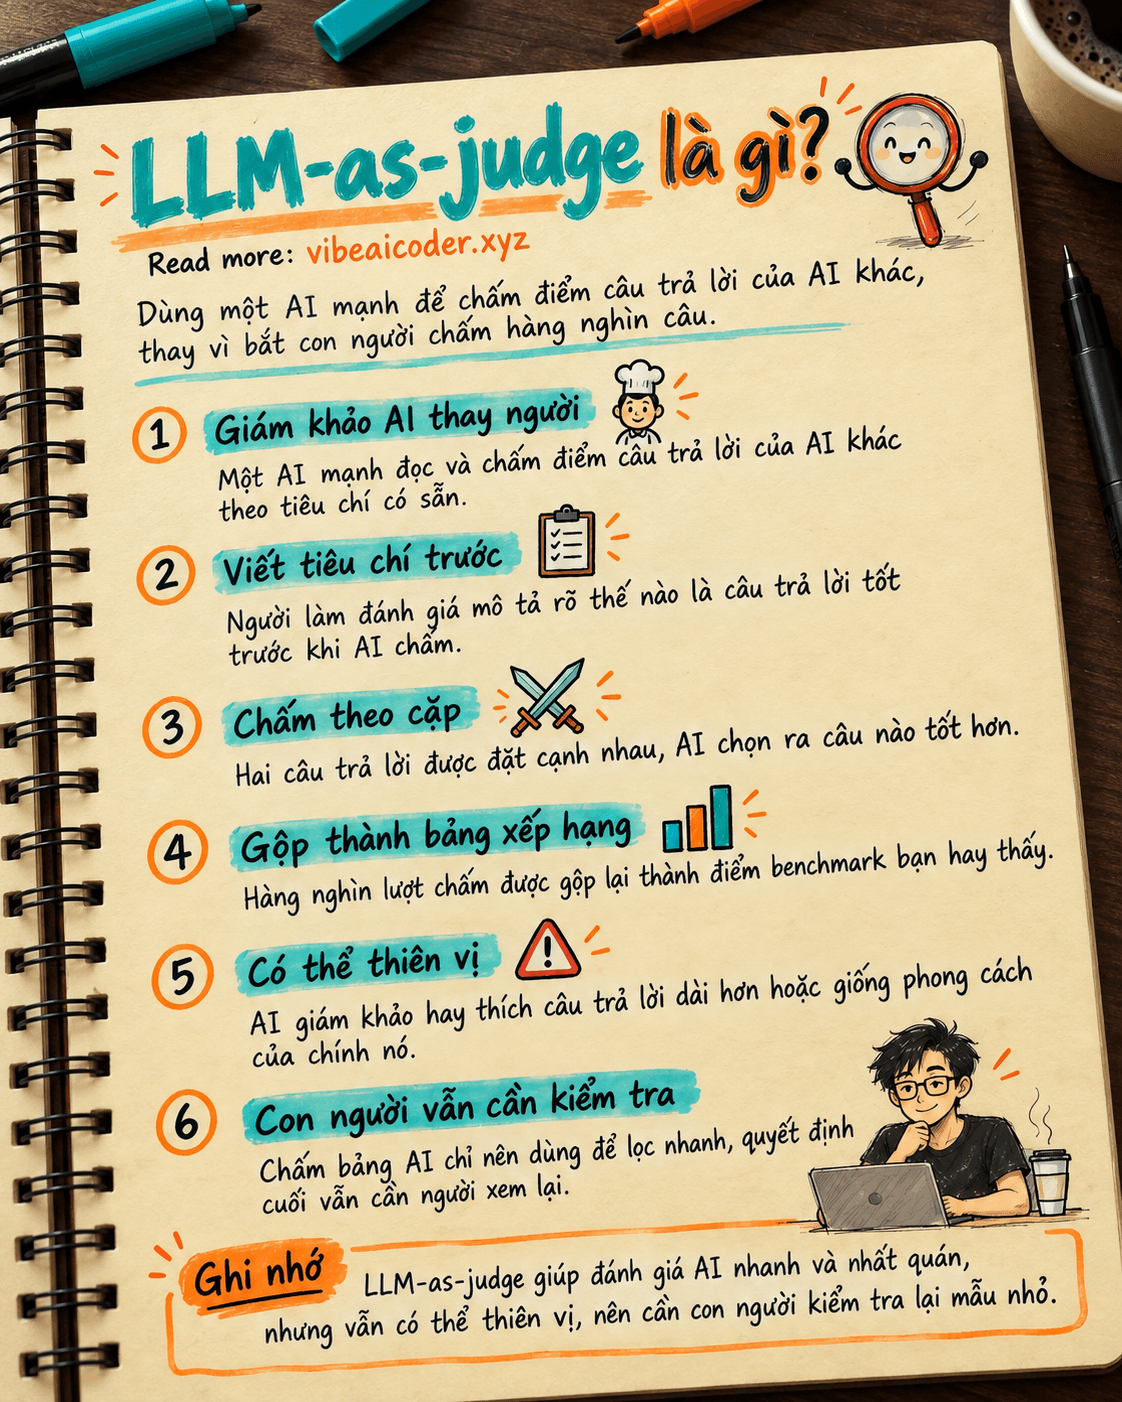
LLM-as-judge là gì? Dùng một AI để chấm điểm câu trả lời của AI khác
 LLM-as-judge là gì? Dùng một AI để chấm điểm câu trả lời của AI khác
LLM-as-judge (tạm dịch: "AI làm giám khảo") là cách dùng một mô hình ngôn ngữ lớn để chấm điểm hoặc so sánh câu trả lời do một AI khác (hoặc chính nó) tạo ra, thay vì bắt con người ngồi đọc từng câu trả lời để chấm. Nó đang là công cụ chính để các công ty như Anthropic, OpenAI hay Google kiểm tra xem model mới có thực sự tốt hơn model cũ hay không, trước khi đưa ra bảng xếp hạng benchmark mà bạn hay thấy. Hiểu được nó giúp bạn đọc các con số "AI này giỏi hơn AI kia X%" một cách tỉnh táo hơn.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng một cuộc thi nấu ăn có 1.000 thí sinh, mỗi người nộp một món. Nếu mời giám khảo con người nếm hết 1.000 món, nhận xét từng món rồi xếp hạng, việc đó tốn rất nhiều thời gian và tiền bạc, chưa kể hai giám khảo có thể chấm khác nhau vì khẩu vị riêng.
Giải pháp của các công ty AI gần giống việc mời một đầu bếp giỏi làm giám khảo duy nhất, nhưng đầu bếp đó không phải người, mà là một AI mạnh (thường là model tốt nhất đang có, ví dụ Claude Opus hoặc GPT-4). Bạn đưa cho "đầu bếp AI" này một bộ tiêu chí chấm điểm (món có đủ ngon, đủ chín, đúng công thức không), rồi nó chấm hàng nghìn món ăn chỉ trong vài phút, theo đúng tiêu chí đó, lần nào cũng nhất quán như lần nào. Đó chính là tinh thần của LLM-as-judge: một AI đọc câu trả lời của AI khác và cho điểm hoặc chọn ra câu trả lời tốt hơn, dựa trên tiêu chí được viết sẵn.
 Nó hoạt động thế nào
Quy trình LLM-as-judge thường có mấy bước sau:
- Viết tiêu chí chấm điểm (rubric): người làm đánh giá mô tả bằng lời thế nào là câu trả lời tốt, ví dụ "đúng sự thật, trả lời đúng trọng tâm câu hỏi, không dài dòng, giọng văn lịch sự".
- Chuẩn bị câu hỏi và câu trả lời cần chấm: có thể là câu trả lời của một model duy nhất (chấm điểm từ 1 đến 10), hoặc câu trả lời của hai model đặt cạnh nhau để so sánh ai hơn ai (gọi là "chấm theo cặp").
- Gửi tất cả cho AI giám khảo: một prompt được ghép từ câu hỏi gốc, (các) câu trả lời cần chấm, tiêu chí chấm điểm, và đôi khi có thêm một "câu trả lời mẫu" để AI giám khảo đối chiếu.
- AI giám khảo trả về kết quả có cấu trúc: một điểm số, hoặc một lựa chọn "câu A thắng / câu B thắng / hòa", kèm theo lý do ngắn gọn.
- Gộp kết quả hàng nghìn lần chấm thành một con số tổng, đó chính là thứ xuất hiện trên các bảng xếp hạng.
Cách làm này được dùng rộng rãi từ khi nghiên cứu "Judging LLM-as-a-Judge với MT-Bench và Chatbot Arena" công bố năm 2023, cho thấy khi dùng một model mạnh (như GPT-4 khi đó) làm giám khảo, kết quả chấm của nó khớp với con người ở mức trên 80%, gần bằng mức hai người chấm khớp nhau. Nhờ vậy, nhiều bộ công cụ đánh giá AI (và cả hệ thống xếp hạng kiểu Chatbot Arena cho người dùng bình chọn) đều có một phần dùng AI chấm điểm để xử lý khối lượng câu trả lời khổng lồ mà con người không chấm xuể.
 Điều này có ý nghĩa gì với bạn
Bạn không cần tự dựng một hệ thống LLM-as-judge mới dùng được ngay những gì nó mang lại:
- Đọc tin "model X vượt model Y Z điểm" một cách tỉnh táo hơn: hỏi thử xem con số đó đến từ con người chấm hay từ một AI khác chấm, và tiêu chí chấm là gì. Một AI giám khảo khác tiêu chí có thể cho ra thứ hạng khác hẳn.
- Tự làm một "giám khảo mini" cho công việc của mình: nếu bạn hay nhờ AI viết nhiều phiên bản cho cùng một việc (ví dụ 5 kịch bản quảng cáo), bạn có thể nhờ chính AI đó (hoặc một AI khác) chấm điểm 5 bản theo tiêu chí bạn đặt ra, ví dụ "ngắn gọn, có lời kêu gọi hành động rõ, giọng vui vẻ", trước khi tự đọc lại bản được chấm cao nhất. Prompt mẫu: "Chấm điểm 5 kịch bản dưới đây theo thang 1 đến 10 dựa trên 3 tiêu chí: ngắn gọn, có lời kêu gọi hành động, giọng vui vẻ. Giải thích ngắn gọn vì sao."
- Hiểu vì sao hai bảng xếp hạng cho kết quả khác nhau: bảng dùng giám khảo là GPT, bảng dùng giám khảo là Claude, mỗi bên có thể hơi thiên vị phong cách trả lời giống chính mình, nên đừng coi một bảng xếp hạng là chân lý tuyệt đối.
 Hiểu lầm thường gặp
- "AI giám khảo luôn công bằng và khách quan hơn con người." Không hẳn. Nghiên cứu cho thấy AI giám khảo có xu hướng mắc vài lỗi hệ thống: thiên vị câu trả lời dài hơn (verbosity bias), thiên vị vị trí (nếu đổi chỗ câu A và câu B thì kết quả chấm có thể đổi theo), và đặc biệt là thiên vị chính mình (self-enhancement bias), tức model có xu hướng chấm cao hơn cho câu trả lời viết theo phong cách giống nó.
- "LLM-as-judge thay thế hoàn toàn con người." Trong thực tế nó thường được dùng song song: AI chấm nhanh một lượng lớn để lọc ra các trường hợp đáng chú ý, rồi con người kiểm tra lại mẫu nhỏ để xác nhận AI chấm có đúng không. Đây cũng là một cách kiểm chứng câu trả lời của AI chứ không phải bỏ qua bước kiểm tra của con người.
- "Chấm điểm cao nghĩa là câu trả lời chắc chắn đúng." AI giám khảo chấm theo tiêu chí được viết ra, không tự kiểm tra sự thật ngoài đời. Một câu trả lời trình bày mạch lạc, tự tin nhưng có thông tin bịa (giống hiện tượng AI ảo giác đã nói ở bài trước) vẫn có thể được chấm điểm cao nếu tiêu chí không yêu cầu kiểm tra sự thật.
 Câu hỏi thường gặp
LLM-as-judge khác gì với benchmark thông thường? Benchmark là bộ câu hỏi và đáp án cố định, dễ chấm đúng/sai bằng máy (ví dụ bài toán có đáp số rõ ràng). LLM-as-judge dùng cho những câu hỏi mở không có một đáp án duy nhất, ví dụ viết văn, tư vấn, trò chuyện, nơi cần đánh giá "hay hay dở" chứ không chỉ "đúng hay sai".
AI giám khảo có cần mạnh hơn AI được chấm không? Thường là có, vì giám khảo cần đủ khả năng hiểu và phân tích câu trả lời phức tạp. Trong nhiều nghiên cứu, người ta dùng model mạnh nhất hiện có làm giám khảo cho tất cả các model khác, kể cả những model yếu hơn nó.
Tôi có thể tự dùng cách này để chấm bài của học sinh hay công việc của nhân viên không? Về mặt kỹ thuật thì làm được, nhưng cần cẩn trọng: AI giám khảo có thể thiên vị bài viết dài hoặc phong cách quen thuộc với nó, nên chỉ nên dùng để lọc sơ bộ hoặc gợi ý, quyết định cuối cùng vẫn nên có người xem lại, nhất là với việc ảnh hưởng đến điểm số hay đánh giá công việc thật.
Vì sao các công ty AI không chỉ dùng điểm benchmark cố định mà phải cần LLM-as-judge? Vì rất nhiều khả năng của AI hiện đại (trò chuyện tự nhiên, viết sáng tạo, trả lời câu hỏi mở) không có đáp án "đúng duy nhất" để máy so khớp tự động, nên cần một AI đọc hiểu để đánh giá chất lượng tổng thể, gần giống cách con người đọc và nhận xét.
LLM-as-judge có liên quan gì đến RLHF không? Có liên quan nhưng là hai việc khác nhau. RLHF là bước huấn luyện model dựa trên phản hồi (ban đầu chủ yếu từ con người, sau này có thêm từ AI) để model học cách trả lời tốt hơn. LLM-as-judge là công cụ đánh giá, dùng để đo xem một model đã trả lời tốt đến đâu, có thể dùng độc lập hoặc dùng làm một phần của quá trình huấn luyện đó.
Nếu bạn mới bắt đầu tìm hiểu AI từ con số 0, bài AI là gì, giải thích dễ hiểu cho người mới là điểm xuất phát tốt trước khi quay lại đọc sâu hơn về cách người ta đánh giá chất lượng AI như bài này.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 Dữ liệu tổng hợp (synthetic data) là gì? AI có thể tự tạo dữ liệu để dạy chính nó không