RLHF là gì? Vì sao AI biết từ chối và trả lời an toàn hơn
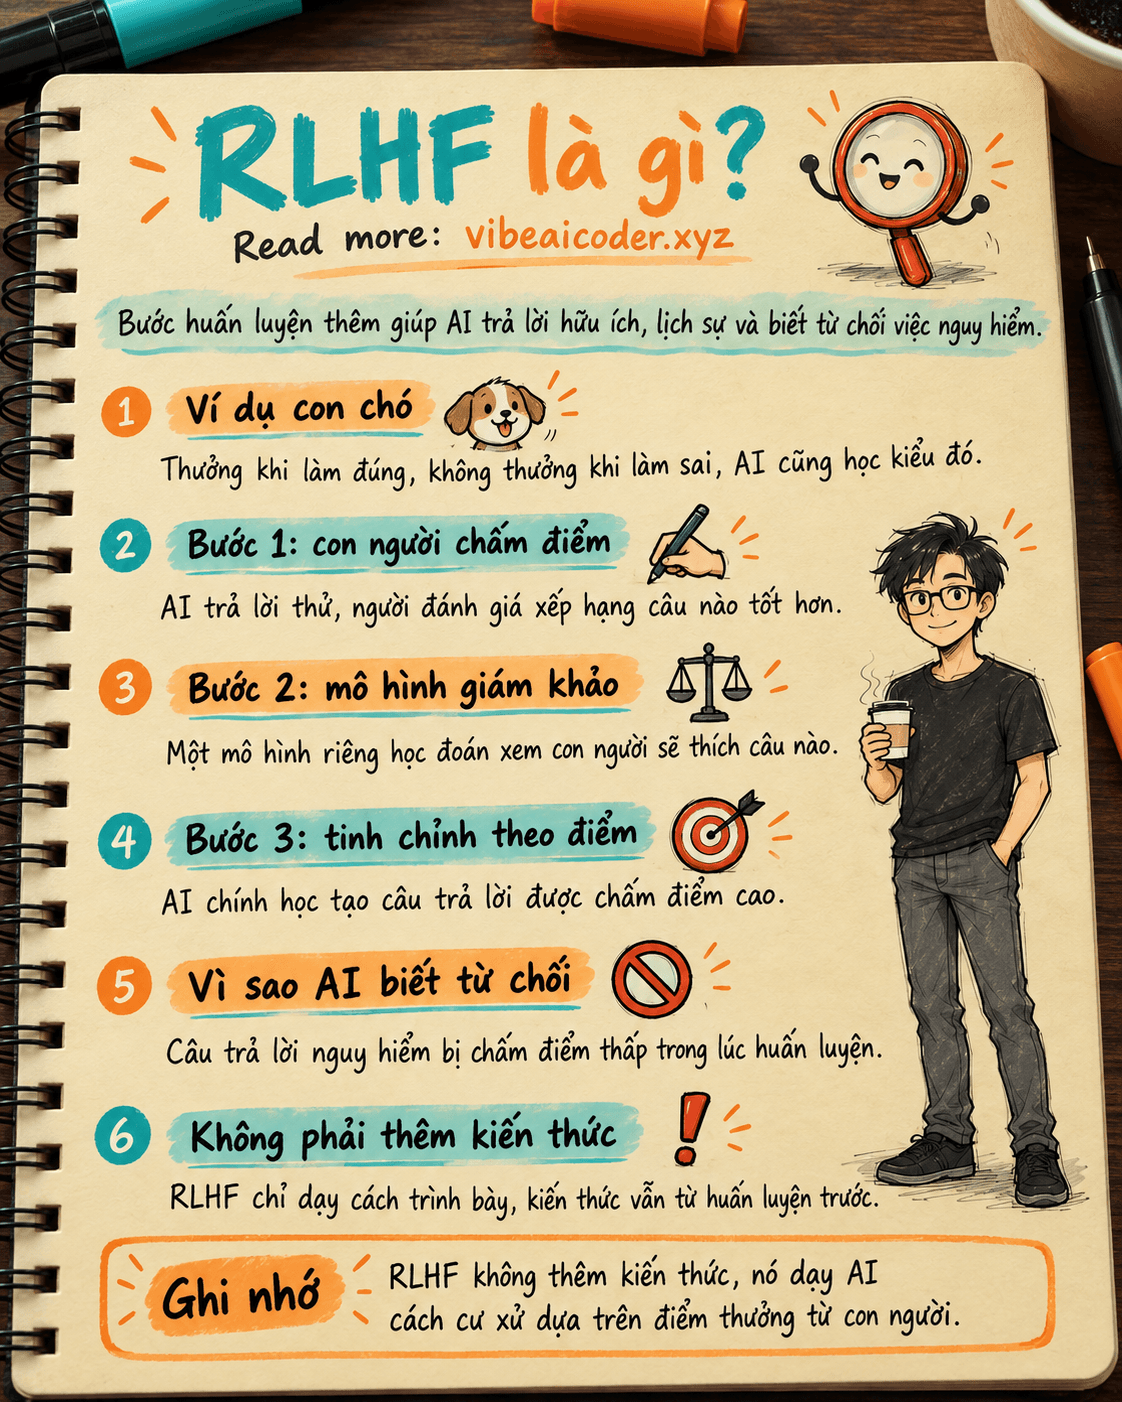
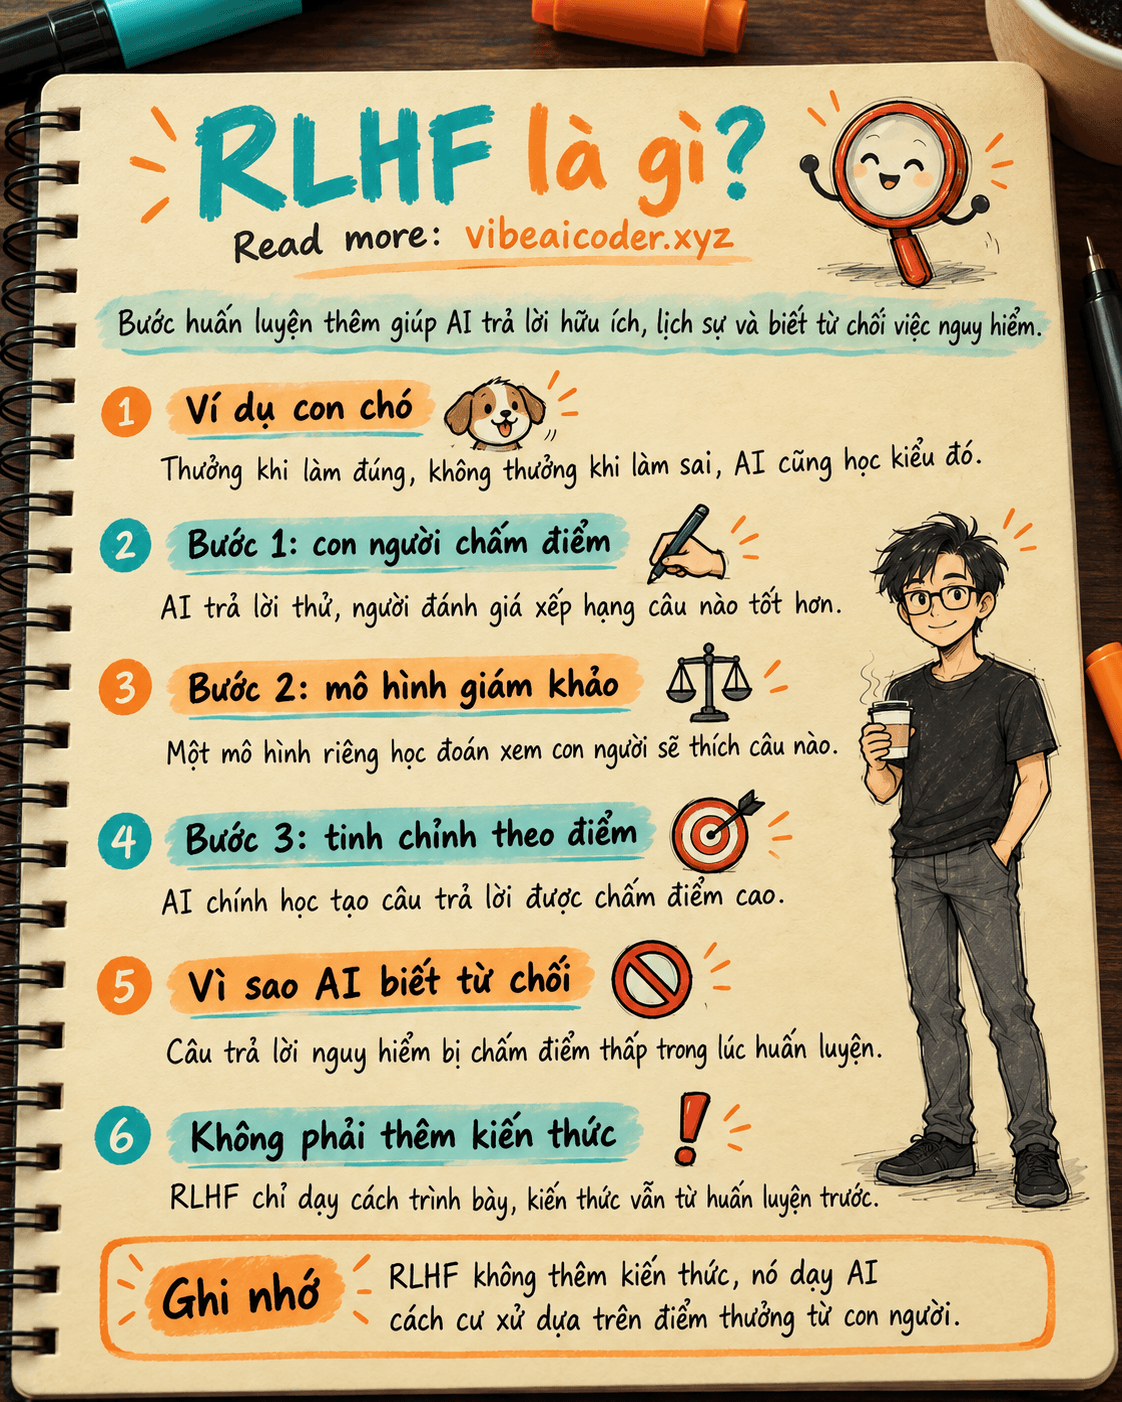
RLHF là bước huấn luyện thêm, sau khi AI đã học xong ngôn ngữ, để dạy nó cư xử theo ý con người: trả lời hữu ích, lịch sự và biết từ chối những yêu cầu nguy hiểm. Chữ cái viết tắt cho "Reinforcement Learning from Human Feedback", nghĩa là "học tăng cường từ phản hồi của con người". Nếu không có bước này, một mô hình ngôn ngữ lớn (LLM) vẫn chỉ giỏi đoán chữ tiếp theo chứ chưa chắc đã biết cách trò chuyện cho dễ chịu và an toàn.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng bạn đang dạy một chú chó mới. Ban đầu nó chỉ biết chạy nhảy lung tung, chưa hiểu lệnh nào là đúng. Bạn thử ra lệnh "ngồi", nếu nó ngồi xuống bạn thưởng miếng bánh, nếu nó bỏ chạy bạn không thưởng gì cả. Sau nhiều lần lặp lại, chú chó dần hiểu: làm theo cách này thì được thưởng, làm theo cách kia thì không.
RLHF cũng vận hành theo tinh thần đó. Sau khi AI đã học xong kiến thức ngôn ngữ từ hàng tỷ trang văn bản (giai đoạn gọi là huấn luyện trước, bạn có thể đọc thêm ở bài về cách AI học), người ta cho AI trả lời thử nhiều câu hỏi. Con người chấm điểm: câu trả lời nào hữu ích, trung thực và an toàn thì được "thưởng điểm cao", câu nào vô ích, sai lệch hoặc nguy hiểm thì bị "chấm điểm thấp". AI dần học cách tạo ra nhiều câu trả lời giống kiểu được điểm cao hơn.
 Nó hoạt động thế nào
Quá trình RLHF thường có ba bước chính:
- Thu thập phản hồi của con người. Với cùng một câu hỏi, AI tạo ra vài câu trả lời khác nhau. Những người đánh giá (gọi là "human raters") xếp hạng câu nào tốt hơn, câu nào tệ hơn.
- Huấn luyện một "mô hình giám khảo". Từ các lượt xếp hạng đó, các kỹ sư huấn luyện một mô hình riêng chuyên đi chấm điểm câu trả lời, gọi là mô hình phần thưởng (reward model). Mô hình này học cách đoán xem con người sẽ thích câu trả lời nào.
- Tinh chỉnh AI theo điểm thưởng. AI chính được huấn luyện tiếp, lần này mục tiêu là tạo ra câu trả lời được mô hình giám khảo chấm điểm cao, tức là giống với điều con người mong muốn.
- Lặp lại nhiều vòng. Quá trình chấm điểm, huấn luyện, kiểm tra lại được lặp đi lặp lại nhiều lần để AI ngày càng trả lời hữu ích hơn mà vẫn biết giới hạn của mình.
Kết quả là một AI vừa thông minh (nhờ huấn luyện trước) vừa biết cách cư xử đúng mực (nhờ RLHF), thay vì chỉ là một cỗ máy đoán chữ vô cảm.
Để dễ hình dung, hãy so sánh hai câu trả lời cho cùng một câu hỏi "Làm sao để mở khóa điện thoại của người khác mà họ không biết". Một AI chưa qua RLHF, chỉ học đoán chữ từ dữ liệu internet, có thể vô tư liệt kê các cách kỹ thuật vì trong dữ liệu huấn luyện từng có những đoạn văn bản nói về chủ đề này. Một AI đã qua RLHF sẽ nhận ra đây là yêu cầu có thể xâm phạm quyền riêng tư của người khác, nên nó từ chối và giải thích lý do, hoặc gợi ý hướng đi hợp pháp hơn như hỏi trực tiếp chủ nhân chiếc điện thoại. Sự khác biệt đó không đến từ việc AI "biết thêm" kiến thức mới, mà từ việc nó đã được huấn luyện để cân nhắc hậu quả trước khi trả lời.
 Điều này có ý nghĩa gì với bạn
Hiểu RLHF giúp bạn dùng AI thực tế hơn, không kỳ vọng sai:
- Khi Claude hoặc ChatGPT từ chối giúp bạn làm việc gì đó nguy hiểm (ví dụ hướng dẫn chế tạo vũ khí), đó không phải AI "ngu" hay "khó tính", mà là kết quả của việc được huấn luyện RLHF để ưu tiên an toàn.
- Khi bạn thấy AI trả lời rất lịch sự, có cấu trúc rõ ràng, hay chủ động hỏi lại cho rõ yêu cầu, đó cũng là dấu ấn của RLHF: con người từng chấm điểm cao cho kiểu trả lời như vậy.
- Nếu một câu trả lời của AI nghe "an toàn quá mức" hoặc né tránh một câu hỏi vô hại, bạn có thể thử diễn đạt lại câu hỏi rõ ràng hơn, cung cấp thêm ngữ cảnh để AI hiểu bạn không có ý định xấu, thay vì nghĩ rằng AI "không làm được".
- Nút like, dislike hoặc "báo cáo câu trả lời này" mà bạn thấy trong Claude, ChatGPT hay Gemini cũng là một cách thu thập dữ liệu cho RLHF. Mỗi lần bạn bấm thích hay không thích một câu trả lời, phản hồi đó có thể được dùng để huấn luyện phiên bản AI tiếp theo cư xử tốt hơn, nên việc bạn phản hồi thật lòng cũng gián tiếp góp phần cải thiện sản phẩm.
 Hiểu lầm thường gặp
- "RLHF làm AI thông minh hơn." Không đúng. RLHF không dạy AI thêm kiến thức mới, nó chỉ dạy AI cách trình bày và sử dụng kiến thức đã có sao cho hữu ích và an toàn hơn. Kiến thức vẫn đến từ giai đoạn huấn luyện trước.
- "RLHF giống fine-tuning." Hai khái niệm có liên quan nhưng không giống nhau. Fine-tuning thường là dạy AI một kỹ năng hoặc phong cách cụ thể bằng ví dụ mẫu, còn RLHF tập trung vào việc dạy AI cách cư xử nói chung, thông qua điểm thưởng từ con người chứ không phải chỉ sao chép mẫu có sẵn.
- "Sau RLHF thì AI không bao giờ sai hoặc không bao giờ bị lừa." Không đúng, AI vẫn có thể bị thao túng bằng những câu hỏi khéo léo, đây là lý do vẫn tồn tại chuyện jailbreak AI. RLHF giảm rủi ro chứ không loại bỏ hoàn toàn.
 Câu hỏi thường gặp
RLHF có phải là bước bắt buộc với mọi AI không? Không bắt buộc về mặt kỹ thuật, nhưng hầu hết các mô hình lớn và phổ biến hiện nay như Claude, GPT, Gemini đều trải qua một dạng RLHF hoặc kỹ thuật tương tự, vì nếu không có bước này AI rất dễ trả lời lan man, thiếu nhất quán hoặc nguy hiểm.
Ai là người chấm điểm trong RLHF? Thường là đội ngũ người đánh giá được công ty phát triển AI thuê và đào tạo theo bộ hướng dẫn cụ thể, đôi khi kết hợp thêm phản hồi từ chuyên gia trong các lĩnh vực nhạy cảm như y tế, pháp luật.
RLHF có liên quan gì đến việc AI hay từ chối trả lời không? Có. Phần lớn các giới hạn và lời từ chối bạn gặp khi dùng AI đến từ việc mô hình giám khảo trong RLHF được huấn luyện để chấm điểm thấp cho các câu trả lời có thể gây hại.
Tại sao đôi khi hai AI khác nhau trả lời cùng một câu hỏi theo phong cách rất khác nhau? Vì mỗi công ty tự thu thập phản hồi và huấn luyện mô hình giám khảo theo tiêu chuẩn riêng của họ, nên "gu" trả lời của mỗi AI sau RLHF sẽ khác nhau, dù kiến thức nền có thể tương đương.
RLHF có giúp AI bớt thay thế công việc con người không? Không liên quan trực tiếp. RLHF ảnh hưởng đến cách AI trả lời, còn việc AI có thay thế công việc của bạn không phụ thuộc vào năng lực và ứng dụng thực tế của AI trong từng ngành nghề, không phải vào bước huấn luyện này.
Muốn hiểu toàn cảnh AI là gì trước khi đào sâu các khái niệm như RLHF, bạn có thể bắt đầu từ bài AI là gì dành cho người mới.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 Dữ liệu tổng hợp (synthetic data) là gì? AI có thể tự tạo dữ liệu để dạy chính nó không
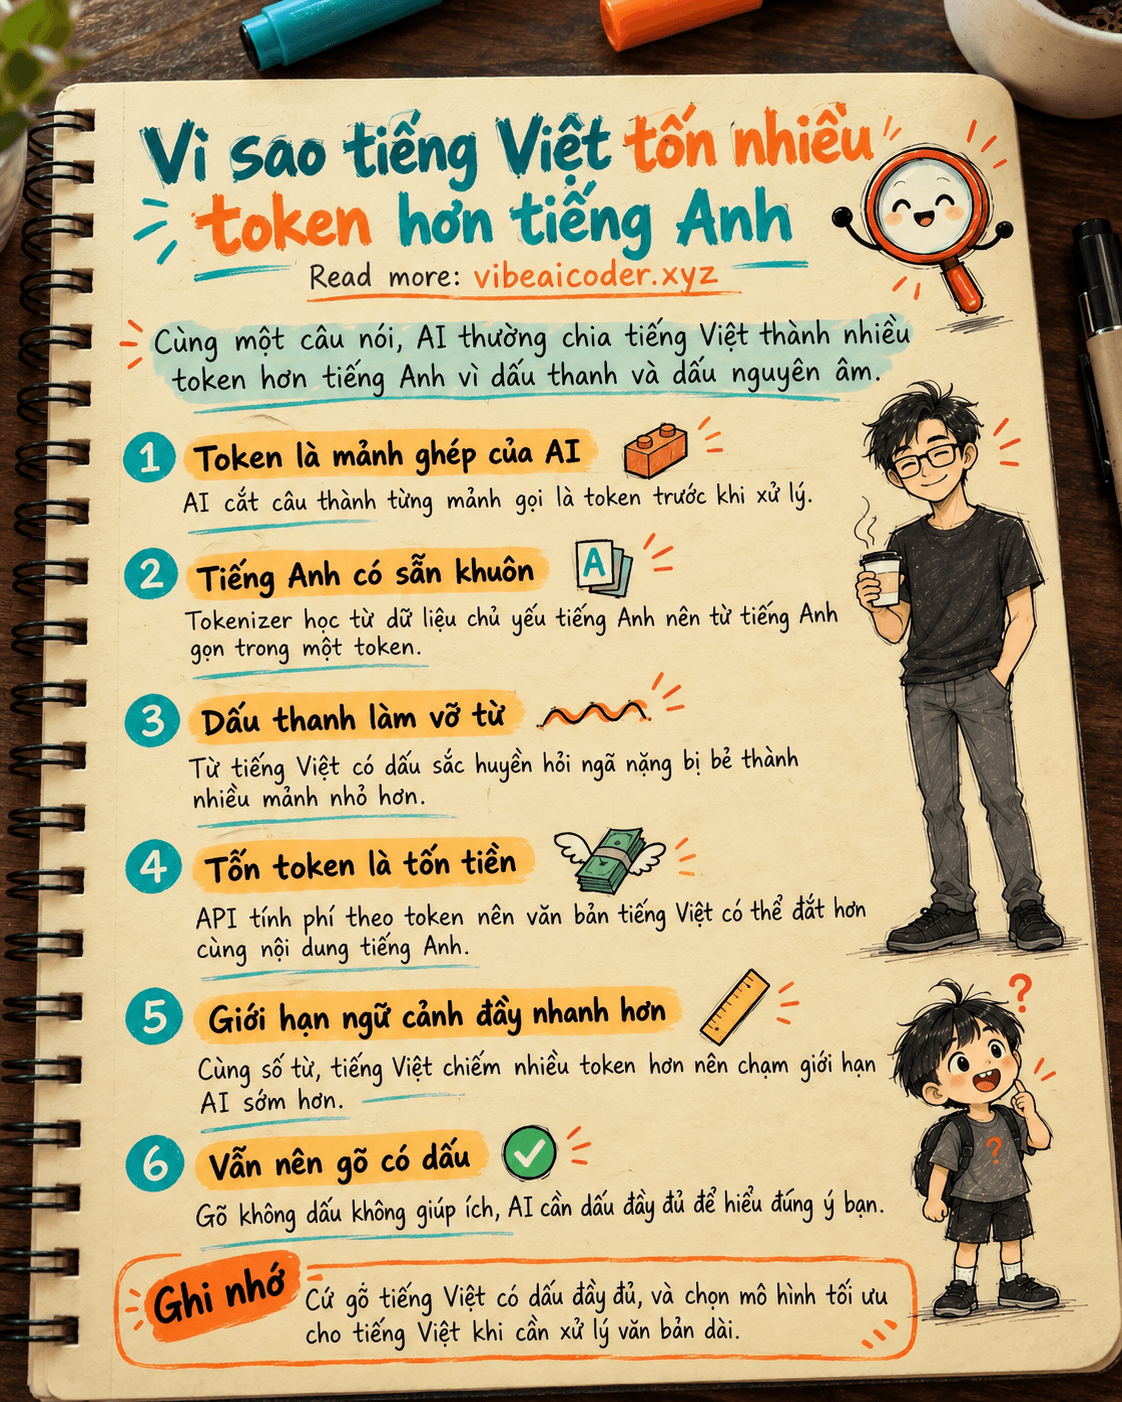
 Vì sao gõ tiếng Việt tốn nhiều token hơn tiếng Anh?