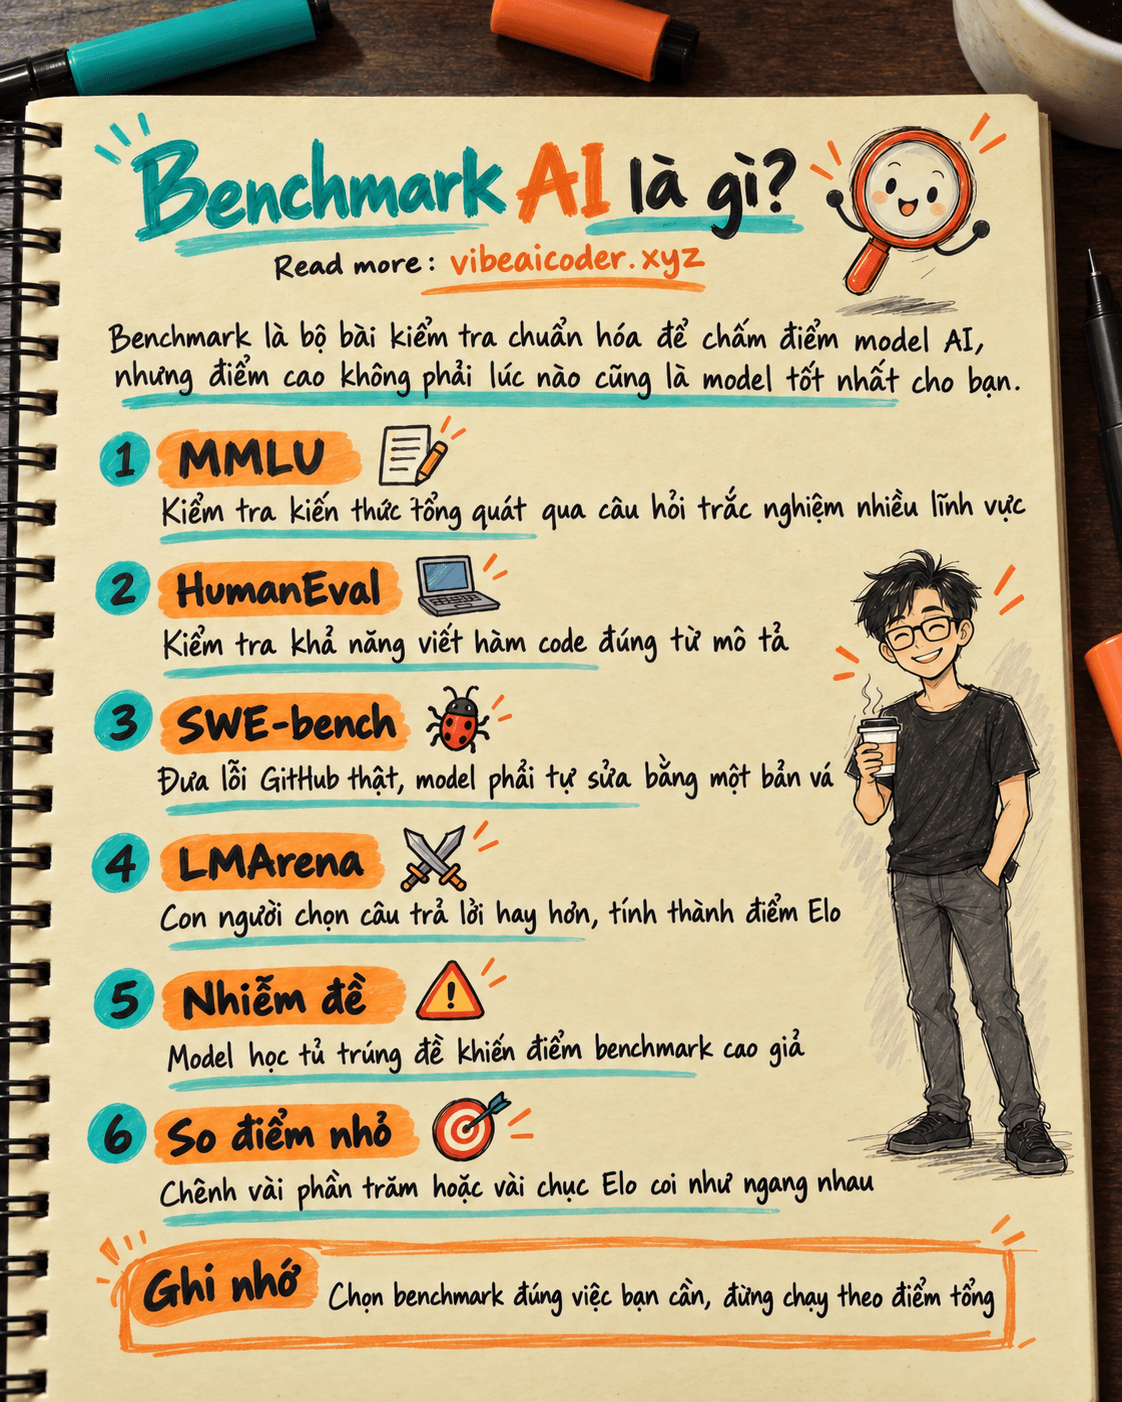
Benchmark AI là gì? Đọc bảng xếp hạng model sao cho đúng
 Benchmark AI là gì? Đọc bảng xếp hạng model sao cho đúng
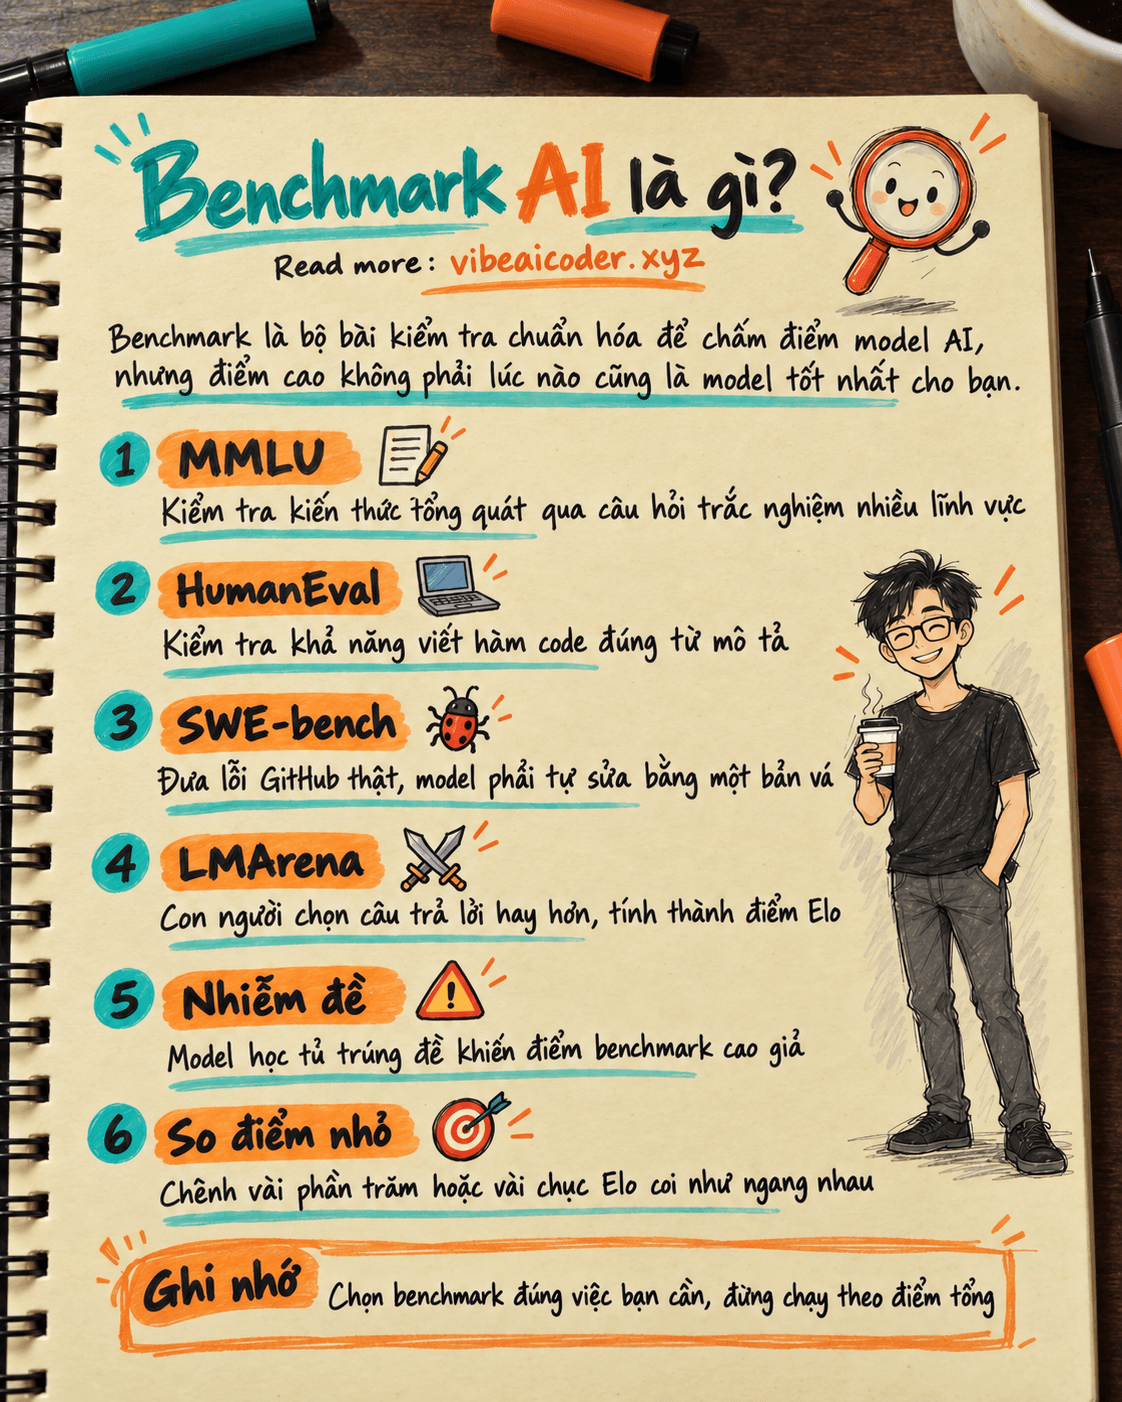
Benchmark AI là một bộ bài kiểm tra chuẩn hóa, dùng để chấm điểm xem một model AI giỏi đến đâu ở một việc cụ thể, ví dụ giải toán, viết code hay trả lời kiến thức tổng quát. Mỗi khi có model mới ra mắt, nhà sản xuất thường khoe vài con số benchmark, và các trang xếp hạng độc lập cũng công bố bảng điểm riêng. Vấn đề là con số đó dễ bị đọc sai nếu bạn không biết nó đo cái gì và đo bằng cách nào.
 Hiểu nhanh bằng ví dụ đời thường
Hãy nghĩ benchmark AI giống như một kỳ thi chuẩn hóa, kiểu kỳ thi THPT Quốc Gia hoặc IELTS. Đề thi cố định, có đáp án đúng sẵn, và mọi "thí sinh" (ở đây là các model AI) đều làm cùng một bộ đề. Ai trả lời đúng nhiều câu hơn thì điểm cao hơn.
Nhưng cũng giống thi cử ngoài đời, điểm IELTS 8.0 không có nghĩa là người đó sẽ thuyết trình hay trong một cuộc họp thực tế, và điểm thi đại học cao không chắc làm việc nhóm giỏi. Benchmark AI cũng vậy: nó đo rất tốt một kỹ năng hẹp, nhưng không chắc phản ánh đúng việc model có hữu ích cho công việc hàng ngày của bạn hay không.
 Nó hoạt động thế nào
Có hai kiểu benchmark phổ biến, và chúng hoạt động khá khác nhau.
- Bộ đề có đáp án đúng, chấm tự động. Đây là kiểu benchmark truyền thống. Ví dụ MMLU đưa ra hàng nghìn câu hỏi trắc nghiệm thuộc 57 lĩnh vực như y học, luật, toán, lịch sử, rồi tính phần trăm câu model trả lời đúng. HumanEval đưa cho model một đoạn mô tả hàm Python, yêu cầu viết code, sau đó chạy code đó qua một loạt bài kiểm thử ẩn để xem có chạy đúng không.
- Bộ đề sát với công việc thật, cũng chấm tự động nhưng khó hơn. SWE-bench lấy nguyên các lỗi (issue) thật trên GitHub, đưa cho model cả kho mã nguồn, yêu cầu model tự sửa lỗi bằng một bản vá (patch), rồi chạy bộ kiểm thử của chính dự án đó để xem lỗi đã hết chưa. Vì đề lấy từ dự án thật, benchmark này khó "học tủ" hơn so với bộ câu hỏi trắc nghiệm.
- Chấm bằng con người, không có đáp án cố định. LMArena (trước đây gọi là Chatbot Arena) hoạt động khác hẳn: người dùng gõ một câu hỏi, nhận về hai câu trả lời từ hai model giấu tên, rồi chọn câu nào hay hơn. Mỗi lượt chọn được tính vào một hệ thống điểm Elo, giống hệ thống xếp hạng trong cờ vua. Model thắng nhiều sẽ có điểm Elo cao hơn.
- Điểm số được gom vào bảng xếp hạng (leaderboard). Các trang như LMArena hay llm-stats.com tổng hợp điểm của nhiều model trên nhiều benchmark, xếp theo thứ hạng để người đọc dễ so sánh.
- Khoảng cách điểm nhỏ gần như không có ý nghĩa. Vì mỗi benchmark đều có sai số, hai model chênh nhau vài phần trăm hoặc vài chục điểm Elo nên được coi là ngang nhau trên thực tế, không phải model xếp trên chắc chắn giỏi hơn.
 Điều này có ý nghĩa gì với bạn
Bạn không cần tự chạy benchmark, nhưng biết đọc nó giúp bạn chọn công cụ đúng việc thay vì chạy theo quảng cáo.
- Chọn model theo đúng việc bạn cần, không chọn theo điểm tổng. Nếu bạn cần AI hỗ trợ viết code, hãy tìm điểm HumanEval hoặc SWE-bench của model đó, đừng nhìn điểm MMLU vì đó là bài kiểm tra kiến thức tổng quát, không phải khả năng viết code.
- Khi hai model chênh nhau không nhiều, chọn theo trải nghiệm thật. Ví dụ hai model chênh nhau 2 đến 3 điểm Elo trên LMArena, cứ dùng thử cả hai với công việc thật của bạn trong vài ngày rồi quyết định, thay vì tin tuyệt đối vào bảng xếp hạng. Cách so sánh thực tế này cũng là cách bài viết so sánh Claude Sonnet 5.5 và GPT-6.1 Sol từng dùng để đưa ra lời khuyên.
- Đọc kỹ tên phiên bản benchmark. HumanEval và HumanEval+ cho ra điểm khác nhau vì HumanEval+ có thêm bài kiểm thử khó hơn để chống việc model "học tủ". SWE-bench và SWE-bench Verified cũng khác nhau, bản Verified chỉ gồm 500 bài đã được lọc kỹ để chắc chắn có lời giải rõ ràng. Một model công bố điểm SWE-bench thường (chưa lọc) thường thấp hơn điểm SWE-bench Verified của chính nó.
 Hiểu lầm thường gặp
- "Điểm benchmark cao nhất là model tốt nhất." Không hẳn. Một model có thể đạt điểm cao trên benchmark vì đã từng "thấy" đề thi đó hoặc đề tương tự trong lúc huấn luyện, giống học sinh học tủ trúng đề. Hiện tượng này gọi là nhiễm đề (contamination), và nó khiến điểm số không phản ánh đúng khả năng thật của model.
- "Benchmark nào cũng đo cùng một thứ." Sai. MMLU đo kiến thức, HumanEval đo khả năng viết code từ đầu, SWE-bench đo khả năng sửa lỗi trong một dự án có sẵn, còn LMArena đo việc con người thích câu trả lời nào hơn. Bốn benchmark này có thể xếp hạng bốn model theo bốn thứ tự khác nhau, vì chúng đang hỏi bốn câu hỏi khác nhau.
- "Model xếp hạng 1 chắc chắn là lựa chọn đúng cho tôi." Bảng xếp hạng phản ánh trung bình trên hàng nghìn câu hỏi đa dạng, trong khi công việc hàng ngày của bạn thường chỉ liên quan đến một nhóm việc hẹp, ví dụ viết email, phân tích Excel hay tóm tắt tài liệu. Model đứng hạng ba hoàn toàn có thể làm tốt hơn model hạng một với đúng loại việc bạn cần, nhất là khi bạn còn phải cân nhắc đến giá cả và tốc độ phản hồi, như bài viết về chế độ suy luận của AI từng nói đến việc model mạnh hơn không phải lúc nào cũng là lựa chọn hợp lý.
 Câu hỏi thường gặp
Benchmark AI có đáng tin không? Đáng tin ở mức tương đối, miễn là bạn hiểu benchmark đó đo đúng khả năng bạn quan tâm và không coi chênh lệch nhỏ là khác biệt lớn. Nên xem benchmark như một gợi ý ban đầu để thu hẹp danh sách, không phải lời giải cuối cùng.
Vì sao các công ty AI hay khoe điểm benchmark khác nhau cho cùng một model? Vì mỗi lần đo có thể dùng phiên bản benchmark khác nhau, cách đặt câu hỏi (prompt) khác nhau, hoặc chỉ công bố benchmark mà model của họ đạt điểm cao. Khi so sánh, tốt nhất nên tìm bảng xếp hạng độc lập, không do chính hãng công bố.
MMLU, HumanEval, SWE-bench và LMArena khác nhau ở điểm nào? MMLU kiểm tra kiến thức tổng quát qua câu hỏi trắc nghiệm. HumanEval kiểm tra khả năng viết hàm code từ mô tả. SWE-bench kiểm tra khả năng sửa lỗi thật trong dự án phần mềm có sẵn. LMArena đo sở thích của người dùng thật qua các lượt so sánh trực tiếp giữa hai model. Bốn thứ này đo bốn kỹ năng khác nhau nên không nên gộp chung thành một con số duy nhất.
Model nguồn mở như Qwen có so sánh được với Claude hay GPT trên benchmark không? Có, các bảng xếp hạng thường đặt model nguồn mở và nguồn đóng cạnh nhau trên cùng benchmark để dễ so sánh. Nhưng điểm benchmark chỉ là một phần của câu chuyện, còn phải cân nhắc đến chi phí vận hành, tốc độ và khả năng tuỳ biến, giống cách bài viết về Qwen3.8 Max so với Claude Sonnet 5.5 đã phân tích.
Tôi là người dùng bình thường, có cần theo dõi benchmark không? Không bắt buộc. Nếu bạn chỉ dùng AI cho công việc hàng ngày, cách chọn model thực dụng nhất là thử trực tiếp với công việc của mình trong vài ngày. Benchmark hữu ích hơn khi bạn cần quyết định nhanh giữa nhiều model mới ra mắt mà chưa kịp dùng thử, hoặc muốn hiểu vì sao một mô hình ngôn ngữ lớn này được quảng cáo là "mạnh hơn" model khác.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ