LLM-as-judgeとは?AIに別のAIの回答を採点させる仕組み
 LLM-as-judgeとは?AIに別のAIの回答を採点させる仕組み
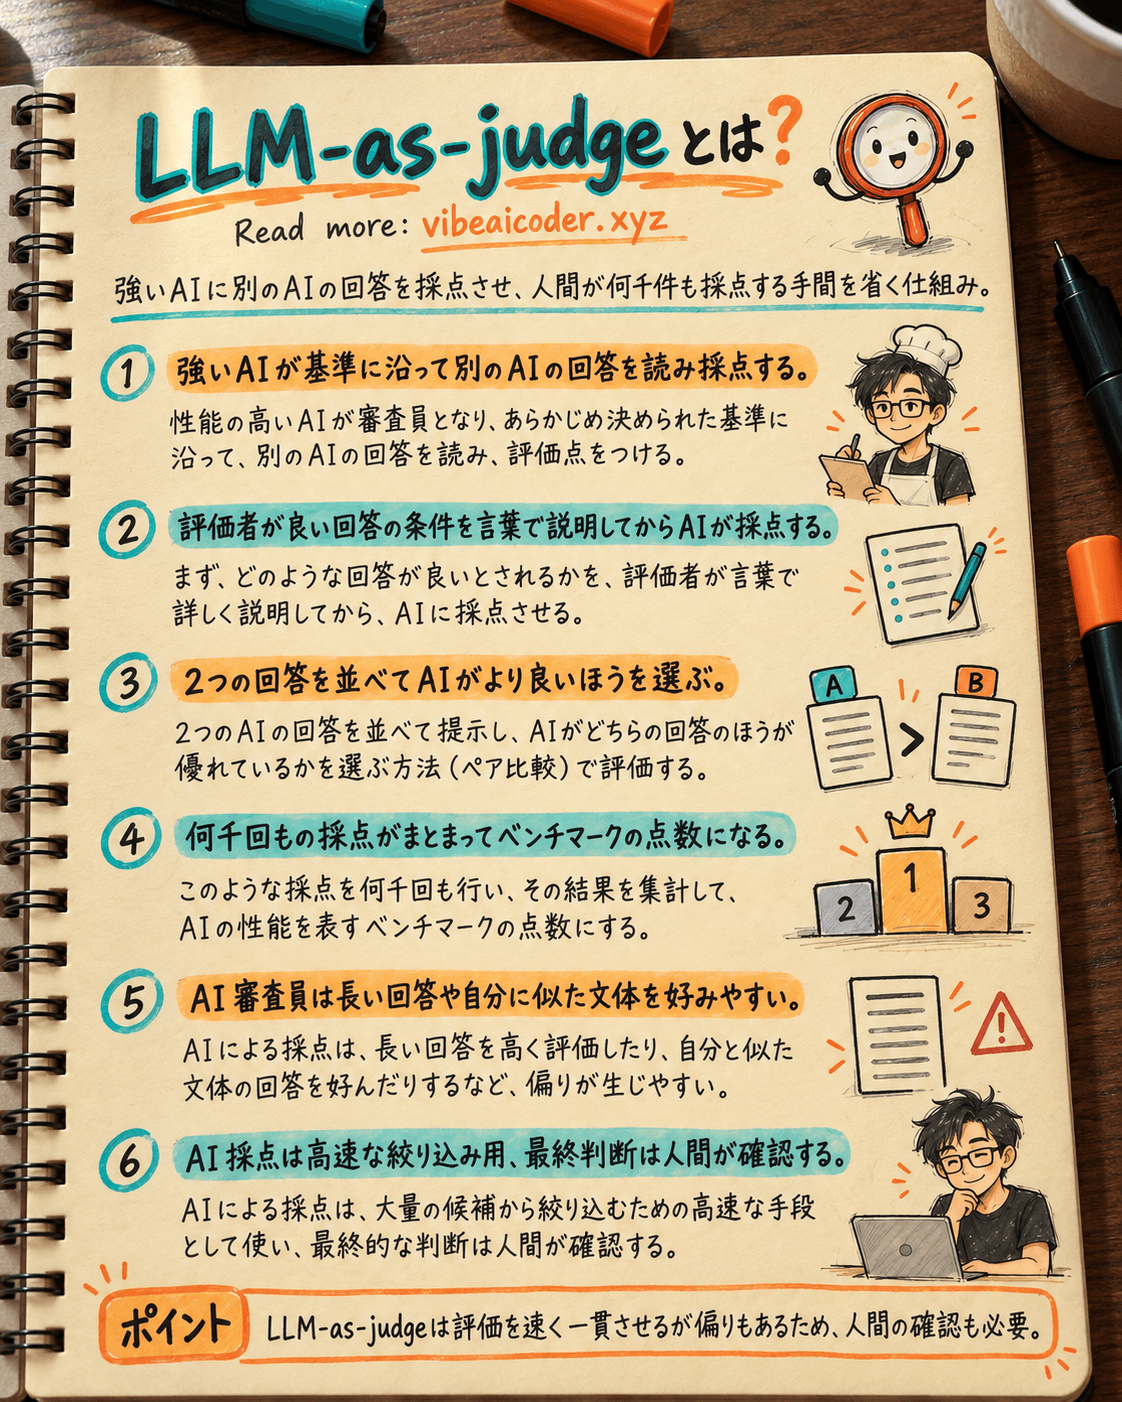
LLM-as-judge(AI審査員)とは、ある大規模言語モデルを使って、別のAI(あるいは自分自身)が作った回答を採点したり比較したりする方法です。人間がすべての回答を一つずつ読んで採点する代わりに使われます。AnthropicやOpenAI、Googleなどの企業が、新しいモデルが本当に旧モデルより優れているかを確認し、ベンチマークのランキングを発表する前に使う主要な手法です。この仕組みを理解すると、「モデルXはモデルYよりZ%優れている」といったニュースを、より冷静に読めるようになります。
 身近な例でざっくり理解する
1000人が参加する料理コンテストを想像してください。それぞれが1品ずつ料理を提出します。人間の審査員が1000品すべてを味見してコメントを書き、順位をつけるとしたら、膨大な時間とお金がかかりますし、審査員によって好みが違うため評価が割れることもあります。
AI企業がやっていることは、一人の優れたシェフを唯一の審査員として雇うことに近いですが、そのシェフは人間ではなくAI(たいてい現時点で最も強いモデル、例えばClaude OpusやGPT-4)です。この「AIシェフ」に採点基準(十分おいしいか、きちんと火が通っているか、レシピ通りか)を与えると、わずか数分で何千品もの料理を、毎回同じ基準に沿って一貫して採点してくれます。これがLLM-as-judgeの基本的な考え方です。あるAIが別のAIの回答を読み、あらかじめ決められた基準にもとづいて点数をつけたり、より良いほうを選んだりするのです。
 どのように動くのか
LLM-as-judgeの流れは、通常次のようなステップになります。
- 採点基準(ルーブリック)を書く:評価者が、どのような回答が良いとされるかを言葉で説明します。例えば「事実が正確で、質問に直接答えていて、冗長でなく、丁寧な口調であること」などです。
- 採点対象の質問と回答を用意する:1つのモデルの回答を1から10点で採点する場合もあれば、2つのモデルの回答を並べて、どちらが優れているかをAIに選ばせる場合(「ペア比較」と呼ばれます)もあります。
- すべてをAI審査員に送る:元の質問、採点対象の回答、採点基準、場合によっては参考回答を組み合わせたプロンプトを作成し、審査役のモデルに送ります。
- AI審査員が構造化された結果を返す:点数、または「回答Aの勝ち / 回答Bの勝ち / 引き分け」という選択を、簡単な理由とともに返します。
- 何千回もの採点結果をまとめることで、ランキングに表示される総合的な数値になります。
この手法は、2023年に発表された論文「Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena」で、強力なモデル(当時のGPT-4)を審査員として使うと、その判定が人間の評価と80%以上の割合で一致し、人間同士の一致率に近いことが示されたことから広く使われるようになりました。そのため、ユーザーが投票するChatbot Arenaのような評価システムを含め、多くの評価ツールが、人間ではとても手が回らない膨大な数の回答を処理するためにAI審査員を使っています。
 これはあなたにとってどういう意味があるのか
自分でLLM-as-judgeの仕組みを一から作らなくても、この考え方を活用できます。
- 「モデルXはモデルYよりZポイント優れている」というニュースをより批判的に読む:その数値が人間の採点によるものか、別のAIの採点によるものか、どんな基準が使われたのかを確認しましょう。審査役のAIや基準が変われば、順位がまったく変わることもあります。
- 自分の仕事のために「ミニ審査員」を作る:同じ作業についてAIに何パターンも書かせることが多いなら(例えば広告文を5パターン)、その同じAI(または別のAI)に、自分で決めた基準、例えば「簡潔で、明確な行動喚起があり、前向きなトーンであること」で5パターンを採点させてから、最も高得点のものを自分で読むことができます。プロンプト例:「以下の5つの文案を、簡潔さ、明確な行動喚起、前向きなトーンの3つの基準にもとづいて1から10点で採点してください。それぞれ簡単な理由も添えてください。」
- 2つのランキングが異なる理由を理解する:あるランキングはGPTを審査員に使い、別のランキングはClaudeを使っているとすると、それぞれの審査役は自分自身に似たスタイルの回答をわずかに好む可能性があるため、どちらか一方のランキングだけを絶対的な真実として扱うべきではありません。
 よくある誤解
- 「AI審査員は人間より常に客観的だ」:必ずしもそうではありません。研究によれば、AI審査員にはいくつかの系統的な偏りがあります。より長い回答を好む傾向(冗長性バイアス)、特定の位置にある回答を好む傾向(位置バイアス、AとBの順序を入れ替えると結果が変わることがある)、そして特に、自分自身のスタイルに似た回答を好む傾向(自己優遇バイアス)です。
- 「LLM-as-judgeは人間を完全に置き換える」:実際には、多くの場合人間と並行して使われています。AIが大量の回答を素早く採点して注目すべきケースを絞り込み、人間がその一部を抽出して確認するという形です。これはAIの回答を検証する一つの方法であり、人間によるチェックを省略するものではありません。
- 「高得点ならその回答は必ず正しい」:AI審査員はあらかじめ書かれた基準にもとづいて採点するのであって、現実世界の事実を独自に検証するわけではありません。自信たっぷりに書かれていても内容が作り話である回答は、前に紹介したAIの幻覚(ハルシネーション)と同じように、採点基準が事実確認を求めていなければ高得点になることがあります。
よくある質問
LLM-as-judgeは通常のベンチマークと何が違うのですか? ベンチマークは、明確な正解・不正解があり機械が自動で採点できる固定の問題セットです(答えが一つに決まる数学の問題など)。LLM-as-judgeは、唯一の正解がない自由回答形式の質問、例えば文章作成、アドバイス、会話などに使われ、「正しいか間違っているか」ではなく「どれだけ良いか」を判断する必要がある場合に使われます。
審査役のAIは採点対象のAIより強い必要がありますか? 通常はそうです。複雑な回答を理解し分析するには十分な能力が必要だからです。多くの研究では、当時最も強力なモデルを、それより弱いモデルも含めたすべてのモデルの審査役として使っています。
学生の課題や社員の成果物の採点に使えますか? 技術的には可能ですが、注意が必要です。AI審査員は、長い文章や自分になじみのある文体を好む傾向があるため、主に一次選考や提案として使うのが望ましいでしょう。成績や人事評価に影響する最終的な判断には、やはり人間の確認が必要です。
なぜAI企業は固定のベンチマークだけでなくLLM-as-judgeも必要とするのですか? 自然な会話、創造的な文章作成、自由回答形式の質問への回答など、現代AIの多くの能力には機械が自動で確認できる「唯一の正解」がないためです。そのため、人間が読んでコメントするのと同じように、全体的な質を判断できる、読解力のあるAIが必要とされています。
LLM-as-judgeはRLHFと関係がありますか? 関連はありますが、別のものです。RLHFは、フィードバック(当初は主に人間から、現在は一部AIからも)にもとづいてモデルがより良く答えられるように学習する、訓練の一段階です。LLM-as-judgeは評価のための手法であり、モデルの回答がすでにどれだけ優れているかを測るために使われ、単独でも、その訓練プロセスの一部としても利用できます。
AIについてゼロから学び始めたばかりの方は、まずAIとは何か、初心者向けのやさしい解説を読んでから、AIの質がどのように評価されるかを掘り下げたこの記事に戻ってくるとよいでしょう。
#AI #LLM #AI評価 #ベンチマーク #vibeaicoder
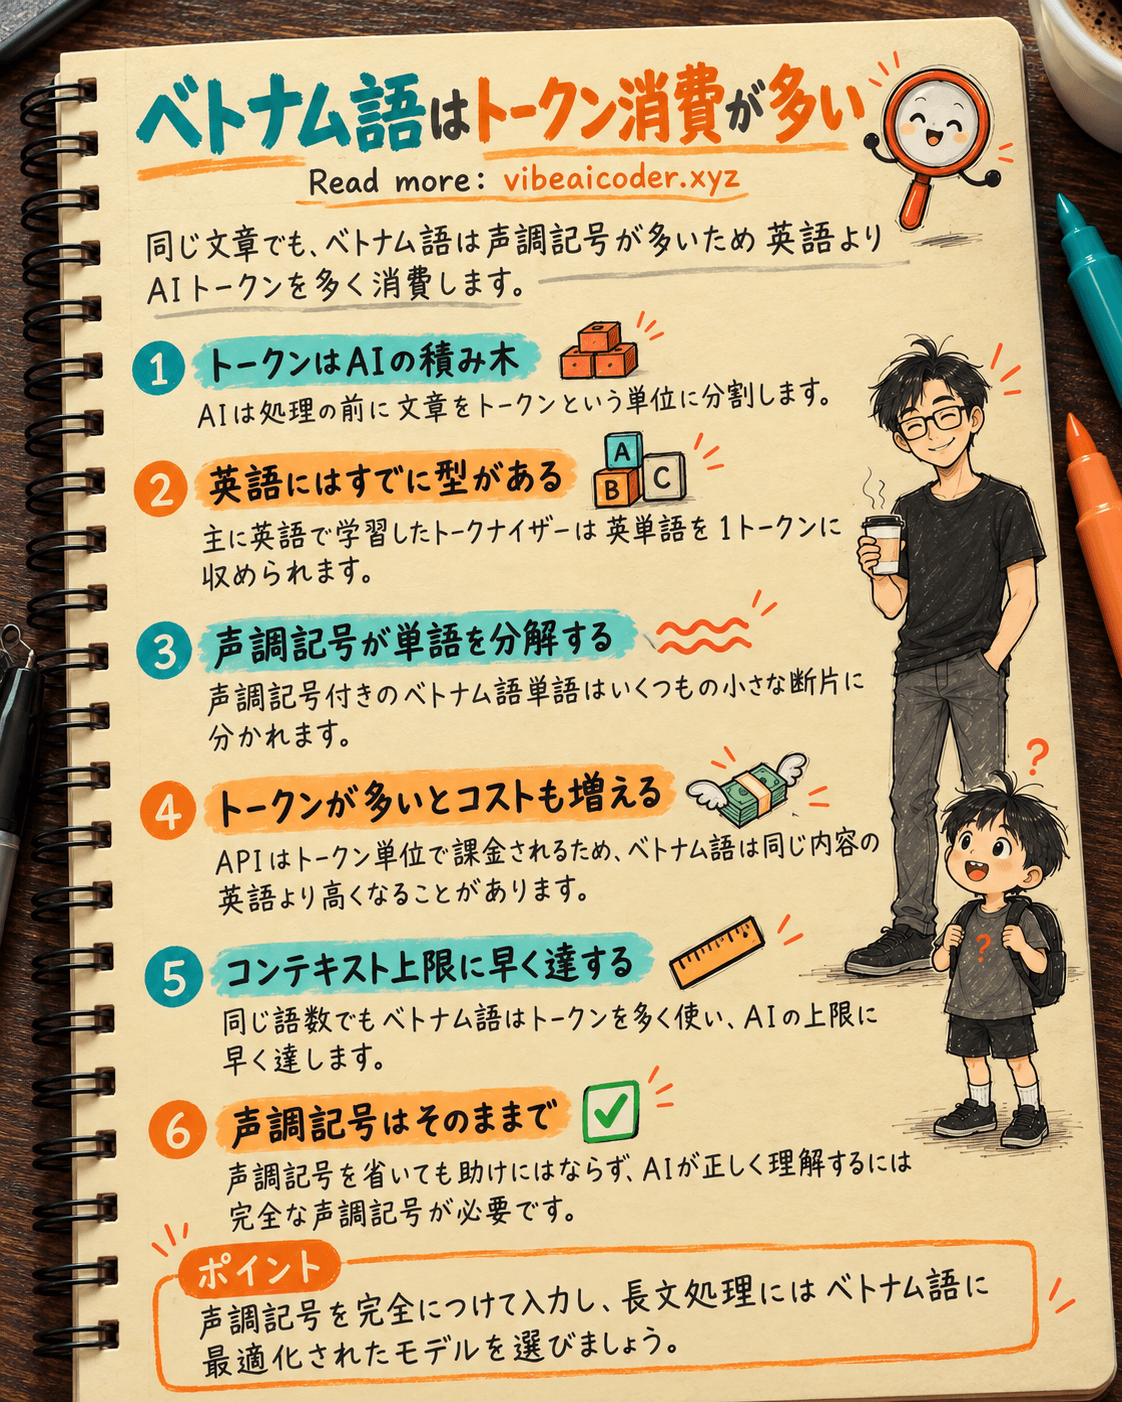
 なぜベトナム語は英語よりも多くのトークンを消費するのか
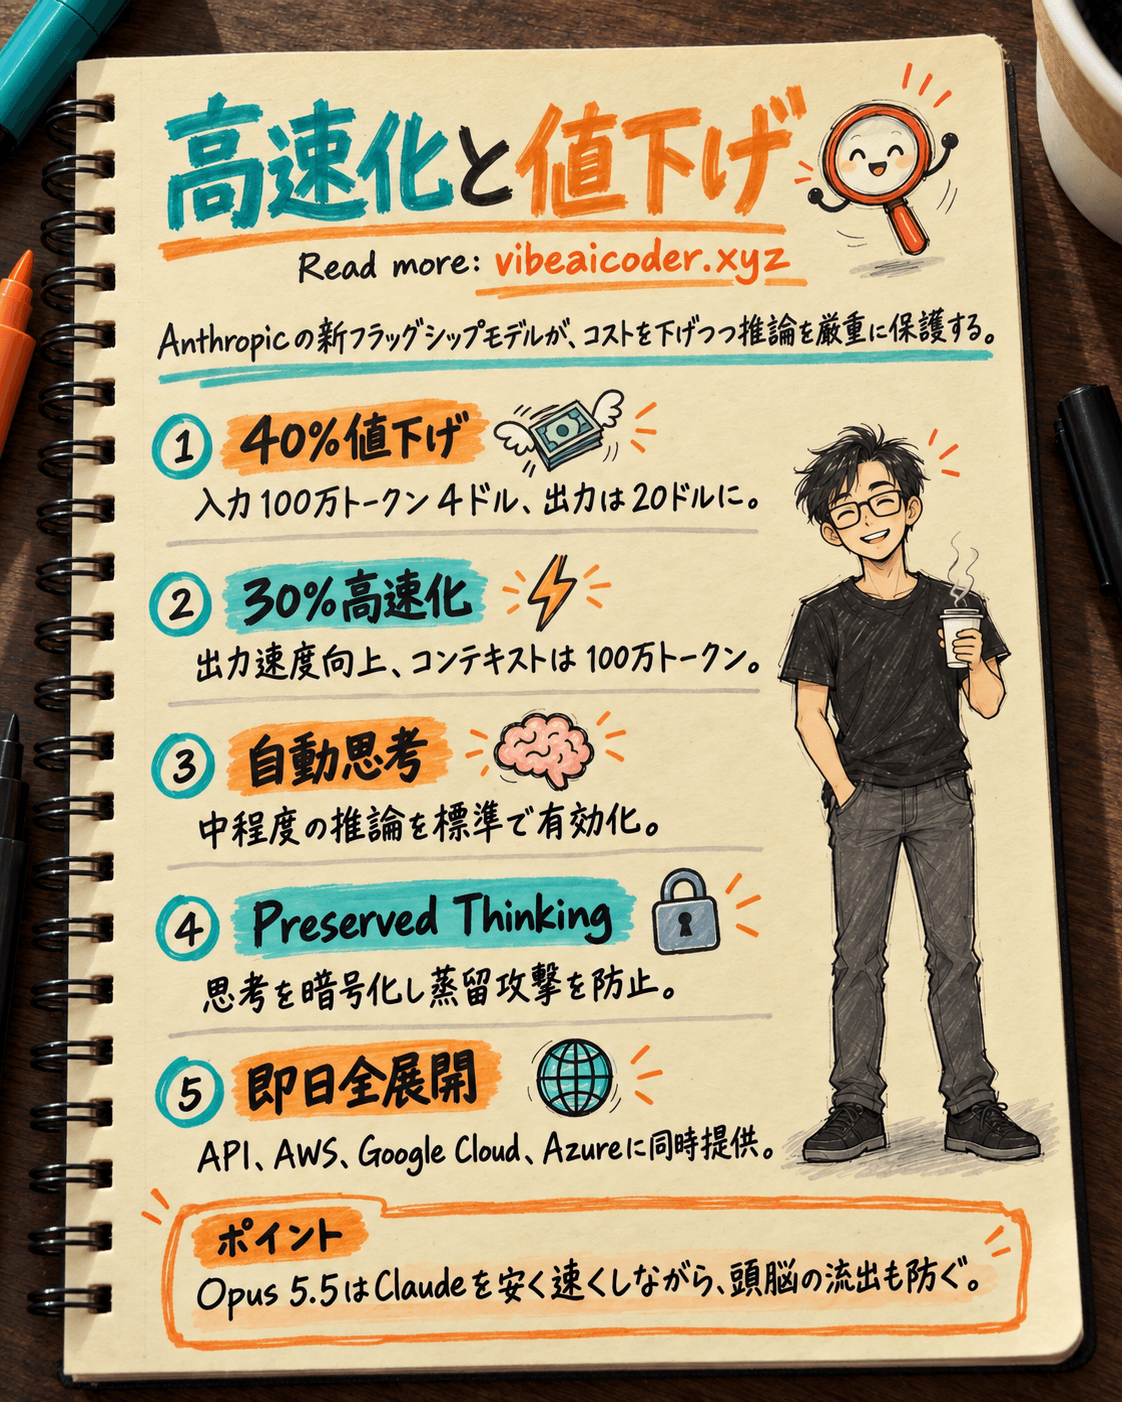
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止