 AI tạo ảnh hoạt động thế nào? Vì sao nó hay vẽ sai chữ
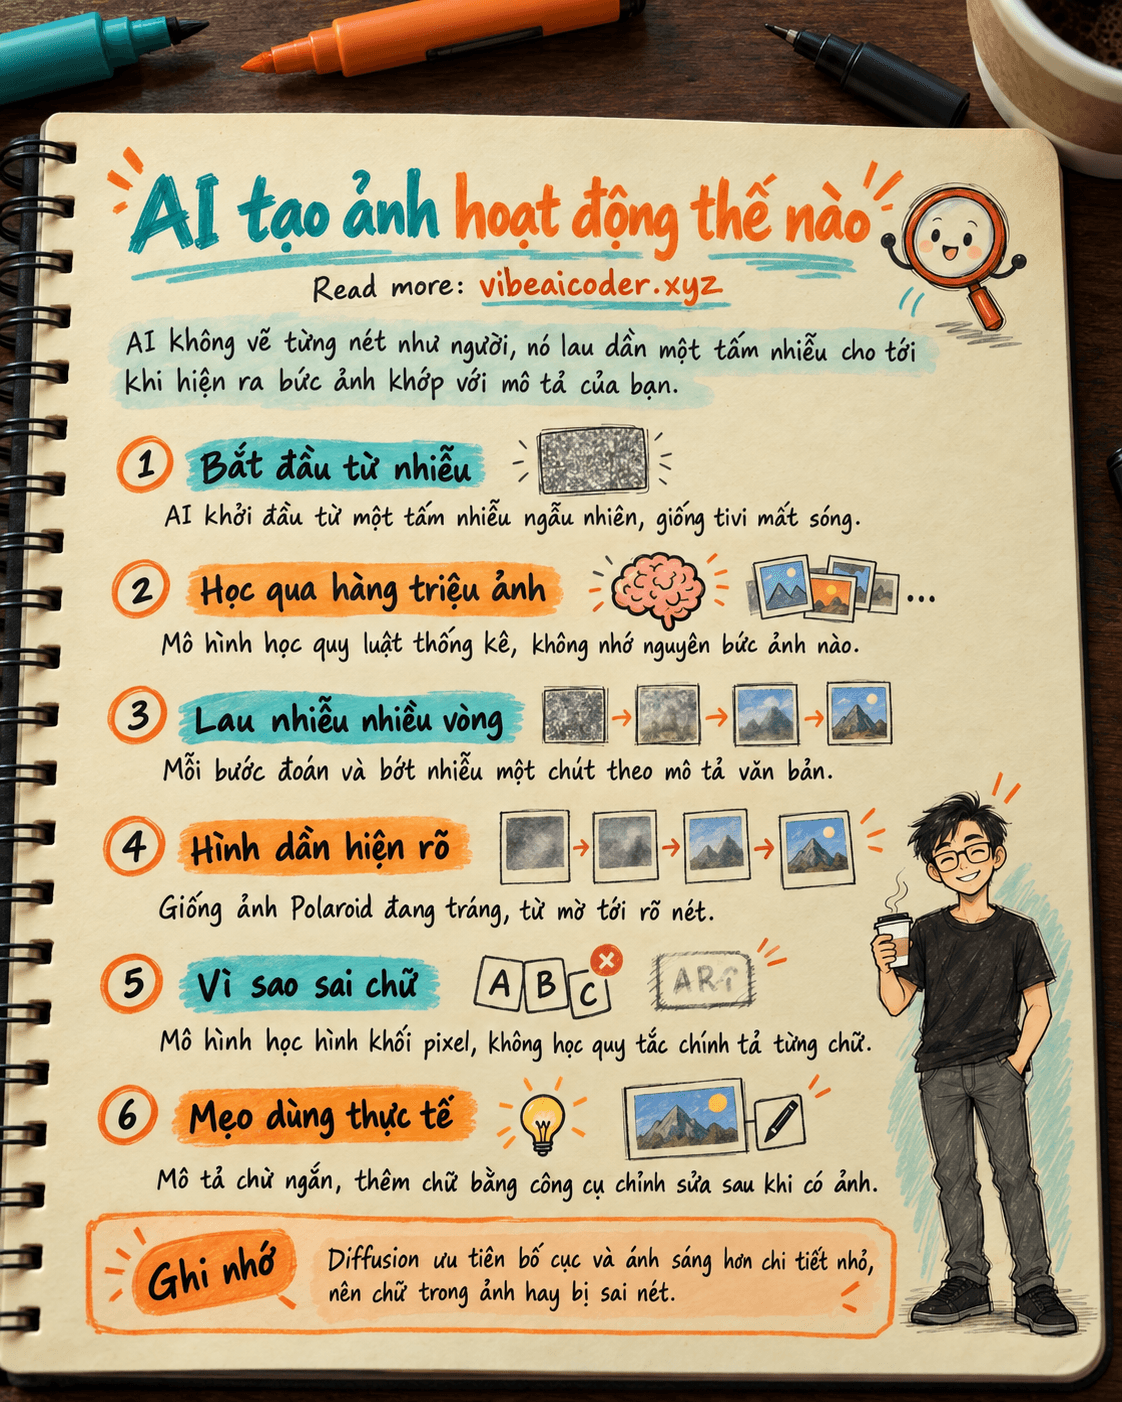
AI tạo ảnh (như Midjourney, DALL-E, Stable Diffusion hay Gemini) không "vẽ" theo từng nét bút như con người. Nó bắt đầu từ một tấm nhiễu hạt (giống màn hình tivi mất sóng) rồi dần dần "lau sạch" nhiễu đó cho tới khi hiện ra một bức ảnh khớp với mô tả bạn gõ vào. Đây gọi là công nghệ khuếch tán, tiếng Anh là diffusion, và nó cũng chính là lý do vì sao AI vẽ người, ánh sáng, bối cảnh rất đẹp nhưng chữ trong ảnh thì thường sai lung tung.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng bạn đưa cho một họa sĩ một tấm kính mờ đầy hơi nước, và bảo họ: "Đằng sau tấm kính này là một con mèo đang ngồi trên ghế sofa, hãy lau dần cho tới khi nhìn rõ". Họa sĩ không biết trước hình ảnh thật sự trông ra sao, nhưng nhờ đã luyện tập hàng triệu lần với đủ loại tấm kính mờ, họ đoán được: "lau chỗ này một chút thì có vẻ là cái tai mèo, lau chỗ kia thì ra hình sofa". Họ lau từng lớp, mỗi lần một ít, và hình ảnh rõ dần.
AI tạo ảnh làm đúng như vậy, chỉ khác là "tấm kính mờ" ban đầu là nhiễu ngẫu nhiên hoàn toàn (random noise), và "họa sĩ" là một mạng nơ-ron đã học qua hàng trăm triệu bức ảnh có chú thích. Nó không nhớ y nguyên bức ảnh nào, mà học được quy luật thống kê: màu da thường đi với màu gì, ánh sáng buổi chiều trông ra sao, một chiếc cốc cà phê thường có hình dáng thế nào. Nhờ vậy nó có thể "lau" ra một bức ảnh hoàn toàn mới, chưa từng tồn tại, nhưng vẫn trông hợp lý.
 Nó hoạt động thế nào
Quá trình này có hai giai đoạn, nhưng bạn chỉ nhìn thấy giai đoạn thứ hai khi dùng AI tạo ảnh:
-
Giai đoạn huấn luyện (chỉ diễn ra một lần, trước khi bạn dùng). Các kỹ sư lấy một bức ảnh thật rõ nét, rồi cố tình làm nhiễu nó dần dần qua rất nhiều bước nhỏ, cho tới khi nó biến thành nhiễu thuần túy, không còn nhận ra gì nữa. Mạng nơ-ron được huấn luyện để làm ngược lại: nhìn một bức ảnh nhiễu ở một bước bất kỳ, nó phải đoán "bước trước đó, bức ảnh trông bớt nhiễu hơn thì ra sao". Lặp lại việc này với hàng trăm triệu bức ảnh, mô hình dần dần giỏi lên trong việc đoán ngược từ nhiễu ra hình.
-
Giai đoạn tạo ảnh (xảy ra mỗi khi bạn gõ prompt). AI bắt đầu từ một tấm nhiễu ngẫu nhiên hoàn toàn mới. Nó đọc mô tả văn bản của bạn (ví dụ "một con mèo cam ngồi đọc sách trong thư viện, phong cách tranh màu nước") và dùng mô tả đó làm kim chỉ nam.
-
Lặp lại việc "đoán và lau bớt nhiễu" nhiều lần, có thể từ vài chục tới vài trăm bước. Mỗi bước, mô hình tự hỏi: "với nhiễu hiện tại và mô tả này, bước tiếp theo nên bớt nhiễu ở đâu để giống con mèo cam hơn, giống thư viện hơn, giống tranh màu nước hơn".
-
Hình ảnh dần hiện rõ giống như ảnh Polaroid đang tráng: ban đầu chỉ là các khối màu mờ mờ, sau vài chục bước mới thấy rõ hình dạng con mèo, cái ghế, các giá sách, rồi tới chi tiết nhỏ như ánh mắt, vân gỗ.
-
Kết thúc khi đủ số bước, AI trả về bức ảnh cuối cùng. Toàn bộ quá trình này diễn ra trong vài giây tới vài chục giây tùy công cụ, vì máy chủ xử lý hàng loạt phép tính rất nhanh.
Về chuyện vẽ sai chữ: mô hình học qua pixel và hình khối, chứ không học qua từng con chữ với quy tắc chính tả. Khi bạn yêu cầu vẽ một biển hiệu có chữ "COFFEE", AI không "biết đọc" chữ đó, nó chỉ nhớ mang máng hình dạng con chữ trông như thế nào qua các bức ảnh nó từng thấy, rồi cố vẽ ra hình giông giống chữ cái. Vì quá trình khử nhiễu ưu tiên bố cục tổng thể (ánh sáng, màu sắc, hình khối lớn) hơn là chi tiết nhỏ như từng nét chữ, nên chữ thường bị thừa hoặc thiếu nét, sai thứ tự chữ cái, hoặc biến thành ký tự vô nghĩa trông giống chữ thật ở xa nhưng nhìn gần thì sai.
 Điều này có ý nghĩa gì với bạn
Hiểu cơ chế này giúp bạn dùng AI tạo ảnh hiệu quả hơn:
- Đừng yêu cầu AI vẽ chữ dài hoặc chữ quan trọng (tên thương hiệu, số điện thoại, nội dung biển quảng cáo). Nếu cần chữ chính xác, hãy vẽ ảnh không chữ trước, rồi thêm chữ bằng công cụ chỉnh sửa ảnh hoặc phần mềm thiết kế như Canva.
- Mô tả càng chi tiết về bố cục, ánh sáng, phong cách thì kết quả càng ổn định, vì đó là những thứ mô hình được huấn luyện tốt. Ví dụ thay vì chỉ gõ "một quán cà phê", hãy gõ "quán cà phê nhỏ ánh sáng vàng ấm buổi tối, bàn gỗ, khách ngồi đọc sách, phong cách ảnh phim".
- Nếu công cụ cho chọn số bước hoặc chế độ "chất lượng cao", hãy hiểu rằng nhiều bước hơn thường cho ảnh chi tiết hơn, nhưng cũng tốn thời gian và tài nguyên hơn, nên không phải lúc nào cũng cần bật mức cao nhất cho ảnh phác thảo nhanh.
 Hiểu lầm thường gặp
- "AI ghép các bức ảnh có sẵn lại với nhau." Không đúng. AI không cắt dán ảnh thật, nó tạo ra pixel hoàn toàn mới từ nhiễu ngẫu nhiên dựa trên quy luật đã học, nên ảnh ra thường chưa từng tồn tại ở đâu trước đó.
- "AI không đọc hiểu gì về chữ, chỉ cần dùng model mới hơn là tự động vẽ đúng chữ." Một số công cụ đời mới (ví dụ các bản cập nhật gần đây của một vài nền tảng tạo ảnh) có cải thiện đáng kể việc vẽ chữ ngắn nhờ kết hợp thêm bước xử lý văn bản riêng, nhưng chữ dài hoặc nhiều dòng vẫn dễ sai. Đây là giới hạn kỹ thuật đang được cải thiện dần, chưa phải đã giải quyết xong.
- "Ảnh AI tạo ra là bản sao của ảnh thật trong dữ liệu huấn luyện." Về cơ bản mô hình học quy luật thống kê chứ không lưu nguyên bức ảnh, nhưng nếu một bức ảnh xuất hiện lặp đi lặp lại rất nhiều lần trong dữ liệu huấn luyện, đôi khi mô hình có thể tạo ra kết quả gần giống. Đây cũng là lý do bản quyền ảnh AI vẫn còn nhiều tranh cãi.
 Câu hỏi thường gặp
AI tạo ảnh có cần kết nối mạng khi vẽ không? Phần lớn công cụ phổ biến (Midjourney, DALL-E trong ChatGPT, Gemini) chạy trên máy chủ, nên cần mạng. Một số mô hình mã nguồn mở như Stable Diffusion có thể chạy ngay trên máy tính cá nhân nếu máy đủ mạnh, không cần mạng khi tạo ảnh.
Vì sao cùng một mô tả nhưng mỗi lần AI vẽ ra ảnh khác nhau? Vì mỗi lần bắt đầu từ một tấm nhiễu ngẫu nhiên khác nhau. Nhiễu khởi đầu khác thì kết quả khử nhiễu cũng khác, dù mô tả văn bản giữ nguyên.
Làm sao để AI vẽ chữ đúng hơn? Viết chữ càng ngắn càng dễ đúng (một hai từ dễ hơn cả câu dài), đặt chữ trong dấu ngoặc kép trong prompt, và nếu công cụ hỗ trợ, thử vẽ lại nhiều lần rồi chọn bản đúng nhất, hoặc sửa chữ bằng tay sau khi có ảnh.
Diffusion có phải là cách duy nhất để AI tạo ảnh không? Không. Đây là cách phổ biến nhất hiện nay vì cho chất lượng cao và ổn định, nhưng vẫn có những hướng khác (như các mô hình dựa trên kiến trúc transformer) đang được nghiên cứu và một số công cụ mới đã bắt đầu dùng kết hợp.
Ảnh do AI tạo có dùng được cho mục đích thương mại không? Tùy vào điều khoản của từng công cụ và vùng pháp lý, một số nơi vẫn chưa rõ ràng về quyền sở hữu với ảnh AI tạo ra. Nếu dùng cho mục đích kinh doanh, bạn nên đọc kỹ điều khoản sử dụng của công cụ đó trước.
Nếu bạn mới làm quen với AI là gì, có thể đọc thêm về mô hình ngôn ngữ lớn (LLM) là gì để hiểu AI viết chữ khác AI vẽ ảnh ra sao, hoặc tìm hiểu đa phương thức (multimodal) là gì khi một AI vừa đọc ảnh vừa hiểu chữ. Nếu muốn thực hành luôn, bài dùng ChatGPT Images để tạo ảnh từ bản phác và sửa đúng chỗ sẽ hướng dẫn từng bước cụ thể.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 GPU Là Gì? Vì Sao AI Cần Chip Đồ Họa Mạnh Để Huấn Luyện Và Chạy
 Cơ chế attention là gì? Vì sao AI biết chú ý đúng chỗ trong một câu dài