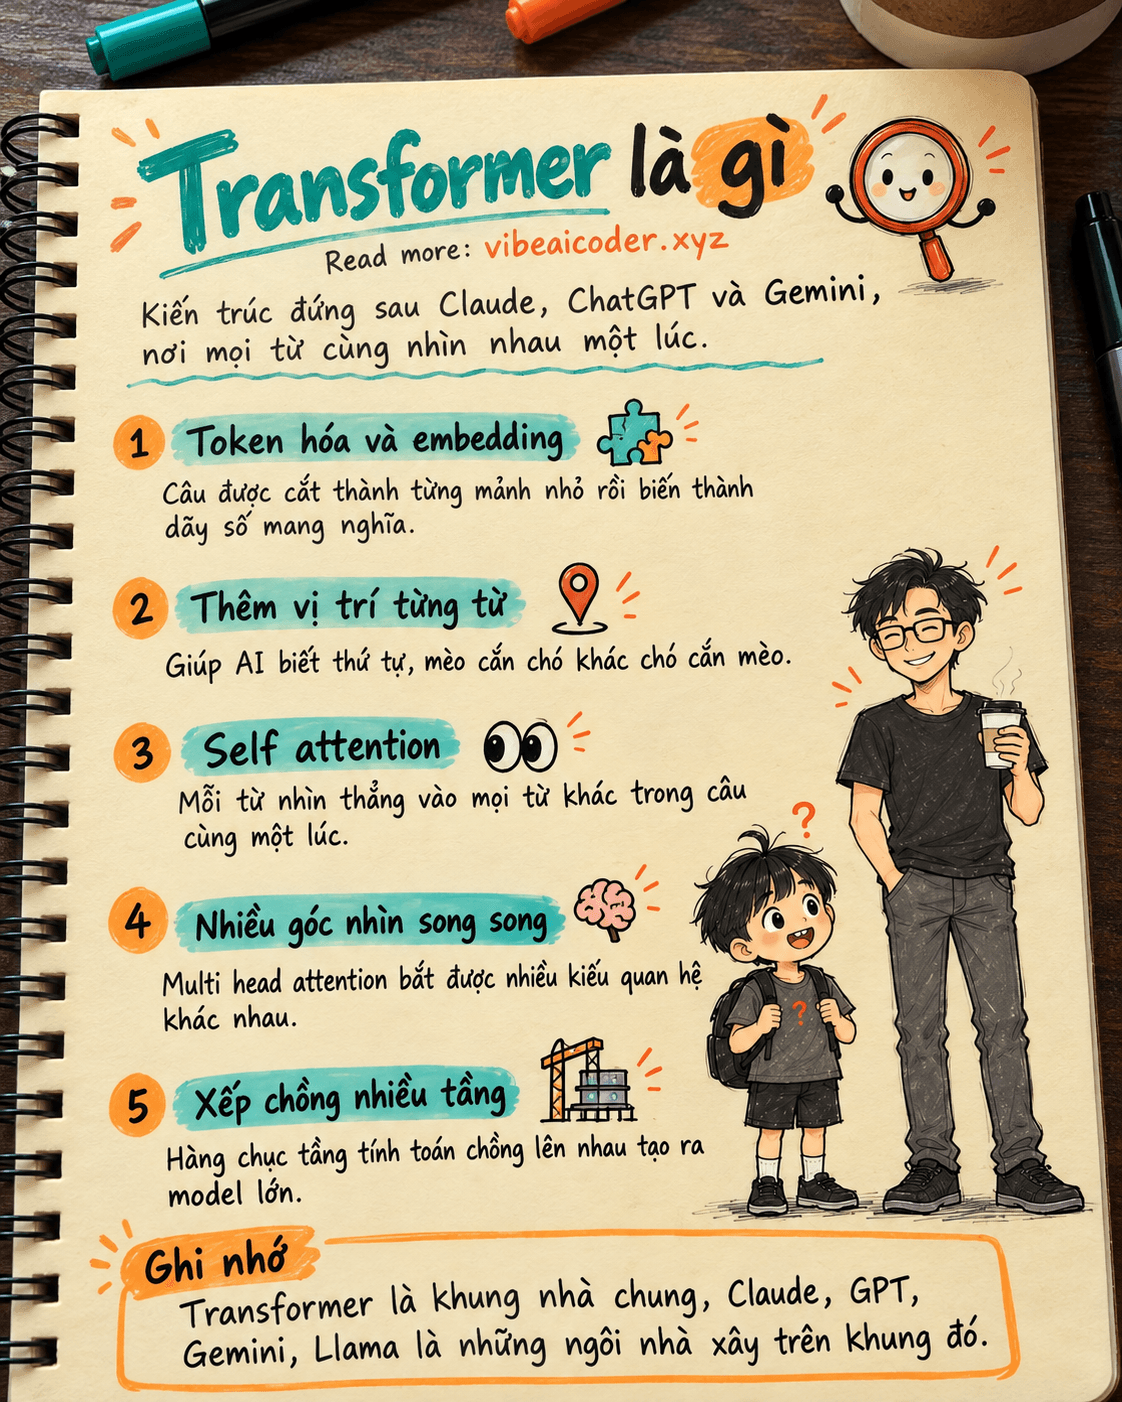
Transformer là gì? Kiến trúc đứng sau hầu hết các mô hình ngôn ngữ lớn hiện nay
 Transformer là gì? Kiến trúc đứng sau hầu hết các mô hình ngôn ngữ lớn hiện nay
Transformer là kiểu "bộ não" mạng nơ-ron mà gần như mọi AI trò chuyện bạn đang dùng, từ Claude, ChatGPT, Gemini đến Llama, đều được xây trên đó. Nó không phải một sản phẩm cụ thể, mà là bản thiết kế chung cho cách AI đọc một câu, hiểu các từ liên quan đến nhau ra sao, rồi đoán từ tiếp theo. Transformer ra đời năm 2017 trong một bài báo của nhóm nghiên cứu tại Google, và gần mười năm sau nó vẫn là nền móng của gần như toàn bộ ngành mô hình ngôn ngữ lớn (LLM).
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng một lớp học đang thảo luận nhóm để giải một bài toán khó. Trước đây, AI kiểu cũ (gọi là mạng hồi quy, RNN) làm việc như trò chơi "truyền tin": người đầu tiên thì thầm câu chuyện cho người thứ hai, người thứ hai thì thầm lại cho người thứ ba, cứ thế đến cuối hàng. Thông tin đi qua càng nhiều người, càng dễ bị méo hoặc quên mất chi tiết ban đầu.
Transformer làm khác hẳn: nó giống cả lớp ngồi quây thành vòng tròn, ai cũng nghe được lời của tất cả những người còn lại cùng một lúc, không cần chờ truyền tay. Khi đọc câu "Con mèo mà Lan nuôi từ nhỏ hôm nay bị ốm", Transformer cho phép từ "bị ốm" ở cuối câu "nhìn thẳng" vào từ "con mèo" ở đầu câu, dù giữa chúng có một chuỗi dài các từ khác. Cách nhìn toàn cảnh một lượt này gọi là self-attention (tự chú ý), và nó chính là phần cốt lõi khiến Transformer mạnh hơn hẳn các kiến trúc cũ.
 Nó hoạt động thế nào
Nói đơn giản, một Transformer xử lý một câu qua các bước sau:
- Cắt câu thành từng mảnh nhỏ (token), ví dụ mỗi từ hoặc một phần của từ, rồi biến mỗi mảnh thành một dãy số gọi là embedding, cách AI "ghi nhớ" nghĩa của từ đó.
- Gắn thêm vị trí của từng từ trong câu (positional encoding), vì nếu chỉ có dãy số nghĩa mà không biết thứ tự, AI sẽ không phân biệt được "mèo cắn chó" với "chó cắn mèo".
- Chạy self-attention: mỗi từ so sánh bản thân với tất cả các từ khác trong câu để tính xem từ nào đáng chú ý nhất đối với nó lúc này.
- Lặp lại việc chú ý theo nhiều "góc nhìn" song song (multi-head attention), có góc nhìn chú ý vào quan hệ chủ ngữ, vị ngữ, có góc nhìn khác lại bắt được sắc thái cảm xúc hay ý phủ định.
- Đưa qua thêm vài lớp tính toán (feed-forward) để tổng hợp lại thông tin, rồi xếp chồng rất nhiều tầng như vậy lên nhau, một mô hình lớn có thể có hàng chục đến cả trăm tầng.
Vì tất cả các từ được xử lý cùng lúc thay vì lần lượt, Transformer tận dụng được phần cứng chạy song song (GPU) cực tốt. Đây là lý do các công ty có thể huấn luyện mô hình khổng lồ trong thời gian hợp lý, thay vì phải chờ xử lý từng từ một như kiến trúc cũ.
 Điều này có ý nghĩa gì với bạn
Bạn không cần tự code Transformer để dùng AI tốt hơn, nhưng hiểu nó giúp bạn đoán đúng AI sẽ phản ứng thế nào:
- Khi dán một đoạn hội thoại dài hoặc cả tài liệu vào khung chat, AI vẫn có thể nhớ một chi tiết nhỏ ở đầu đoạn nhờ cơ chế chú ý toàn cục, đây cũng là lý do các mô hình quảng cáo "đọc được cửa sổ ngữ cảnh dài" đáng tin hơn so với AI kiểu cũ.
- Khi chọn giữa một model nhỏ, nhanh và một model lớn hơn, bạn đang chọn giữa một Transformer có ít tầng tính toán (nhanh, rẻ, hợp việc đơn giản) và một Transformer có nhiều tầng hơn (chậm hơn, nhưng xử lý được những câu hỏi cần suy luận nhiều bước).
- Khi viết một câu dài, nhiều mệnh đề phụ, bạn có thể yên tâm hơn là AI vẫn nối đúng chủ ngữ ở đầu câu với động từ ở cuối câu, vì đó chính là việc self-attention được thiết kế để làm tốt.
 Hiểu lầm thường gặp
- "Transformer là tên một AI cụ thể." Sai, Transformer là kiến trúc nền, giống như kiểu khung nhà. Claude, GPT, Gemini, Llama là những "ngôi nhà" khác nhau xây trên cùng kiểu khung đó, mỗi hãng huấn luyện dữ liệu và tinh chỉnh theo cách riêng.
- "Transformer là công nghệ mới gần đây." Thật ra bài báo gốc "Attention Is All You Need" được nhóm nghiên cứu Google công bố từ năm 2017. Cái mới trong vài năm qua là quy mô dữ liệu, số tầng và cách tinh chỉnh sau huấn luyện, chứ bản thân kiến trúc đã có gần một thập kỷ.
- "Càng nhiều 'đầu chú ý' thì AI càng thông minh tuyệt đối." Số lượng tầng và đầu chú ý chỉ là một phần. Chất lượng dữ liệu huấn luyện, cách tinh chỉnh sau đó và cả cách bạn đặt câu hỏi ảnh hưởng đến câu trả lời không kém gì kích thước kiến trúc.
 Câu hỏi thường gặp
Transformer khác gì với mạng nơ-ron thông thường? Transformer vẫn là một loại mạng nơ-ron, nhưng điểm khác biệt là nó dùng self-attention để mọi phần của dữ liệu đầu vào có thể "nhìn" nhau trực tiếp, thay vì chỉ truyền thông tin tuần tự như các kiến trúc cũ.
Vì sao các hãng AI đều chọn Transformer thay vì phát minh kiến trúc khác? Vì nó xử lý song song tốt, học được quan hệ xa giữa các từ, và đã được cộng đồng nghiên cứu tối ưu liên tục suốt gần mười năm, nên hiện tại chưa có kiến trúc nào thay thế hoàn toàn được nó ở quy mô lớn.
Transformer có liên quan gì đến cơ chế attention không? Có, attention chính là bộ phận cốt lõi bên trong Transformer, bạn có thể hình dung Transformer là cả bộ máy, còn attention là bánh răng quan trọng nhất bên trong.
Model Transformer càng nhiều tham số thì càng tốt đúng không? Không hẳn. Tham số (parameter) nhiều hơn thường giúp model học được nhiều kiểu quan hệ phức tạp hơn, nhưng dữ liệu huấn luyện kém chất lượng vẫn có thể khiến một model nhiều tham số trả lời tệ hơn một model nhỏ được huấn luyện tốt.
Người mới dùng AI có cần hiểu Transformer để dùng AI tốt hơn không? Không bắt buộc, giống như bạn không cần biết cấu tạo động cơ để lái xe. Nhưng hiểu sơ lược giúp bạn lý giải được vì sao AI đôi khi "nhớ" rất tốt những đoạn hội thoại dài, và vì sao các hãng liên tục quảng cáo cửa sổ ngữ cảnh ngày càng lớn.
Muốn hiểu bức tranh tổng thể hơn trước khi đi sâu vào Transformer, bạn có thể đọc lại AI là gì để nắm khái niệm gốc, hoặc bài về mô hình ngôn ngữ lớn (LLM) để thấy Transformer được dùng vào việc đoán chữ tiếp theo cụ thể ra sao.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
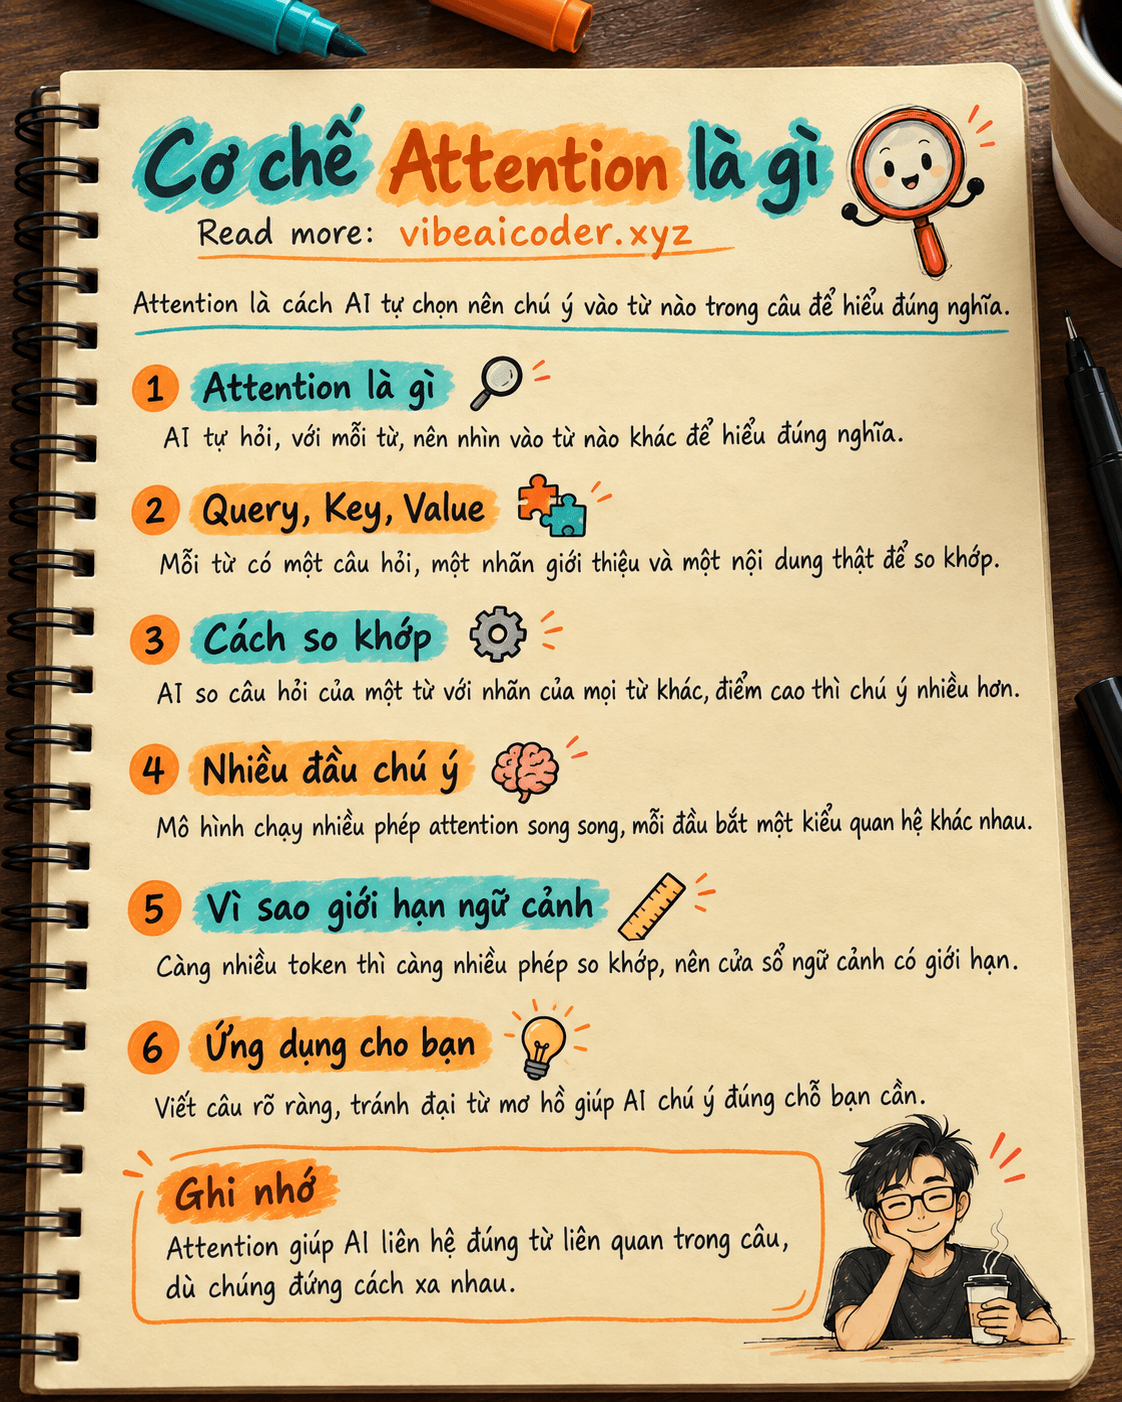
 Cơ chế attention là gì? Vì sao AI biết chú ý đúng chỗ trong một câu dài
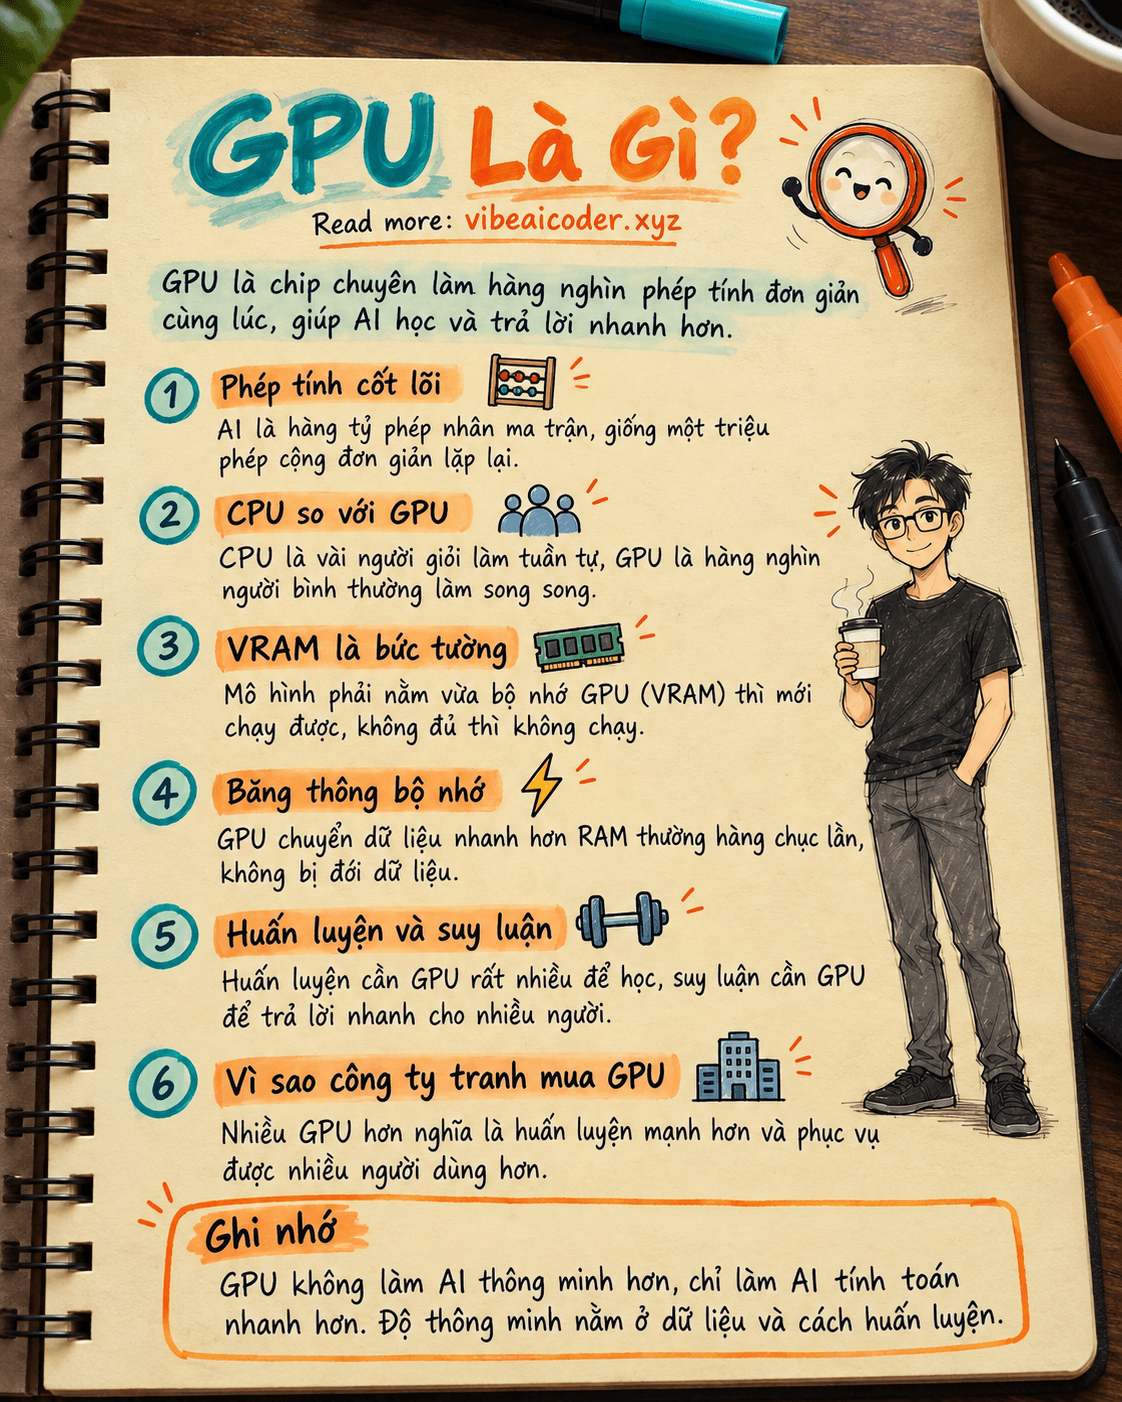
 GPU Là Gì? Vì Sao AI Cần Chip Đồ Họa Mạnh Để Huấn Luyện Và Chạy
 AI detector là gì? Công cụ phát hiện văn bản AI viết đúng được bao nhiêu phần trăm