 Quy luật mở rộng (Scaling Law) là gì? Vì sao AI càng to càng giỏi, nhưng không thể to mãi
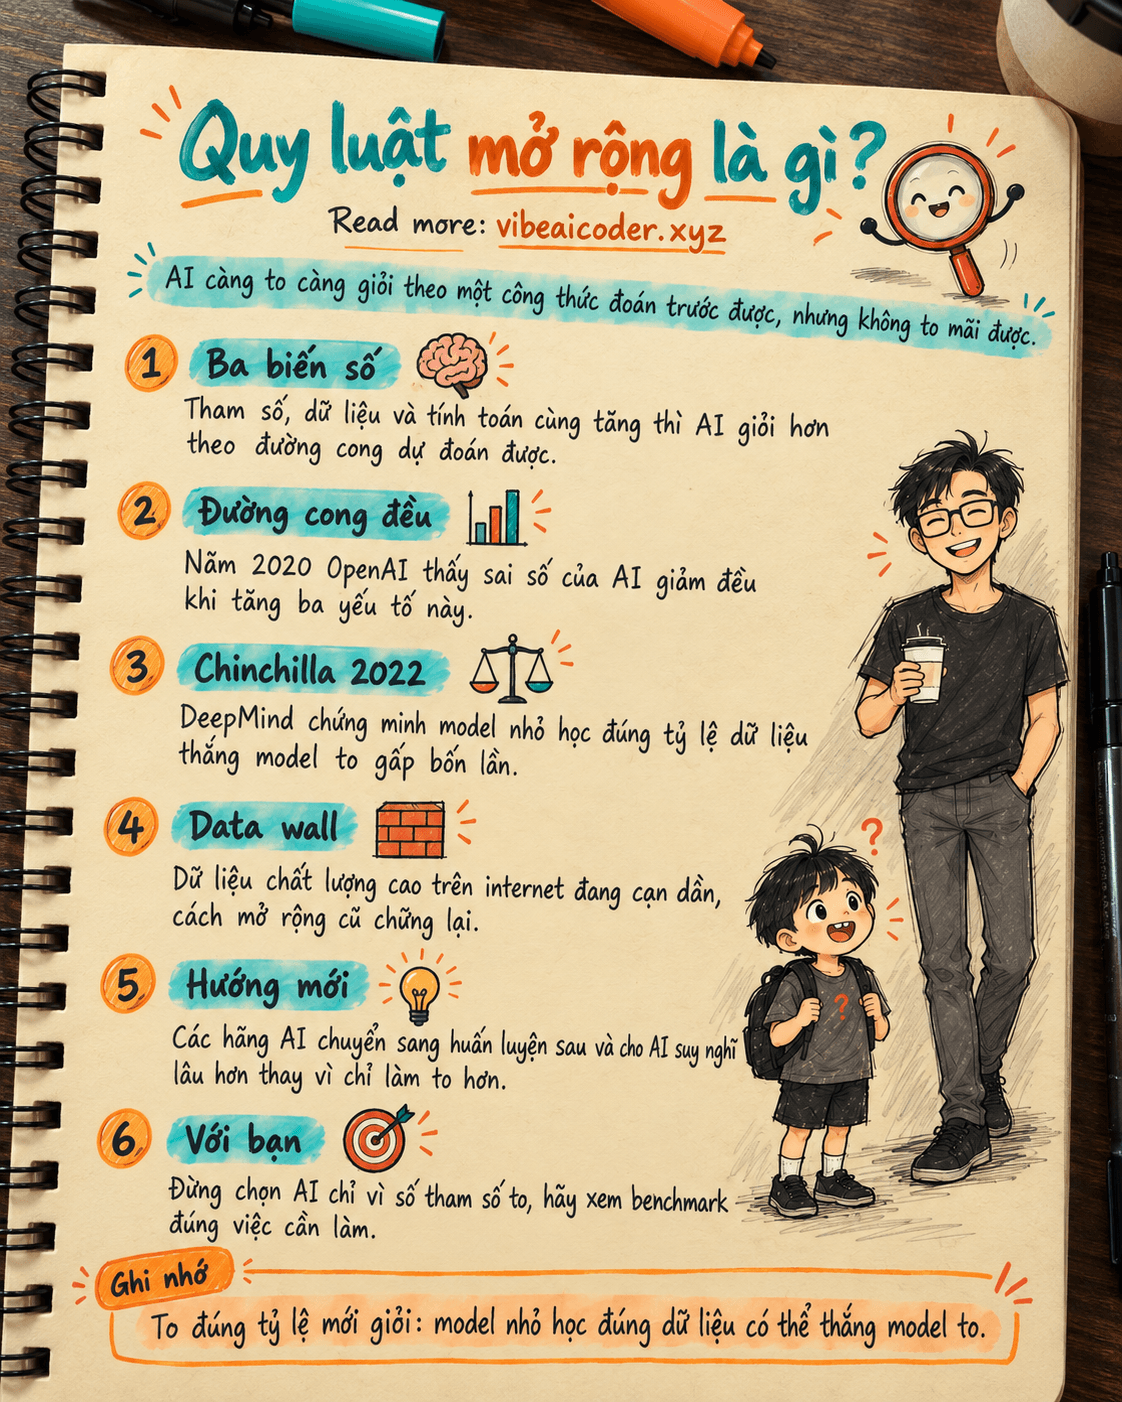
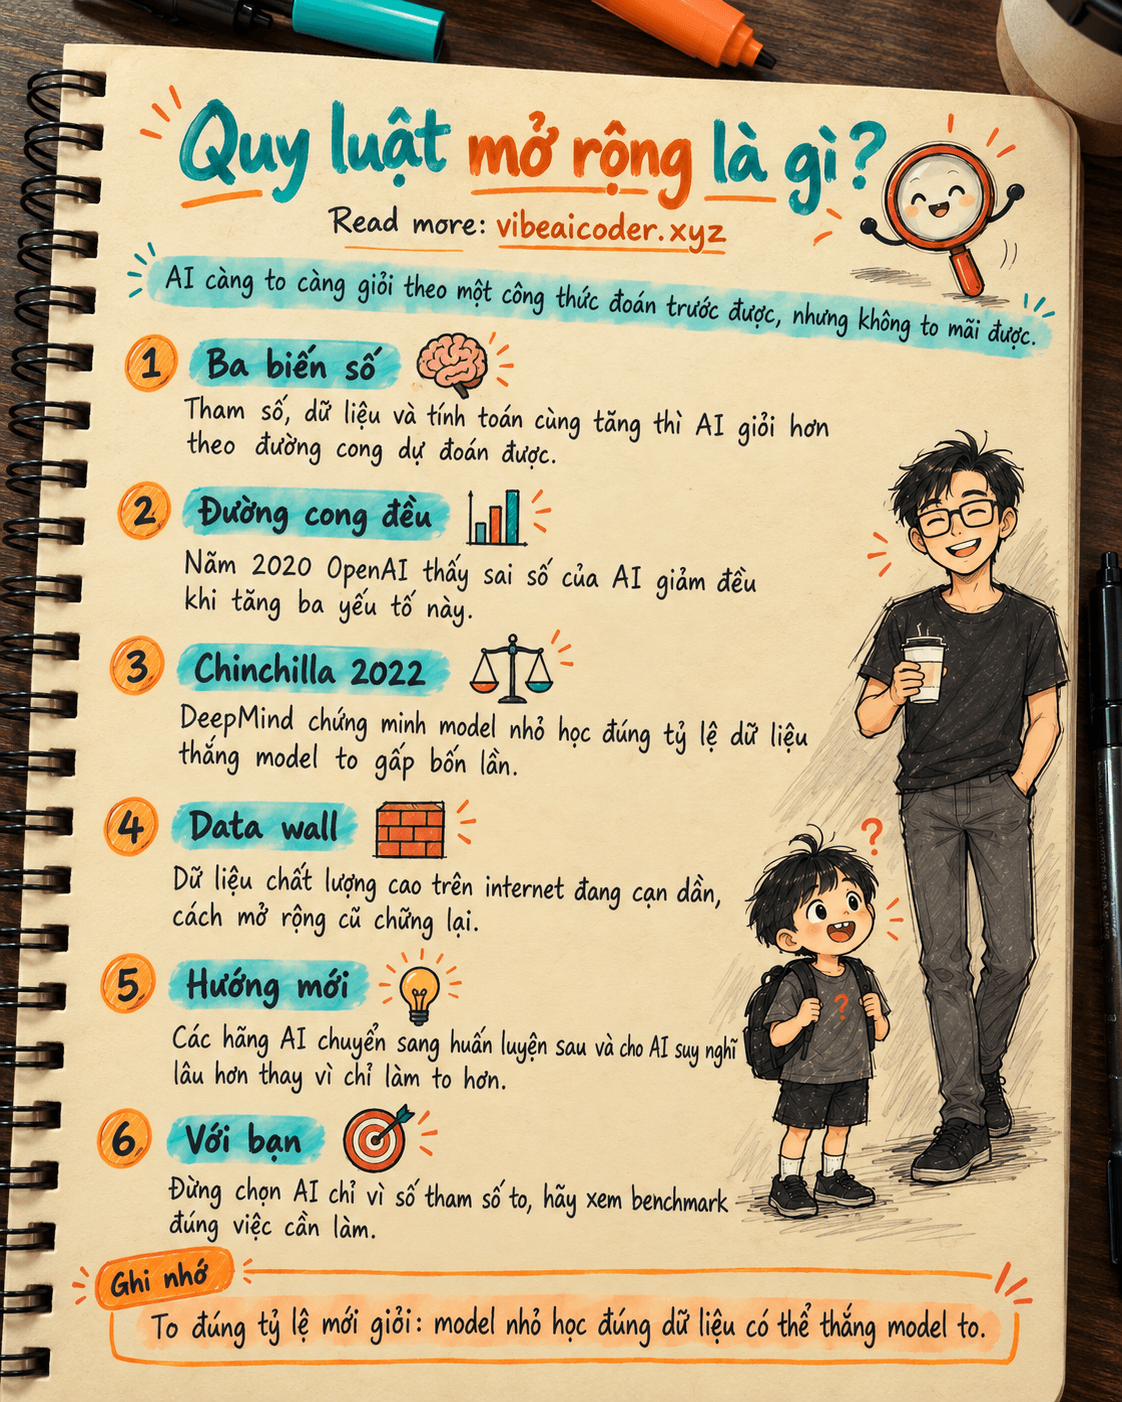
Quy luật mở rộng, hay scaling law, là quy luật mà giới nghiên cứu AI quan sát được: khi tăng cùng lúc ba thứ, kích thước mô hình (số tham số), lượng dữ liệu đưa vào huấn luyện, và sức mạnh tính toán, thì AI sẽ trả lời chính xác hơn theo một đường cong khá dễ đoán trước. Đây là lý do các hãng AI đua nhau xây dựng model ngày càng lớn, không phải đoán mò mà đi theo một công thức đã được kiểm chứng bằng hàng trăm thí nghiệm. Nhưng quy luật này cũng có giới hạn, và hiểu nó giúp bạn đọc tin tức AI tỉnh táo hơn mỗi khi thấy một con số "tỷ tham số" được quảng cáo rầm rộ.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng một học sinh chuẩn bị thi học kỳ. Ba yếu tố quyết định điểm số là: trí nhớ của em (giống như số tham số của model), số lượng sách và đề bài em đã ôn qua (giống như dữ liệu huấn luyện), và số giờ em dành ra để luyện tập (giống như sức mạnh tính toán). Nếu tăng đều cả ba thứ theo đúng tỷ lệ, điểm thi của em sẽ tăng lên một cách khá ổn định và dự đoán được, năm nay ôn kỹ hơn năm ngoái 20%, điểm thường cũng nhích lên tương ứng.
Nhưng có hai cái bẫy. Một là nếu em có trí nhớ siêu phàm (tham số khổng lồ) mà chỉ ôn vài quyển sách mỏng (ít dữ liệu), em vẫn không giỏi hơn bạn trí nhớ bình thường nhưng ôn đúng bộ đề sát với kỳ thi. Hai là đến một lúc nào đó, dù ôn thêm bao nhiêu sách cũ, hoặc học thêm bao nhiêu giờ, điểm cũng không tăng thêm được bao nhiêu nữa, vì sách cũ đã học hết kiến thức cần thiết rồi, cần một nguồn tài liệu mới hẳn mới giúp ích. AI cũng y hệt như vậy: mở rộng đúng tỷ lệ thì giỏi lên, mở rộng lệch tỷ lệ thì phí công, và đến một ngưỡng thì cần một cách tiếp cận khác chứ không chỉ "học nhiều hơn".
 Nó hoạt động thế nào
-
Ba biến số chính. Các nhà nghiên cứu theo dõi ba con số khi huấn luyện một model: số tham số (N, càng nhiều model càng "có chỗ chứa" kiến thức), lượng dữ liệu (D, số từ ngữ liệu model được đọc qua), và lượng tính toán (C, số phép tính máy chủ phải xử lý, thường đo bằng số GPU chạy trong bao lâu).
-
Vẽ đồ thị, thấy một đường cong đều. Năm 2020, nhóm nghiên cứu tại OpenAI thử huấn luyện hàng chục model ở nhiều kích thước khác nhau, rồi vẽ biểu đồ sai số (loss, càng thấp model càng đoán đúng) theo N, D, C. Kết quả bất ngờ: sai số giảm theo một đường cong lũy thừa rất đều, gần như không có bước nhảy hay ngoại lệ lớn. Nói cách khác, cứ tăng gấp đôi dữ liệu và tính toán theo đúng công thức, sai số giảm một mức gần như tính trước được bằng máy tính cầm tay, không cần huấn luyện thử mới biết.
-
Phát hiện Chinchilla: đừng chỉ làm model to, hãy cân bằng. Năm 2022, nhóm DeepMind công bố nghiên cứu Chinchilla, chỉ ra rằng rất nhiều model thời đó bị "thừa tham số, thiếu dữ liệu": họ làm model rất to nhưng cho ăn ít dữ liệu hơn mức tối ưu. Họ huấn luyện lại một model nhỏ hơn (70 tỷ tham số) nhưng cho học nhiều dữ liệu hơn hẳn, và nó vượt qua model to gấp bốn lần (280 tỷ tham số) của chính DeepMind trước đó. Từ đó, ngành AI đổi cách tính: tăng tham số và dữ liệu phải đi theo một tỷ lệ cân bằng, không phải cứ to là thắng.
-
Đoán trước được nên dám đầu tư lớn. Vì đường cong khá ổn định, các hãng AI có thể huấn luyện thử ở quy mô nhỏ, đo sai số, rồi dùng công thức để "ngoại suy" xem nếu phóng to lên gấp 100 lần thì model sẽ giỏi đến đâu. Nhờ vậy họ mới dám chi hàng trăm triệu đô cho một lần huấn luyện model lớn, vì biết trước gần đúng kết quả sẽ ra sao trước khi bấm nút chạy.
-
Nhưng đường cong không đi mãi lên. Quy luật mở rộng chỉ đúng trong một vùng dữ liệu và tính toán nhất định. Khi dữ liệu chất lượng cao trên internet dần cạn kiệt (giới nghiên cứu gọi là "data wall"), hoặc chi phí tính toán tăng vọt mà lợi ích thu lại ngày càng nhỏ (lợi ích giảm dần), đường cong bắt đầu chững lại. Đây chính là lý do gần đây các hãng AI chuyển hướng đầu tư: thêm bước huấn luyện sau khi model đã học xong (post-training, tinh chỉnh theo phản hồi con người), dùng dữ liệu tổng hợp do AI khác tạo ra, và đặc biệt là để model "suy nghĩ" lâu hơn trước khi trả lời (gọi là test-time compute), thay vì chỉ chăm chăm làm model to hơn.
 Điều này có ý nghĩa gì với bạn
Hiểu quy luật mở rộng không giúp bạn viết prompt giỏi hơn ngay lập tức, nhưng nó thay đổi cách bạn đọc tin tức AI và chọn công cụ:
-
Đừng chọn AI chỉ vì số tham số to. Khi thấy quảng cáo "model 400 tỷ tham số", đừng vội nghĩ nó chắc chắn giỏi hơn một model 70 tỷ. Hãy tìm điểm benchmark ở đúng việc bạn cần (viết code, dịch thuật, tóm tắt văn bản) rồi so sánh, vì một model nhỏ huấn luyện đúng tỷ lệ hoàn toàn có thể vượt model to huấn luyện ẩu, như câu chuyện Chinchilla ở trên.
-
Hiểu vì sao các hãng AI nói nhiều về "suy luận" gần đây. Khi bạn thấy Claude, GPT hay Gemini quảng cáo chế độ "thinking" hoặc "reasoning" thay vì chỉ khoe số tham số, đó là dấu hiệu họ đang mở rộng theo một trục khác: cho model thời gian suy nghĩ lâu hơn trước khi trả lời, vì trục "làm model to hơn" đang chạm giới hạn lợi nhuận giảm dần.
-
Đánh giá đúng các model mã nguồn mở nhỏ. Nhiều model mã nguồn mở hiện nay chỉ vài tỷ tham số nhưng được huấn luyện trên lượng dữ liệu khổng lồ, nên có thể trả lời tốt ngang model lớn hơn nhiều lần ở một số việc cụ thể. Nếu bạn cần chạy AI trên máy yếu, đừng loại bỏ các model nhỏ chỉ vì nghĩ "nhỏ là kém".
 Hiểu lầm thường gặp
-
"Model nhiều tham số hơn luôn thông minh hơn." Không đúng. Nếu dữ liệu huấn luyện không đủ hoặc không đúng tỷ lệ, một model to vẫn có thể thua một model nhỏ hơn được huấn luyện cẩn thận, chính xác như nghiên cứu Chinchilla đã chứng minh.
-
"Scaling law sẽ đưa AI đến thông minh vô hạn, không có điểm dừng." Không đúng. Quy luật chỉ được kiểm chứng trong vùng dữ liệu và tính toán mà các hãng đã thử nghiệm. Gần đây có dấu hiệu rõ ràng rằng việc chỉ tăng kích thước model theo kiểu cũ đang mang lại lợi ích ngày càng nhỏ, buộc ngành AI phải tìm thêm những cách mở rộng khác như huấn luyện sau và suy luận dài hơn.
-
"Chỉ cần nhiều tiền mua GPU là AI sẽ giỏi." Tiền và GPU đúng là cần thiết vì huấn luyện model lớn rất tốn tính toán, nhưng chất lượng dữ liệu, kiến trúc model (ví dụ như công nghệ Mixture of Experts giúp model lớn vẫn trả lời nhanh) và kỹ thuật huấn luyện sau cũng ảnh hưởng ngang, đôi khi còn quan trọng hơn cả quy mô phần cứng.
 Câu hỏi thường gặp
Scaling law chỉ áp dụng cho AI viết chữ (ngôn ngữ) thôi à? Không. Quy luật tương tự cũng được quan sát ở các model xử lý hình ảnh, âm thanh, và gần đây cả model điều khiển robot: cứ tăng dữ liệu, tham số, tính toán theo đúng tỷ lệ thì kết quả cải thiện theo một đường cong khá ổn định.
"Hết dữ liệu để học" nghĩa là sao, chẳng phải internet có vô tận văn bản? Internet có rất nhiều văn bản, nhưng dữ liệu chất lượng cao, viết đúng ngữ pháp, có thông tin chính xác, không trùng lặp, lại có giới hạn. Nhiều hãng AI lớn được cho là đã dùng gần hết nguồn dữ liệu công khai chất lượng tốt, nên giờ phải tìm thêm dữ liệu riêng (sách, báo mua bản quyền) hoặc dùng dữ liệu tổng hợp do chính AI tạo ra.
Chinchilla là tên một model hay một nghiên cứu? Cả hai. Chinchilla vừa là tên nghiên cứu năm 2022 của DeepMind, vừa là tên model 70 tỷ tham số họ huấn luyện để chứng minh luận điểm của mình, model này vượt qua Gopher, một model 280 tỷ tham số do chính DeepMind làm trước đó nhưng thiếu dữ liệu.
Tôi dùng AI hàng ngày thì có cần quan tâm đến scaling law không? Không bắt buộc. Nhưng biết quy luật này giúp bạn đọc tin "model mới ra mắt" mà không bị con số "bao nhiêu tỷ tham số" đánh lừa, và hiểu vì sao các hãng AI giờ hay nói về "thời gian suy nghĩ" thay vì chỉ nói về kích thước model.
Model nhỏ có khi nào thắng được model to hơn nhiều lần không? Có, và chuyện này xảy ra khá thường xuyên. Một model nhỏ được huấn luyện trên dữ liệu đúng tỷ lệ, đúng chất lượng, cho một việc cụ thể, hoàn toàn có thể trả lời tốt hơn một model to hơn nhưng huấn luyện dàn trải. Đây cũng là lý do nhiều công cụ AI chuyên biệt, nhỏ gọn vẫn sống khỏe bên cạnh các model khổng lồ.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
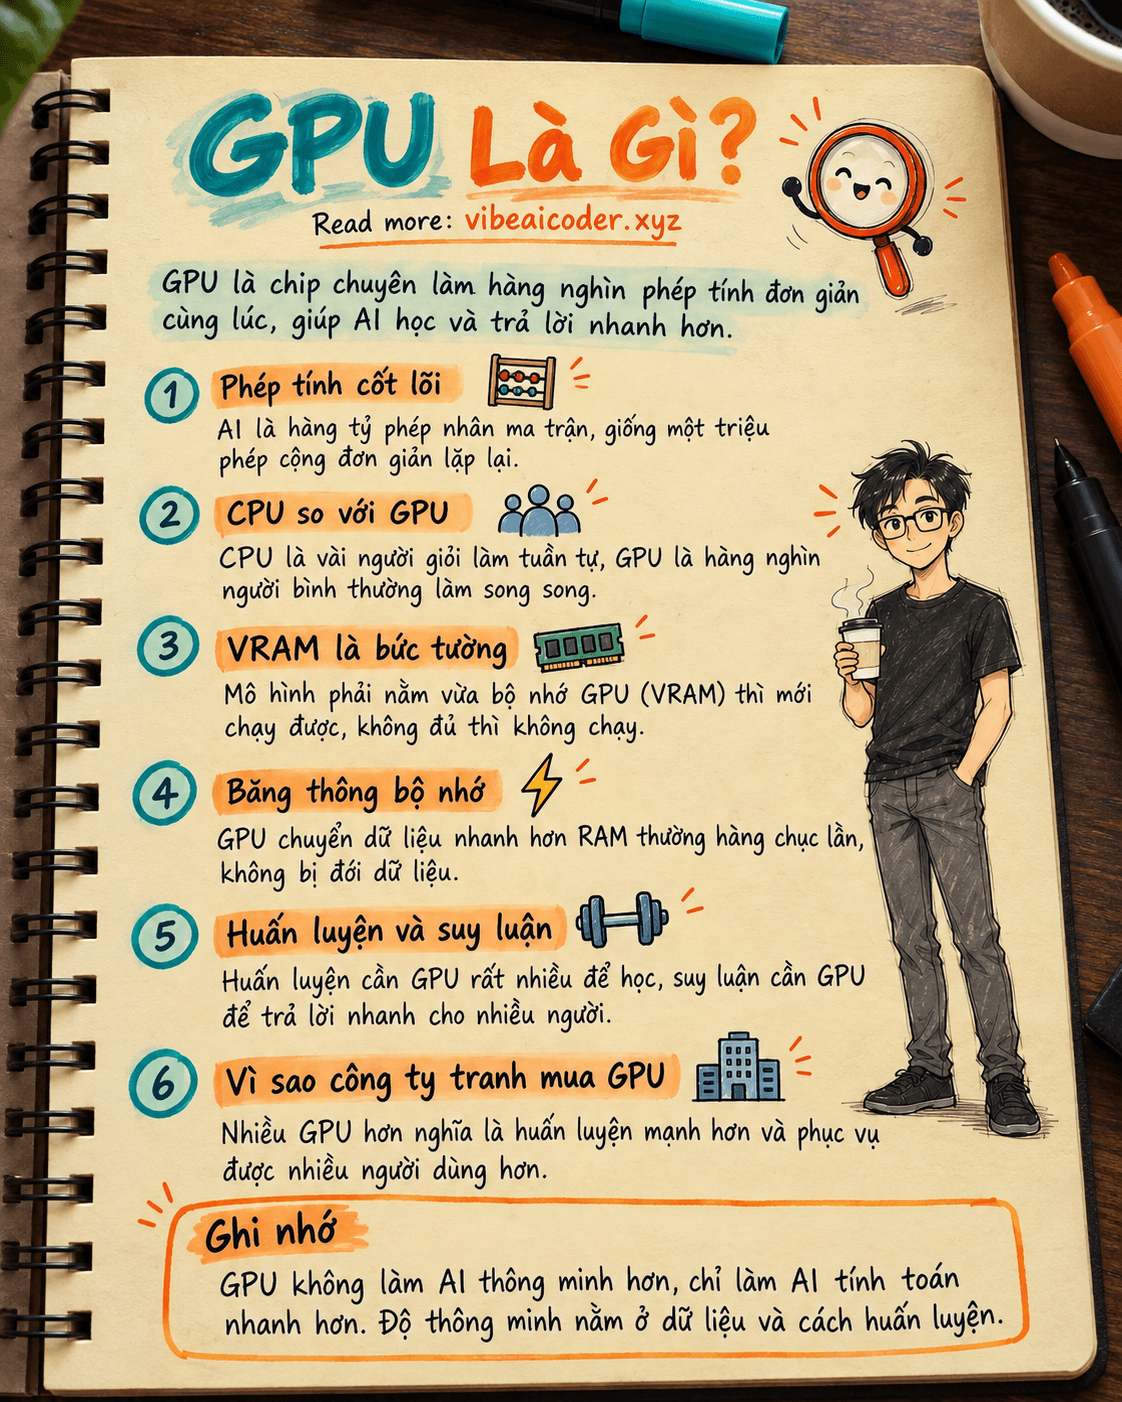
 GPU Là Gì? Vì Sao AI Cần Chip Đồ Họa Mạnh Để Huấn Luyện Và Chạy