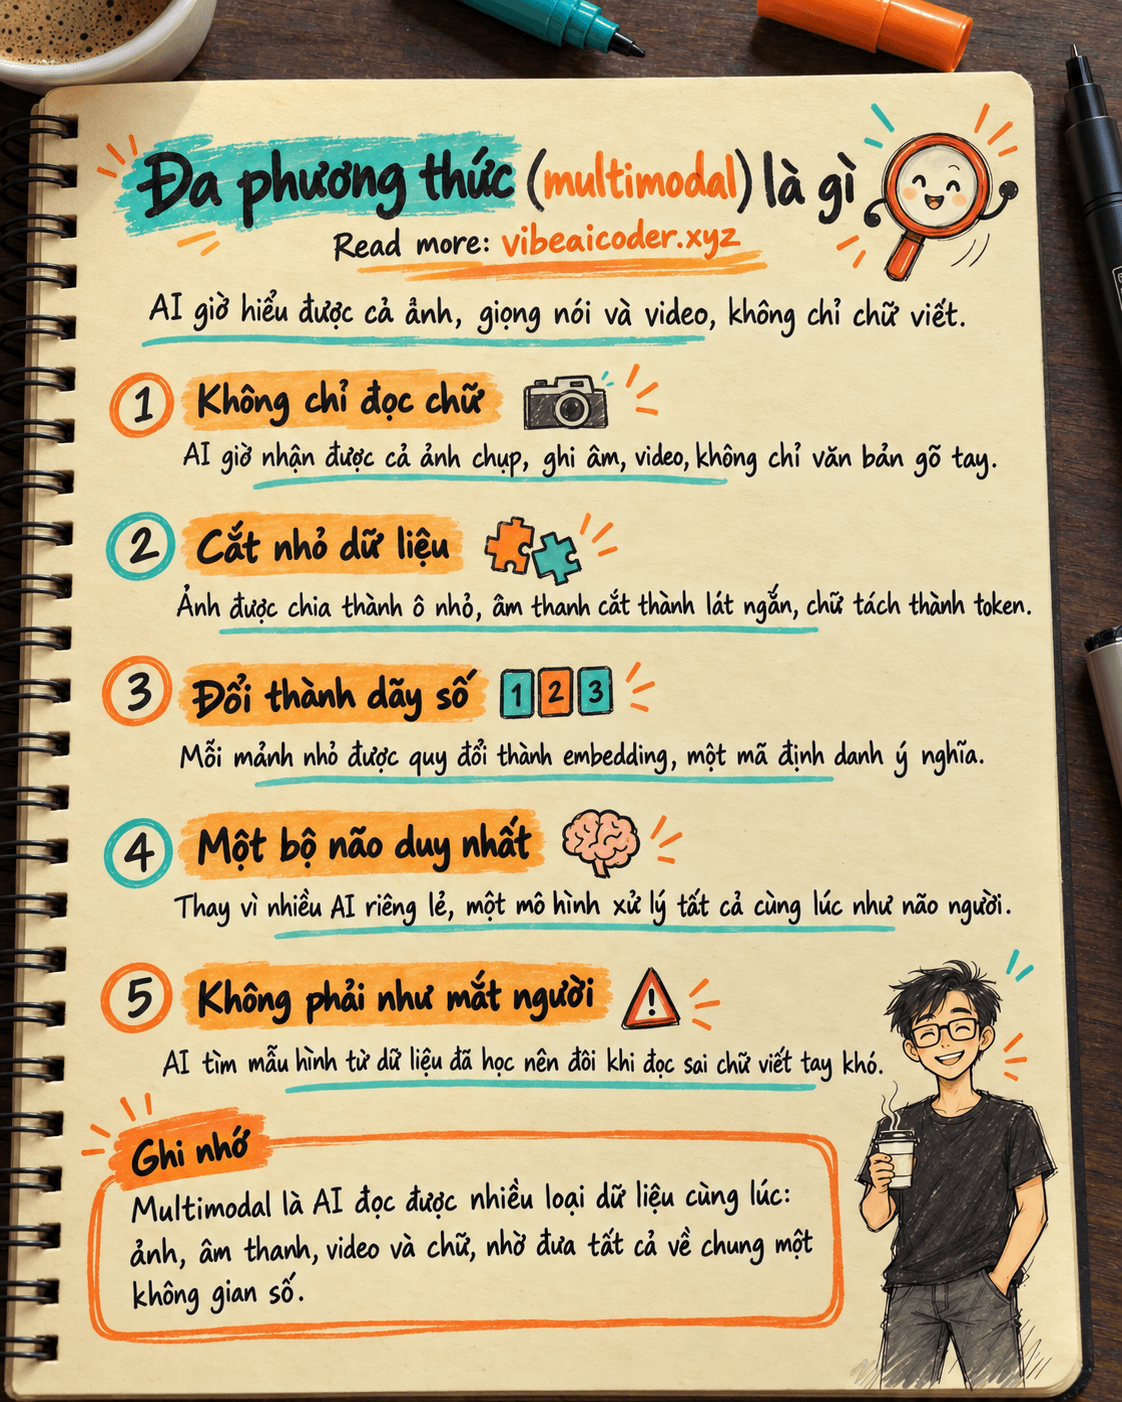
 Đa phương thức (multimodal) là gì? AI giờ đọc ảnh, nghe giọng nói, xem video
Đa phương thức (multimodal) là khả năng một AI hiểu được nhiều loại dữ liệu khác nhau, không chỉ chữ viết mà cả hình ảnh, âm thanh và video, trong cùng một cuộc trò chuyện. Nhờ vậy bạn có thể gửi cho AI một tấm ảnh hóa đơn, một đoạn ghi âm hay một video ngắn, và nó hiểu nội dung y như khi bạn gõ chữ. Đây chính là lý do vì sao gần đây bạn thấy ChatGPT, Claude hay Gemini đều có thể "nhìn" được ảnh bạn chụp.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng bạn có một người trợ lý chỉ biết đọc chữ viết tay gửi qua thư. Bạn muốn nhờ người này xem giúp một tấm ảnh chụp hóa đơn, nhưng họ không biết đọc hình, không nghe được giọng nói, chỉ nhận được thư viết tay. Bạn buộc phải ngồi gõ lại từng dòng số liệu trong hóa đơn thành chữ rồi mới gửi cho họ. Rất mất công.
Giờ tưởng tượng người trợ lý đó học thêm được cách nhìn ảnh, nghe giọng nói, xem video, giống như một người bình thường dùng cả mắt lẫn tai để hiểu thế giới. Bạn chỉ cần chụp ảnh hóa đơn gửi thẳng, họ tự đọc được số liệu, tự tổng hợp luôn. AI multimodal chính là phiên bản "đã học thêm mắt và tai" đó của một AI vốn trước đây chỉ biết đọc chữ.
 Nó hoạt động thế nào
AI đa phương thức xử lý nhiều loại dữ liệu bằng cách biến tất cả về cùng một "ngôn ngữ số" mà nó hiểu được, rồi suy nghĩ trên đó như một luồng duy nhất.
- Cắt nhỏ dữ liệu đầu vào. Với ảnh, AI chia tấm ảnh thành nhiều ô vuông nhỏ. Với âm thanh, nó chia đoạn ghi âm thành nhiều lát cắt thời gian ngắn. Với chữ, nó vẫn tách thành các token như AI văn bản thông thường. Nếu bạn chưa quen khái niệm token, có thể đọc thêm bài token là gì.
- Biến mỗi mảnh nhỏ thành một dãy số. Mỗi ô ảnh, mỗi lát âm thanh, mỗi token chữ đều được quy đổi thành một dãy số gọi là embedding, kiểu như một "mã định danh ý nghĩa". Bài embedding là gì giải thích kỹ hơn phần này.
- Đưa tất cả vào cùng một không gian chung. Nhờ bước 2, một tấm ảnh con mèo và chữ "con mèo" được quy về các dãy số nằm gần nhau trong cùng một không gian. Đây là điểm mấu chốt giúp AI "nối" được hình ảnh với ngôn ngữ.
- Một bộ não duy nhất xử lý tất cả. Thay vì có một AI riêng lo ảnh, một AI riêng lo chữ rồi ghép kết quả lại, hệ thống multimodal dùng chung một mô hình để suy luận trên toàn bộ dữ liệu cùng lúc, giống cách não người không tách rời việc nhìn và việc nghĩ.
- Trả lời bằng chữ (hoặc đôi khi bằng ảnh, giọng nói). Sau khi hiểu hết các mảnh ghép, AI tổng hợp lại thành câu trả lời. Nếu bạn từng thắc mắc lúc nào AI "nghĩ kỹ hơn" trước khi trả lời, bước suy luận này liên quan đến cơ chế được nói tới trong bài chế độ suy luận (reasoning) của AI.
 Điều này có ý nghĩa gì với bạn
Khả năng đa phương thức mở ra nhiều cách dùng AI mà trước đây bạn phải tự gõ lại mọi thứ thành chữ:
- Chụp ảnh thay vì gõ tay. Gặp một tờ hóa đơn, một bảng biểu hay một trang sách, bạn chỉ cần chụp ảnh rồi hỏi "tóm tắt nội dung này giúp tôi" hoặc "tổng các số trong hóa đơn là bao nhiêu". AI đọc trực tiếp từ ảnh, không cần bạn nhập liệu thủ công.
- Gửi ảnh chụp màn hình lỗi để hỏi cách sửa. Thay vì mô tả lỗi bằng lời, bạn chụp màn hình thông báo lỗi và hỏi thẳng "lỗi này do đâu, sửa thế nào". AI nhìn ảnh và hiểu ngữ cảnh nhanh hơn nhiều so với bạn mô tả lại bằng chữ.
- Dùng giọng nói thay vì gõ phím. Trên điện thoại, bạn có thể nói trực tiếp câu hỏi dài thay vì gõ, AI chuyển giọng nói thành hiểu biết ngay mà không cần bước chuyển âm thanh sang văn bản tách riêng.
Biết được điều này, khi chọn công cụ AI, bạn nên để ý xem nó có hỗ trợ gửi ảnh, ghi âm hay không, vì đó là dấu hiệu của một AI đa phương thức thực sự, chứ không chỉ là AI văn bản gắn thêm tính năng đọc ảnh bên ngoài.
 Hiểu lầm thường gặp
- Hiểu lầm: AI multimodal luôn xem được cả video dài. Thực tế nhiều AI hiện nay xử lý tốt ảnh tĩnh và audio ngắn, nhưng xem được một video dài nhiều giờ với đầy đủ chi tiết âm thanh lẫn hình ảnh phức tạp hơn nhiều, thường phải cắt video thành các khung hình rời rạc trước khi đưa vào AI.
- Hiểu lầm: AI đọc ảnh là "nhìn" giống hệt con người. AI không có mắt, nó phân tích các ô điểm ảnh và tìm ra mẫu hình quen thuộc dựa trên dữ liệu đã học. Vì vậy đôi khi nó đọc sai những chữ viết tay khó, hoặc hiểu nhầm một biểu đồ phức tạp.
- Hiểu lầm: mọi AI đều đa phương thức như nhau. Mức độ hỗ trợ ảnh, âm thanh, video khác nhau khá nhiều giữa các mô hình và các gói sử dụng. Có AI chỉ nhận ảnh, có AI nhận thêm cả âm thanh, bạn nên kiểm tra tính năng cụ thể của công cụ mình đang dùng.
 Câu hỏi thường gặp
AI đa phương thức có cần internet để xem ảnh không? Có, với hầu hết các chatbot phổ biến hiện nay, ảnh và âm thanh bạn gửi lên đều được xử lý trên máy chủ của nhà cung cấp, không phải xử lý ngay trên điện thoại hay máy tính của bạn.
Tôi có thể gửi ảnh chụp tài liệu nhạy cảm cho AI không? Nên cân nhắc kỹ, vì ảnh bạn gửi lên có thể được lưu lại để cải thiện mô hình tùy theo chính sách của từng nhà cung cấp. Với thông tin nhạy cảm như giấy tờ cá nhân, hợp đồng quan trọng, tốt nhất nên che các chi tiết riêng tư trước khi gửi.
AI đa phương thức có hiểu được chữ viết tay không? Có thể, nhưng độ chính xác phụ thuộc vào độ rõ ràng của nét chữ. Chữ viết tay gọn gàng thường được đọc tốt, chữ viết tắt hoặc nguệch ngoạc dễ bị đọc sai.
Vì sao trước đây AI chỉ đọc được chữ mà giờ đọc được cả ảnh? Vì các mô hình mới được huấn luyện thêm trên một lượng lớn dữ liệu ảnh và âm thanh đi kèm mô tả bằng chữ, giúp AI học được mối liên hệ giữa hình ảnh, âm thanh và ngôn ngữ, giống như bước 1 đến 3 ở phần "Nó hoạt động thế nào" phía trên.
Tôi nên dùng AI multimodal khi nào thay vì AI văn bản thông thường? Bất cứ khi nào dữ liệu gốc của bạn không phải là chữ sẵn có, ví dụ ảnh chụp, bản ghi âm cuộc họp, hay một đoạn video ngắn. Nếu dữ liệu đã là văn bản thuần, AI văn bản thông thường vẫn xử lý tốt và thường nhanh hơn.
Nếu bạn mới bắt đầu tìm hiểu AI nói chung, bài AI là gì và bài mô hình ngôn ngữ lớn (LLM) là gì là hai điểm khởi đầu tốt trước khi tìm hiểu sâu hơn về đa phương thức.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 Context caching là gì? Vì sao dùng lại ngữ cảnh giúp AI nhanh và rẻ hơn