Mô Hình Ngôn Ngữ Lớn (LLM) Là Gì? AI Đoán Chữ Tiếp Theo Như Thế Nào
📺 Xem bản video 2 phút
 Mô hình ngôn ngữ lớn (LLM) là gì? AI đoán chữ tiếp theo như thế nào
Mô hình ngôn ngữ lớn, viết tắt là LLM (Large Language Model), là một chương trình AI được huấn luyện bằng cách đọc một lượng văn bản khổng lồ, để rồi học được cách đoán xem từ tiếp theo trong một câu nên là từ gì. Nghe đơn giản vậy thôi, nhưng khi lặp lại việc đoán từng chữ hàng tỷ lần với một khối dữ liệu đủ lớn, nó tạo ra thứ chúng ta gọi là ChatGPT, Claude hay Gemini. Hiểu được nguyên lý này, bạn sẽ bớt bất ngờ trước cả những câu trả lời thông minh lẫn những lúc AI trả lời sai một cách rất tự tin.
 Hiểu nhanh bằng ví dụ đời thường
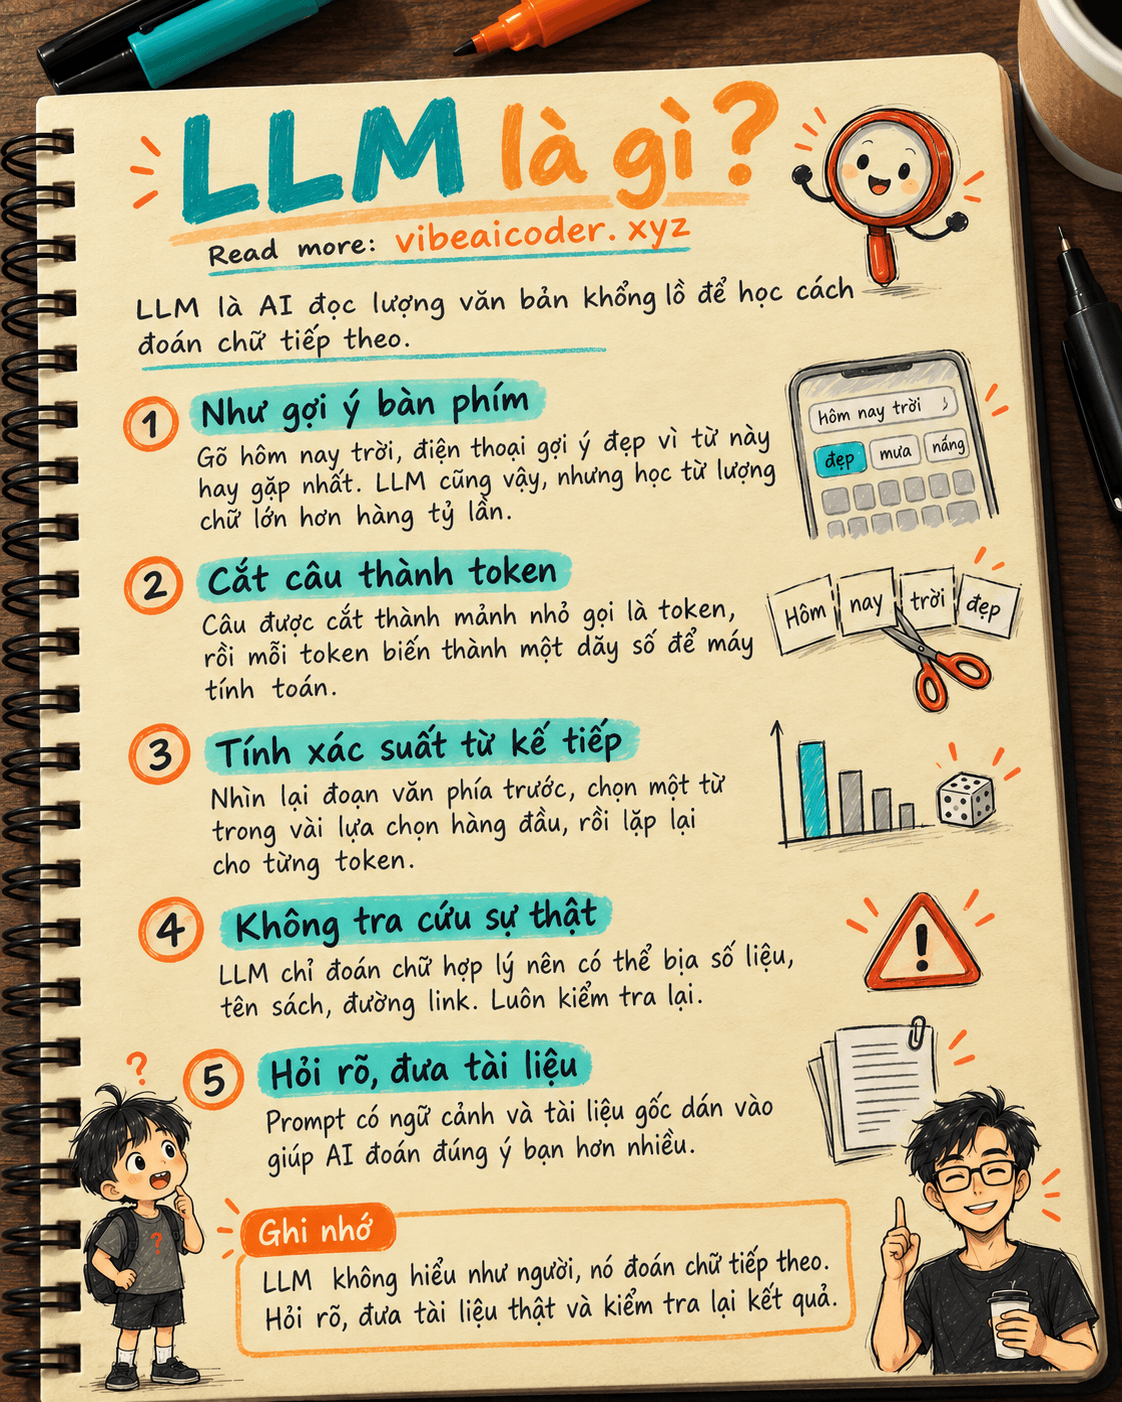
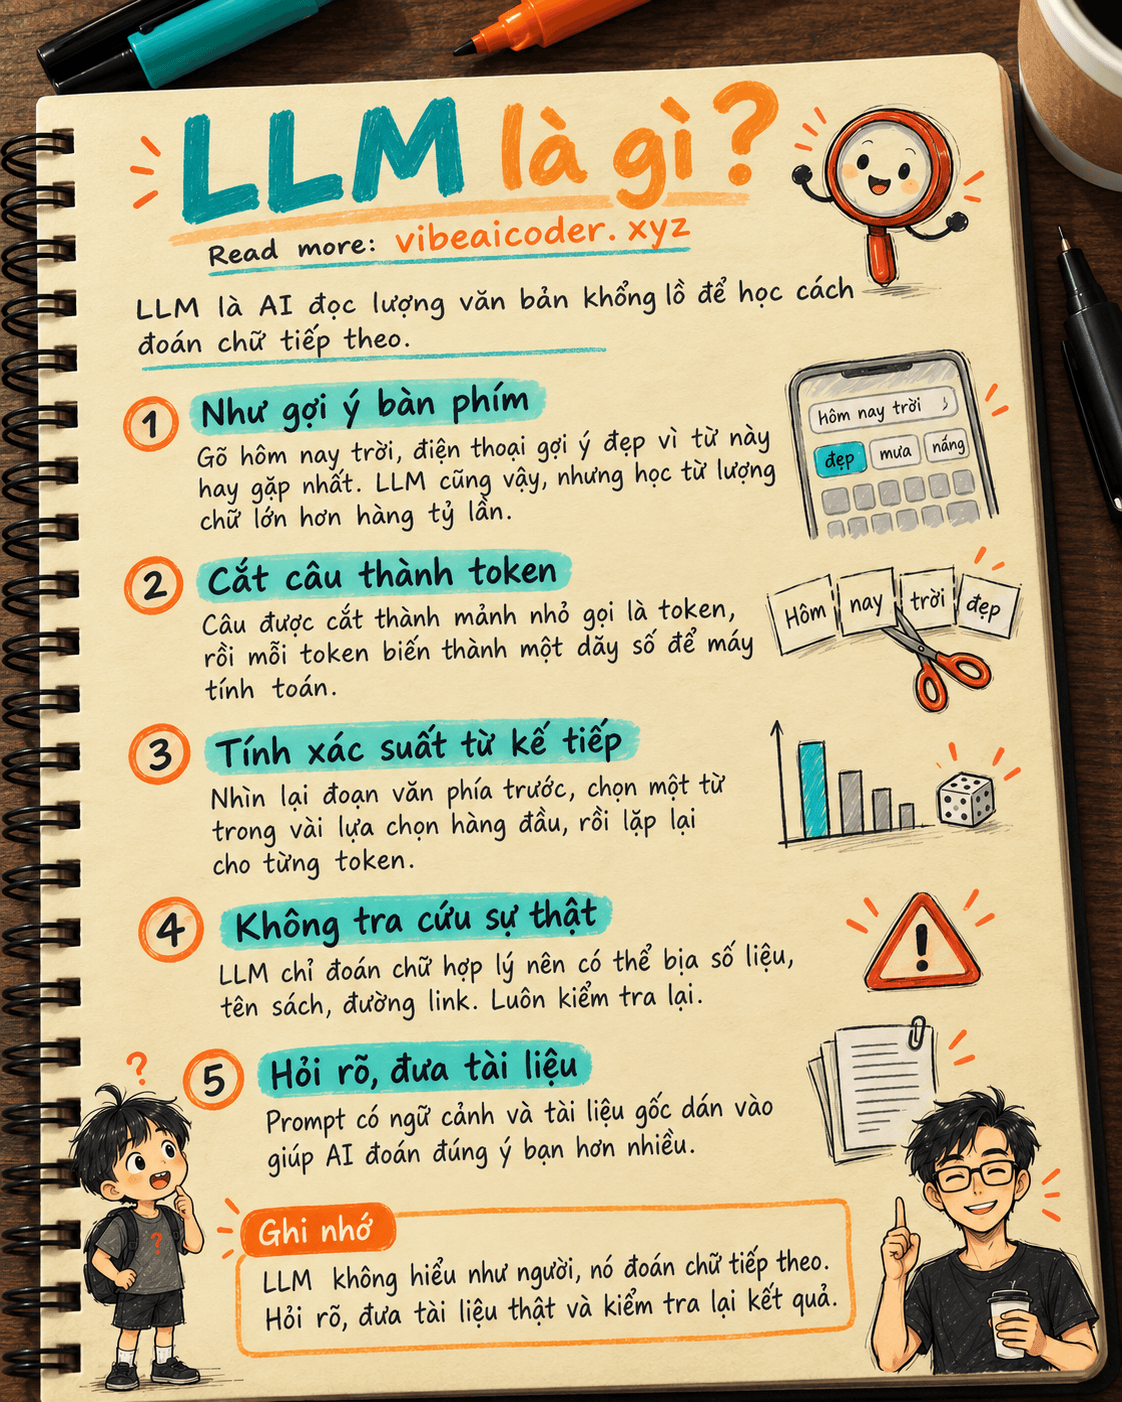
Hãy tưởng tượng bạn chơi trò nhắn tin gợi ý từ trên điện thoại: bạn gõ "Hôm nay trời" và điện thoại gợi ý sẵn ba từ tiếp theo là "đẹp", "mưa", "nóng". Điện thoại không "hiểu" thời tiết hôm nay thực sự thế nào, nó chỉ nhớ rằng trong hàng triệu tin nhắn mà người dùng từng gõ, sau cụm "hôm nay trời" thì từ "đẹp" xuất hiện nhiều nhất.
LLM hoạt động theo đúng nguyên lý đó, chỉ khác là nó được huấn luyện trên một lượng văn bản lớn hơn gợi ý bàn phím điện thoại hàng tỷ lần: sách, báo, trang web, tài liệu, đoạn hội thoại. Và thay vì chỉ đoán ba từ ngắn, nó có thể đoán nối tiếp hàng trăm từ liền mạch, đủ để viết ra một email, một đoạn code hay một câu trả lời cho câu hỏi của bạn. Bạn có thể xem prompt là gì để hiểu thêm cách "ra lệnh" cho bộ đoán chữ khổng lồ này.
 Nó hoạt động thế nào
Quá trình bên trong một LLM chạy qua vài bước chính, viết đơn giản để dễ hình dung:
- Chia câu thành các mảnh nhỏ gọi là token. Máy không đọc từng chữ cái như người, nó cắt câu thành những mảnh nhỏ (có thể là một từ, một phần của từ, hoặc dấu câu). Bạn có thể đọc thêm ở bài token là gì trong AI nếu muốn hiểu kỹ hơn phần này.
- Biến mỗi token thành một dãy số. Đây là bước AI "dịch" chữ sang ngôn ngữ của máy tính, để nó có thể tính toán được mức độ liên quan giữa các từ.
- Nhìn lại toàn bộ đoạn văn phía trước (trong giới hạn bộ nhớ của nó) để tính xác suất. Với mỗi vị trí, mô hình tính xem trong hàng chục nghìn từ có thể xuất hiện tiếp theo, từ nào có xác suất cao nhất dựa trên những gì nó đã học. Giới hạn "nhìn lại được bao xa" chính là cái mà bài context window là gì đã giải thích, đó là lý do AI đôi khi "quên" giữa cuộc trò chuyện dài.
- Chọn một từ dựa trên xác suất đó, rồi lặp lại. Mô hình không nhất thiết luôn chọn từ có xác suất cao nhất, đôi khi nó chọn ngẫu nhiên có cân nhắc trong vài lựa chọn hàng đầu, để câu trả lời không bị lặp đi lặp lại một kiểu. Mức độ "liều" này chính là temperature trong AI.
- Lặp lại toàn bộ quá trình cho từng token một, cho đến khi câu trả lời hoàn chỉnh. Mỗi lần chỉ đoán một mảnh nhỏ, nhưng lặp lại hàng trăm lần thì thành cả một đoạn văn mạch lạc.
Điều quan trọng cần nhớ: suốt quá trình này, mô hình không tra cứu một "cuốn từ điển sự thật" nào cả. Nó chỉ đang dự đoán từ nào hợp lý nhất dựa trên những gì nó đã đọc khi huấn luyện. Đó cũng là lý do nó có thể viết văn rất trôi chảy nhưng đôi khi bịa ra thông tin sai, hiện tượng được gọi là AI ảo giác.
 Điều này có ý nghĩa gì với bạn
Hiểu nguyên lý "đoán chữ tiếp theo" giúp bạn dùng AI thực tế hơn, thay vì xem nó như một cỗ máy biết tuốt:
- Viết prompt rõ ràng, có ngữ cảnh. Vì AI chỉ đoán dựa trên những gì bạn đưa ra trước đó, câu hỏi càng mơ hồ thì nó càng phải "đoán mò" nhiều hơn. Thay vì hỏi "viết cho tôi một email", hãy viết "viết email xin nghỉ phép 2 ngày, gửi cho quản lý, giọng lịch sự, có nêu lý do khám sức khỏe định kỳ". Càng nhiều ngữ cảnh, xác suất đoán đúng ý bạn càng cao.
- Không tin tuyệt đối vào số liệu hay trích dẫn AI đưa ra. Vì bản chất là đoán chữ hợp lý chứ không phải tra cứu sự thật, những con số, tên sách, đường link mà AI đưa ra có thể bị bịa. Luôn kiểm tra lại trước khi dùng cho việc quan trọng, nhất là trong công việc hay học tập.
- Cung cấp tài liệu gốc khi cần độ chính xác cao. Nếu bạn dán sẵn đoạn văn bản, bảng số liệu hay tài liệu thật vào cuộc trò chuyện, AI sẽ đoán chữ tiếp theo dựa trên chính tài liệu đó thay vì chỉ dựa vào trí nhớ mơ hồ từ lúc huấn luyện, nên câu trả lời đáng tin hơn nhiều.
 Hiểu lầm thường gặp
- "AI hiểu nghĩa như con người." Thực ra mô hình không "hiểu" theo nghĩa có ý thức, nó chỉ tính toán xác suất giữa các token dựa trên lượng văn bản khổng lồ đã học. Kết quả nhiều khi giống hệt một câu trả lời "hiểu biết", nhưng cơ chế bên trong hoàn toàn là thống kê.
- "LLM càng lớn thì luôn trả lời đúng hơn." Mô hình lớn hơn (nhiều tham số hơn, học nhiều dữ liệu hơn) thường giỏi hơn, nhưng vẫn có thể đoán sai nếu câu hỏi mơ hồ, chủ đề hiếm gặp trong dữ liệu huấn luyện, hoặc thông tin đã thay đổi sau thời điểm nó được huấn luyện.
- "AI biết mọi chuyện đang diễn ra hiện tại." Một LLM thuần túy chỉ biết đến những gì có trong dữ liệu huấn luyện, nó không tự động cập nhật tin tức mới trừ khi được kết nối thêm công cụ tra cứu web hoặc tài liệu riêng (kỹ thuật RAG).
 Câu hỏi thường gặp
LLM khác gì với AI nói chung? AI là khái niệm rộng chỉ mọi hệ thống máy tính mô phỏng khả năng "thông minh". LLM chỉ là một nhánh của AI, chuyên về xử lý và tạo ra ngôn ngữ, đứng sau phần lớn các chatbot bạn đang dùng. Bạn có thể đọc thêm ở bài AI là gì để thấy bức tranh tổng quát hơn.
Vì sao cùng một câu hỏi, AI trả lời khác nhau mỗi lần? Vì bước chọn từ tiếp theo không phải lúc nào cũng chọn từ có xác suất cao nhất tuyệt đối, mà có một phần ngẫu nhiên có kiểm soát. Đây cũng là lý do bạn hỏi lại cùng một câu hai lần có thể nhận hai câu trả lời hơi khác nhau.
LLM có "suy nghĩ" trước khi trả lời không? Về bản chất là không, nó tạo từng chữ một theo kiểu đoán nối tiếp. Nhưng các mô hình "suy luận" đời mới được huấn luyện thêm để viết ra các bước trung gian trước khi đưa ra câu trả lời cuối, giúp kết quả chính xác hơn với các bài toán phức tạp.
ChatGPT, Claude, Gemini có phải đều là LLM không? Đúng. Đó đều là các sản phẩm được xây dựng trên nền một hoặc nhiều mô hình ngôn ngữ lớn, cộng thêm giao diện trò chuyện, bộ nhớ, và các công cụ hỗ trợ khác để biến mô hình thô thành một trợ lý dễ dùng.
Tại sao LLM đôi khi bịa thông tin thay vì nói "tôi không biết"? Vì cơ chế của nó là luôn cố đoán ra từ tiếp theo hợp lý nhất, ngay cả khi không chắc chắn, thay vì được lập trình để dừng lại và thừa nhận không biết. Đây chính là nguồn gốc của hiện tượng AI ảo giác đã nhắc ở trên.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 GPU Là Gì? Vì Sao AI Cần Chip Đồ Họa Mạnh Để Huấn Luyện Và Chạy