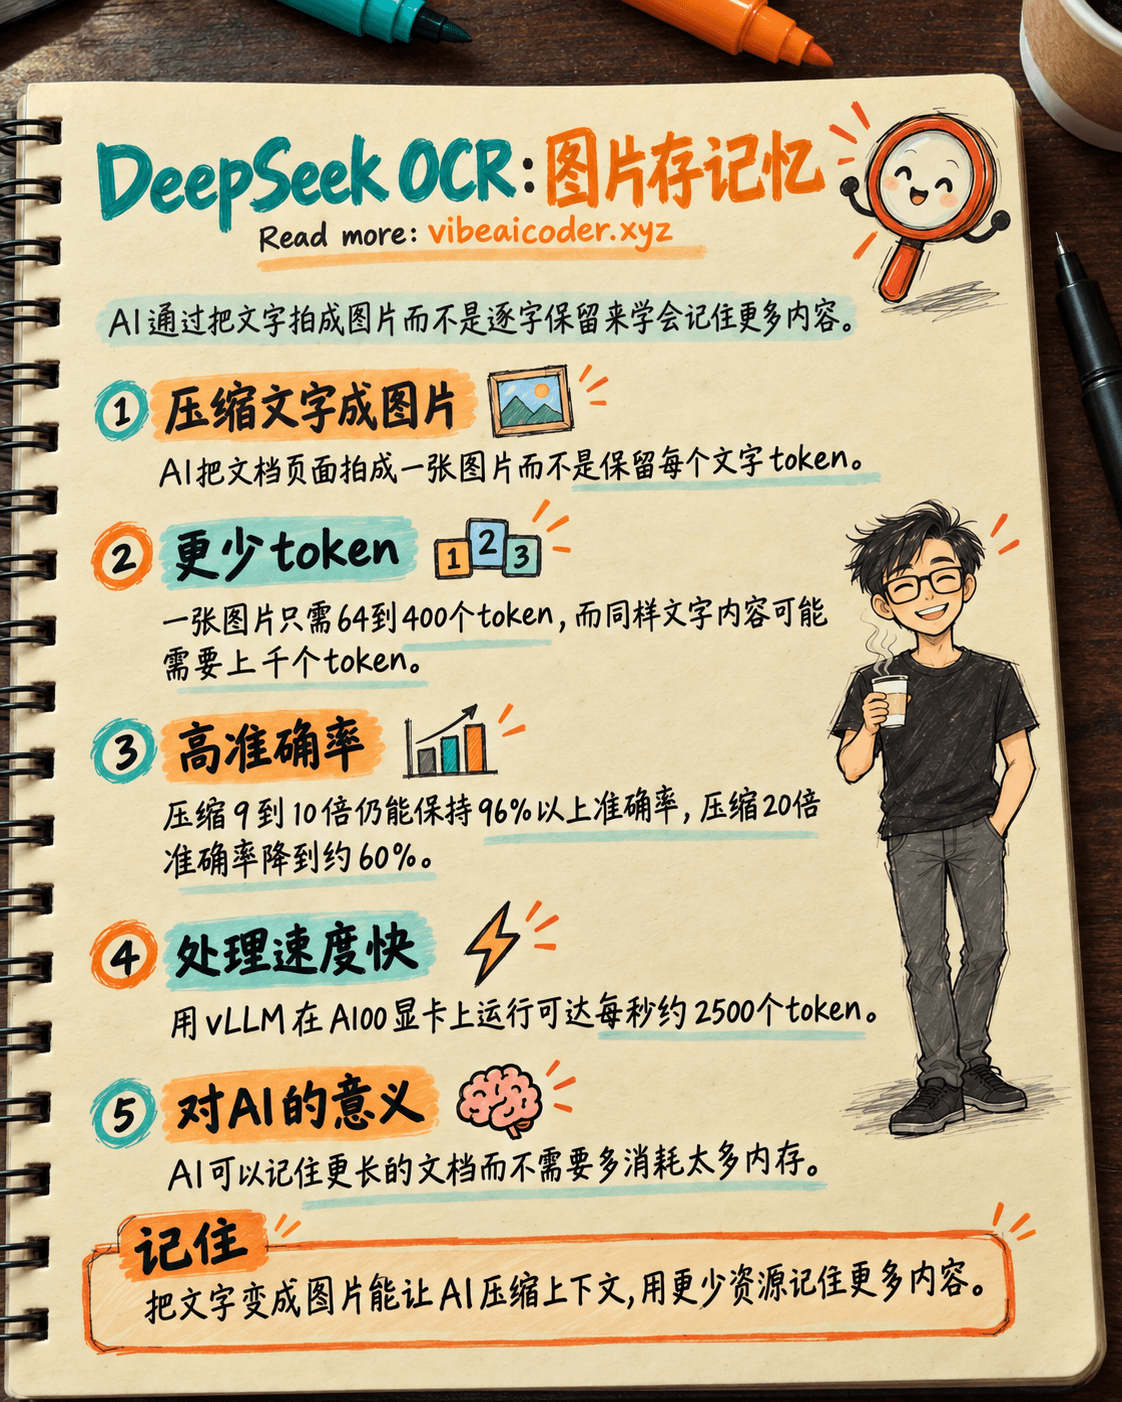
DeepSeek OCR:把文字压缩成图片,让AI记住更多
DeepSeek刚刚公布了一种解决AI最大瓶颈之一的意外方法:把文字变成图片让模型重新读取,而不是把每个字都保留为文本。
 发生了什么
这几天AI圈都在讨论一个名字听起来很普通的模型:DeepSeek OCR。听起来像是一个从图片里扫描文字的普通工具,但它真正解决的问题要大得多:AI的记忆问题。频道Two Minute Papers专门做了一期视频,解释为什么这可能是今年大语言模型(LLM,也就是ChatGPT或Claude背后的那类AI)领域最有意思的想法之一。
DeepSeek要解决的问题,对用过AI一段时间的人来说并不陌生:对话或文档越长,AI需要的资源就越多来记住从头开始的一切,最终它不得不裁剪或忘记前面的内容。这就是**上下文窗口(context window)**的限制,也就是AI用来跟踪对话或你输入的文档的临时记忆。
 把文字压缩成图片,听起来奇怪却很合理
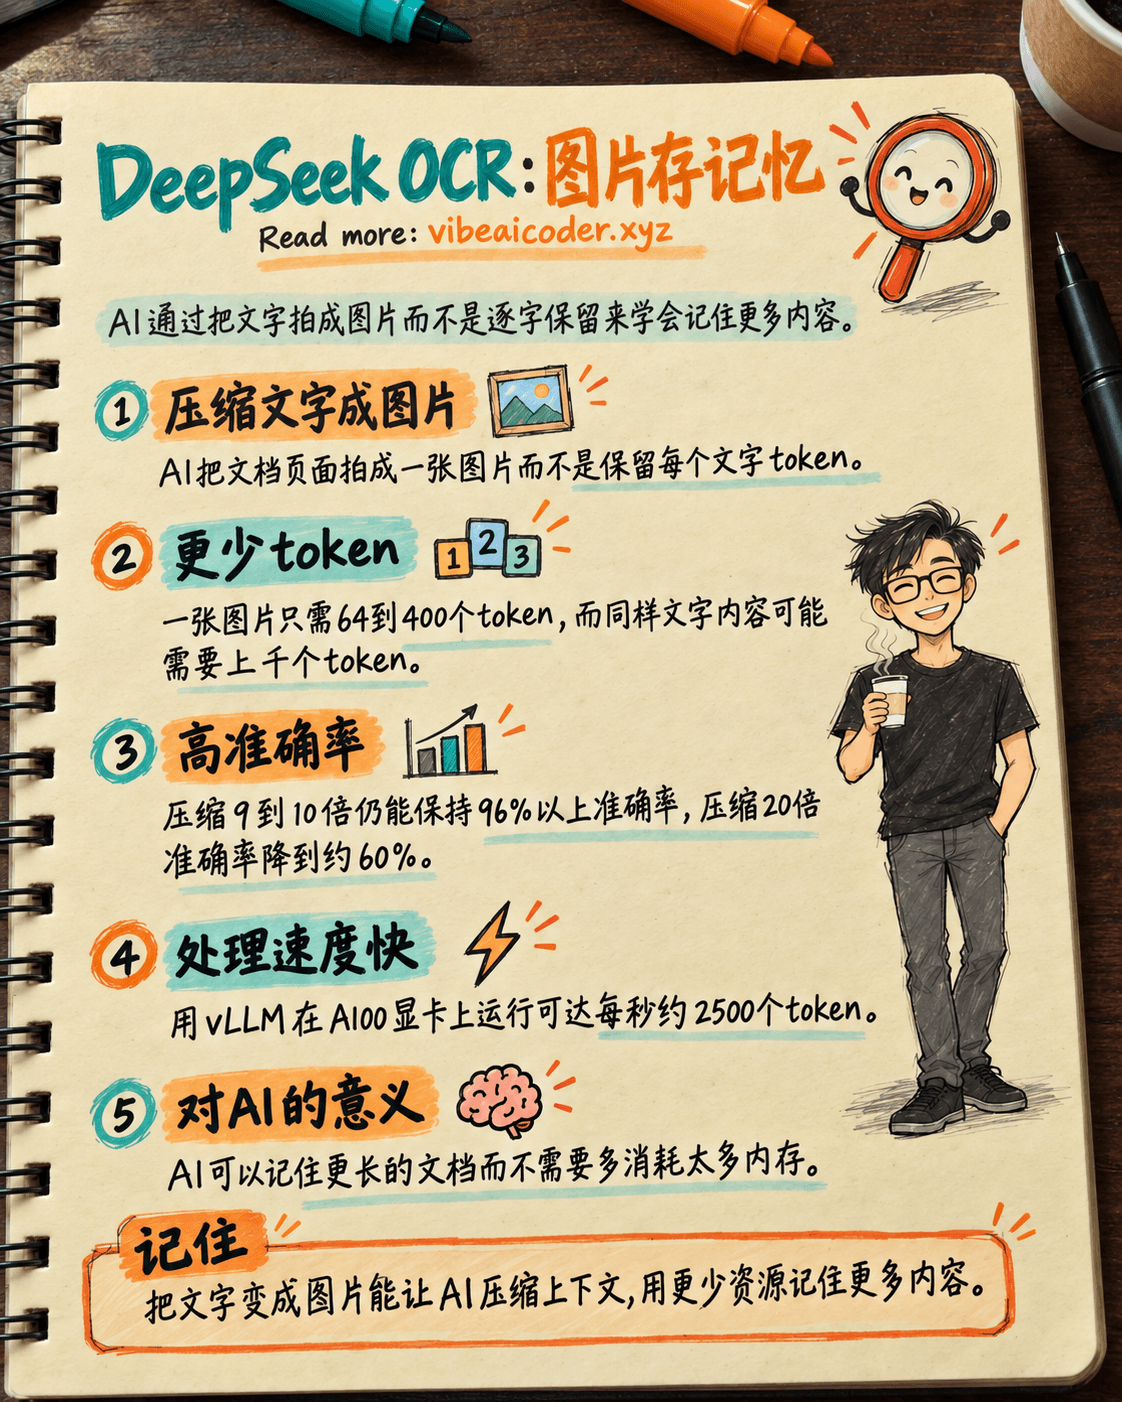
DeepSeek OCR的做法出人意料:它不是把文字保留为文本,而是把这段文字拍成一张图片,然后让AI从这张图片里读懂内容。听起来有点本末倒置,因为把文字变成图片通常会让数据变得更重。但对AI来说情况不同。
当AI处理文字时,每个词或词的片段都要被拆分成一个单独的"token"才能计算,几千页的文档会产生几十万个token。而当AI处理一张图片时,无论图片里有多少文字,它只需要固定数量的token来描述整张图片。DeepSeek OCR正是利用了这个差距:它使用一个专门的视觉编码器(结合两个小型图像识别组件)来"看"文档页面,并在语言模型读取内容之前把它压缩成很少的token。
该模型在"拍摄"文档页面时支持多种细节级别,从简单页面只需64个token,到需要保留更多细节的页面需要400个token,而同样数量的文字如果保持文本形式,可能需要几千个token。
 数字说明一切
根据DeepSeek公布的数据,当文字以大约9到10倍的比例压缩成图片时(也就是把原始文字的token数量压缩到大约十分之一),模型读回内容的准确率仍然超过96%。如果压缩比例进一步提高到大约10到12倍,准确率依然保持在90%左右。只有当压缩比例被推高到大约20倍时,准确率才会降到约60%,也就是说AI开始读错或漏掉部分内容。
简单来说:对于长文档,AI可以用比以前少得多的内存"记住"相当数量的内容,最多可能减少约20倍,只要能接受在最高压缩比例下的一点准确率损失。研究团队还用vLLM在一块A100显卡上测试了模型,处理PDF文档时达到了每秒约2500个token的处理速度,对于批量处理大量文档来说是相当不错的数字。
 这对你意味着什么
如果你曾经发现AI"忘记"了长对话最开始的部分,或者无法完整总结一份页数太多的文档,这正是这种方法试图解决的局限。当AI公司开始应用这种基于图像的上下文压缩方式后,长远来看你可能会看到:
- 可以给AI输入更长的文档(合同、报告、书籍)而不用担心内容中途被截断。
- 可以和AI助手保持更长的对话历史,而处理成本不会大幅上升。
- 得到更快的回复,因为AI花在"重新读取"已说内容上的精力更少。
这也说明了解AI是什么不只是输入问题那么简单,了解背后的技术限制也能帮助你更有效地使用AI,比如知道什么时候该把文档拆成小块,而不是一次性全部塞进去。
 需要了解的局限
这仍然是一个新模型,大部分还停留在研究和实验阶段,不一定已经被整合进你每天使用的那些主流聊天机器人里。压缩得越狠,就越容易丢失细节,所以对于合同或财务数字这类重要文档,你仍然应该自己再核对一遍,而不是完全相信AI从压缩图片里读出来的内容。你也可以阅读更多关于聊天机器人的记忆是如何运作的,了解AI为什么有时记得、有时又会忘记,并和AI如何像人一样学会遗忘做个对比,那是一种完全不同的机制,靠的是裁剪旧记忆,而不是压缩图片。
常见问题
DeepSeek OCR只是一个普通的文字扫描工具吗? 不完全是。它仍然能像普通OCR工具一样从图片里读出文字,但它的主要目标是把图片当作压缩上下文的方式,让AI更高效地处理长文档。
为什么总是提到"token"? Token是AI用来"数"和处理文字的最小单位,一个词可能会被拆成一个或几个token。模型需要处理的token越多,消耗的资源就越多,也越容易碰到内存上限。
这项技术会让AI用起来更便宜吗? 理论上会,因为处理更少的token意味着更少的计算量。但这还要看AI公司究竟何时以及如何把它用到真正的产品里。
这个方法完全是DeepSeek从零发明的吗? 通过图像压缩信息以节省内存的想法在AI研究圈里并不算全新,但DeepSeek是公开发布代码和具体数据、把这种方法做成一个真正可用的OCR模型的团队。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制