DeepSeek让AI学会像人类一样遗忘,解决高成本的记忆难题
DeepSeek让AI学会像人类一样遗忘,解决高成本的记忆难题
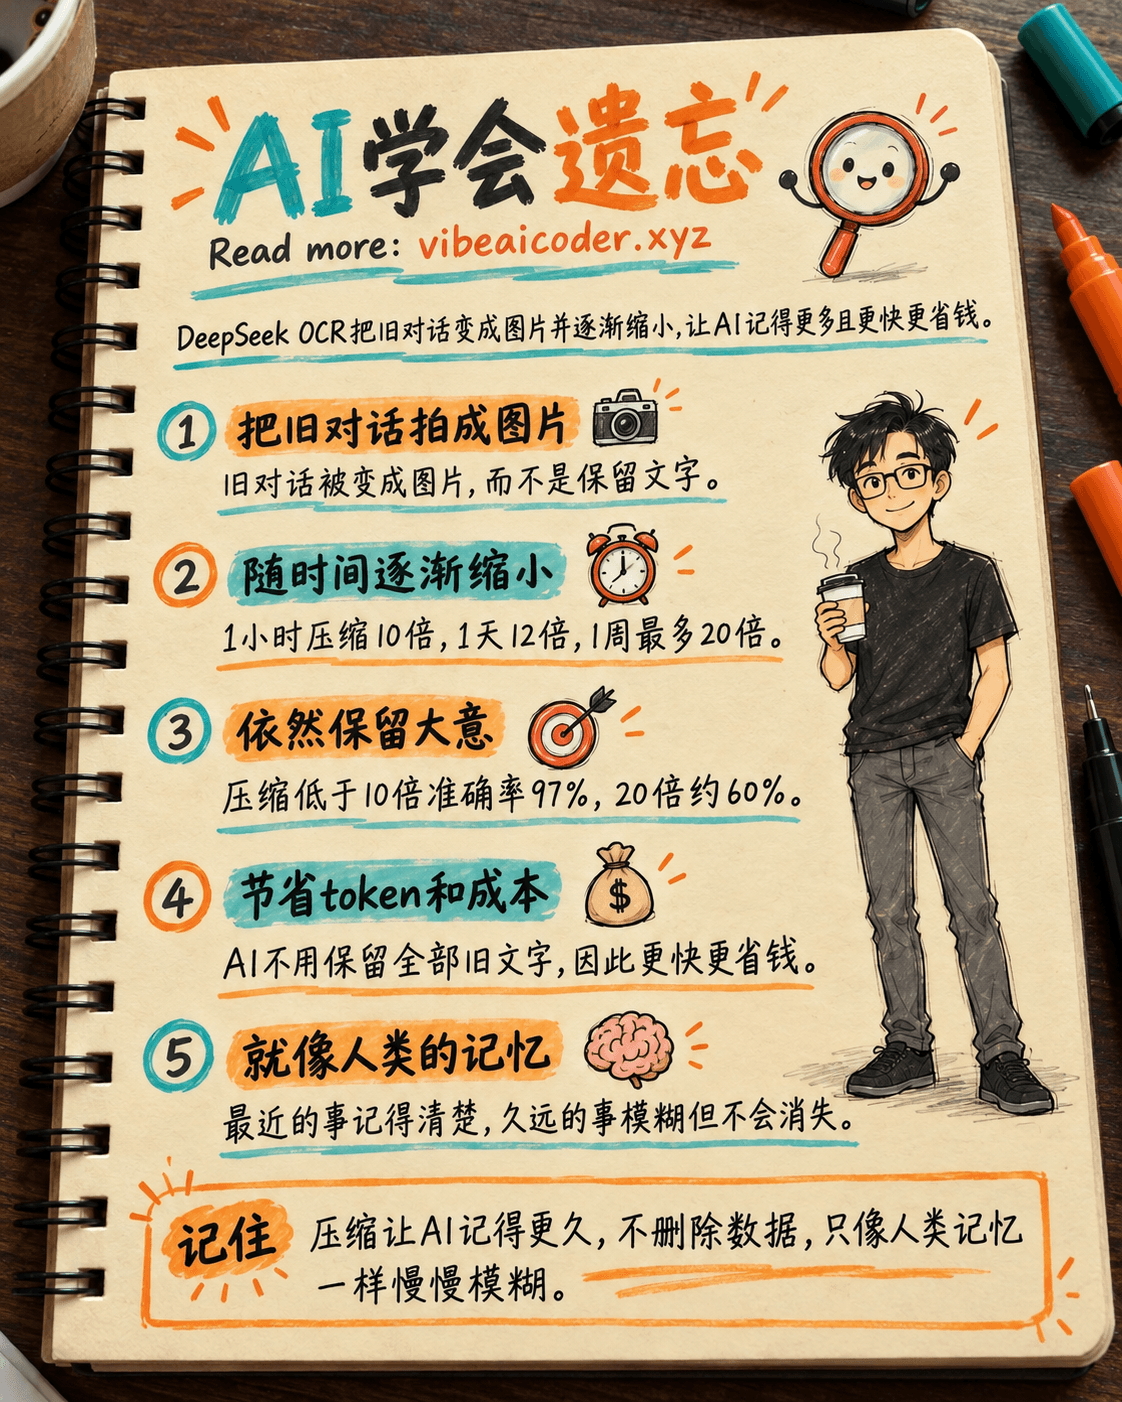
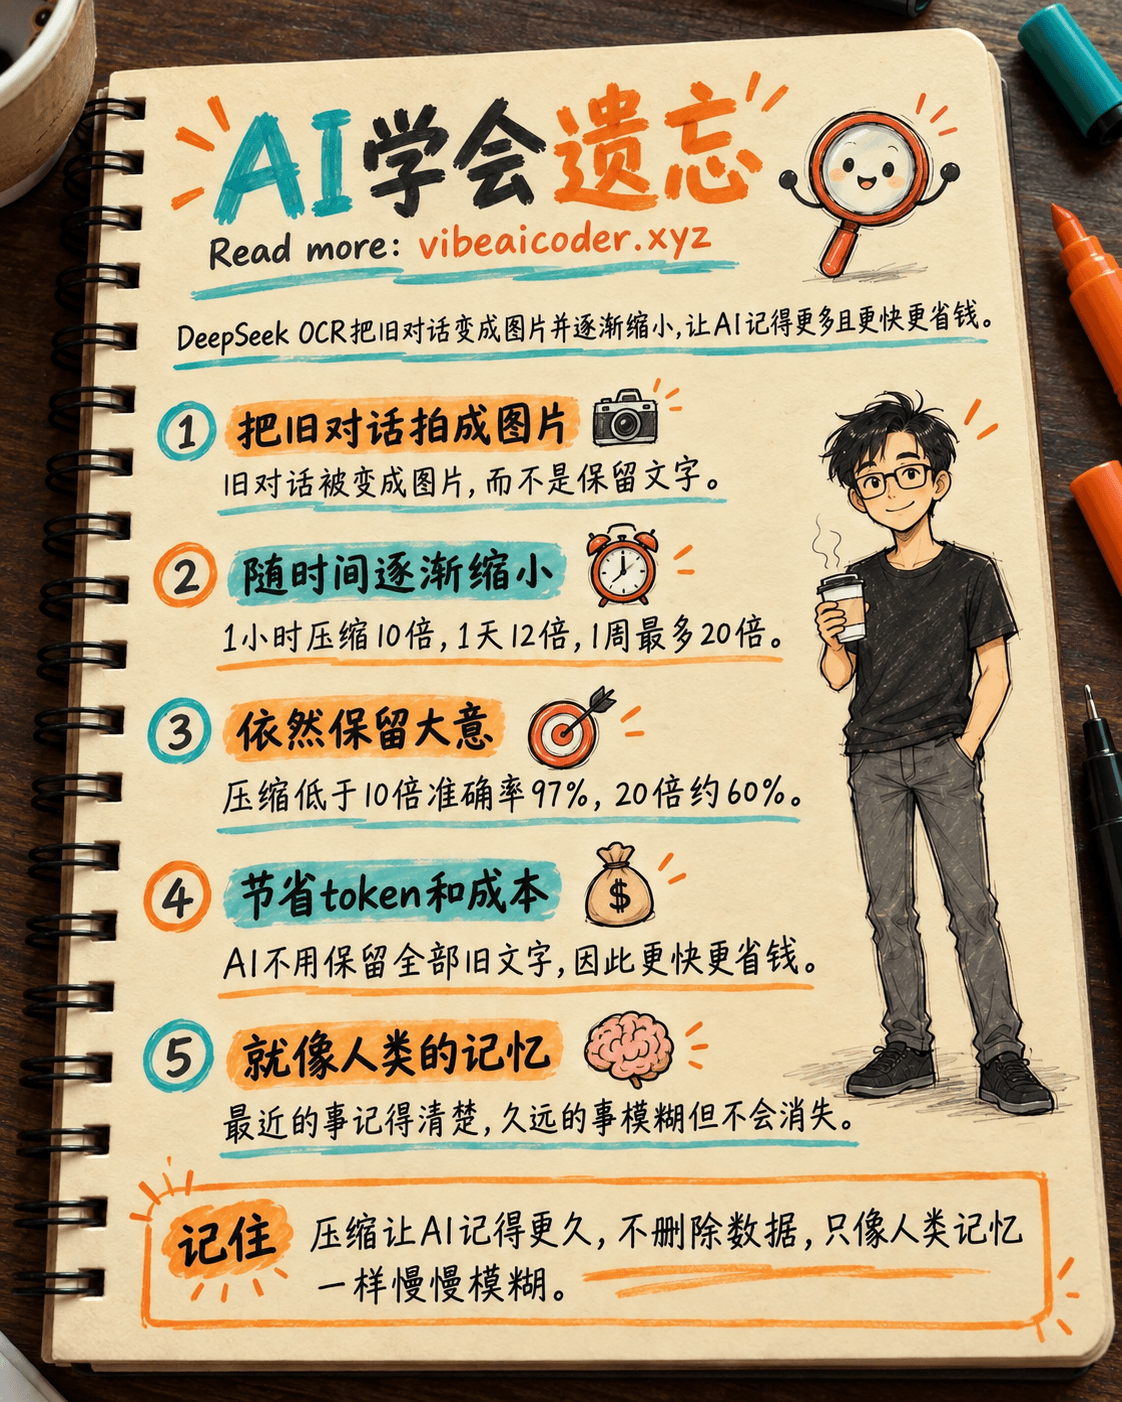
DeepSeek OCR是一项新技术,它把对话中较旧的部分变成图片,再随着时间推移逐渐缩小这些图片,就像人类的记忆会慢慢淡化一样。这样一来,AI就能记住很长的对话,而不需要以完整分辨率记住每一个字,从而节省大量token(AI用来计算文字和计费的单位)和计算成本。知名科普频道Two Minute Papers最近重新介绍了这个想法,内容来自DeepSeek的Contexts Optical Compression研究。想先了解基础概念,可以阅读我们的AI là gì。
 用生活中的例子快速理解
想象一下,你把每段对话都截图保存,而不是重新打一遍文字。一张清晰的截图几乎和原文一模一样,但如果你把这张图反复缩小,文字就会逐渐模糊,最后你只能看懂大意,看不清每一个逗号。DeepSeek OCR对AI对话中较旧的部分做的正是这件事:先把文字变成图片,再随着时间推移不断缩小这张图片,就像你清楚记得昨天发生的事,却只模糊记得去年的事一样。
 它具体是怎么运作的
- 对话中最新的部分仍以完整分辨率的文字保留,让AI能够准确回答。
- 大约一小时前的对话会被截图并压缩到中等分辨率,压缩比约为原文字的10倍。
- 大约一天前的对话会被进一步压缩,约12倍。
- 一周以上的对话压缩得最厉害,达到15到20倍,文字几乎变得模糊,但大意仍然保留。
- 在内部,DeepSeek OCR使用两个部分:一个图像读取器和一个小型解码器。图像读取器可以把整整一页文档压缩成大约100个图像token,远少于过去需要的数千个文字token。研究团队测得:压缩比低于10倍时,还原准确率高达97%,压缩到20倍时准确率降到约60%,仍足以抓住大意。
想进一步了解AI为什么会在对话中途“遗忘”,可以阅读我们的Context Window là gì和Token là gì trong AI。
 这对你意味着什么
- 更长的对话不会断线: 如果这项技术进入主流AI助手,你可以在很长的一次对话中反复提问,AI依然记得一开始聊的要点。
- 使用AI的成本更低: 因为AI不再需要保留旧对话的每一个token,成本可能下降,这和一个曾帮助AI agent节省高达80%上下文窗口token的Python库类似,只是这次换成了基于图像的方法。
- 聊天之外的用途: 研究团队表示,这项技术还可以用来批量扫描文档,仅用一块A100显卡每天就能生成超过20万页训练数据,处理PDF的速度约为每秒2500个token。
 常见的误解
- “AI遗忘意味着旧数据被删除了。” 事实:这是一种有损压缩,旧信息仍然存在,只是变得模糊,就像一张被缩小的照片,而不是被删除的照片。
- “这个功能已经用在你正在用的ChatGPT或Claude里了。” 事实:这是DeepSeek的开源研究,目前主要用于文档阅读(OCR)。目前还没有任何大型AI公司宣布把这种逐渐遗忘的机制用到主流聊天机器人中。
- “把文字压缩成图片来省token是全新的想法。” 事实:通过总结旧对话来节省记忆空间的想法早就存在,DeepSeek OCR只是提出了一种基于图像的做法,压缩效果比以前的方法好得多。
常见问题
DeepSeek OCR是一款新的聊天机器人吗? 不是。它是一个专注于阅读文档和图像的模型(OCR),现在增加了光学上下文压缩机制,并不是像ChatGPT或Claude那样可以直接对话的聊天机器人。
基于图像的压缩会让AI给出错误的旧信息吗? 有可能,如果你询问很久以前对话中的一个很小的细节,准确率会下降,在最高压缩比下约为60%。但对于较新的内容或中等压缩比,准确率仍保持在97%以上。
这项技术什么时候会出现在常用的AI应用中? DeepSeek已经开源了代码和模型供开发者自行试验,但ChatGPT、Claude、Gemini等主流聊天机器人尚未宣布采用这种遗忘机制。
为什么不直接保留全部文字,压缩有什么必要? 保留一段很长对话的全部文字会消耗大量token,从而推高计算成本并拖慢响应速度。压缩可以让AI记住更多内容,同时保持速度快、成本低。
我需要懂编程才能理解这件事吗? 不需要。你只需要知道,这是一种聪明的方法,能帮助AI记住更长的对话,而不会占用太多资源,就像人脑会优先清楚地记住近期的事情,而让久远的记忆慢慢淡化一样。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制