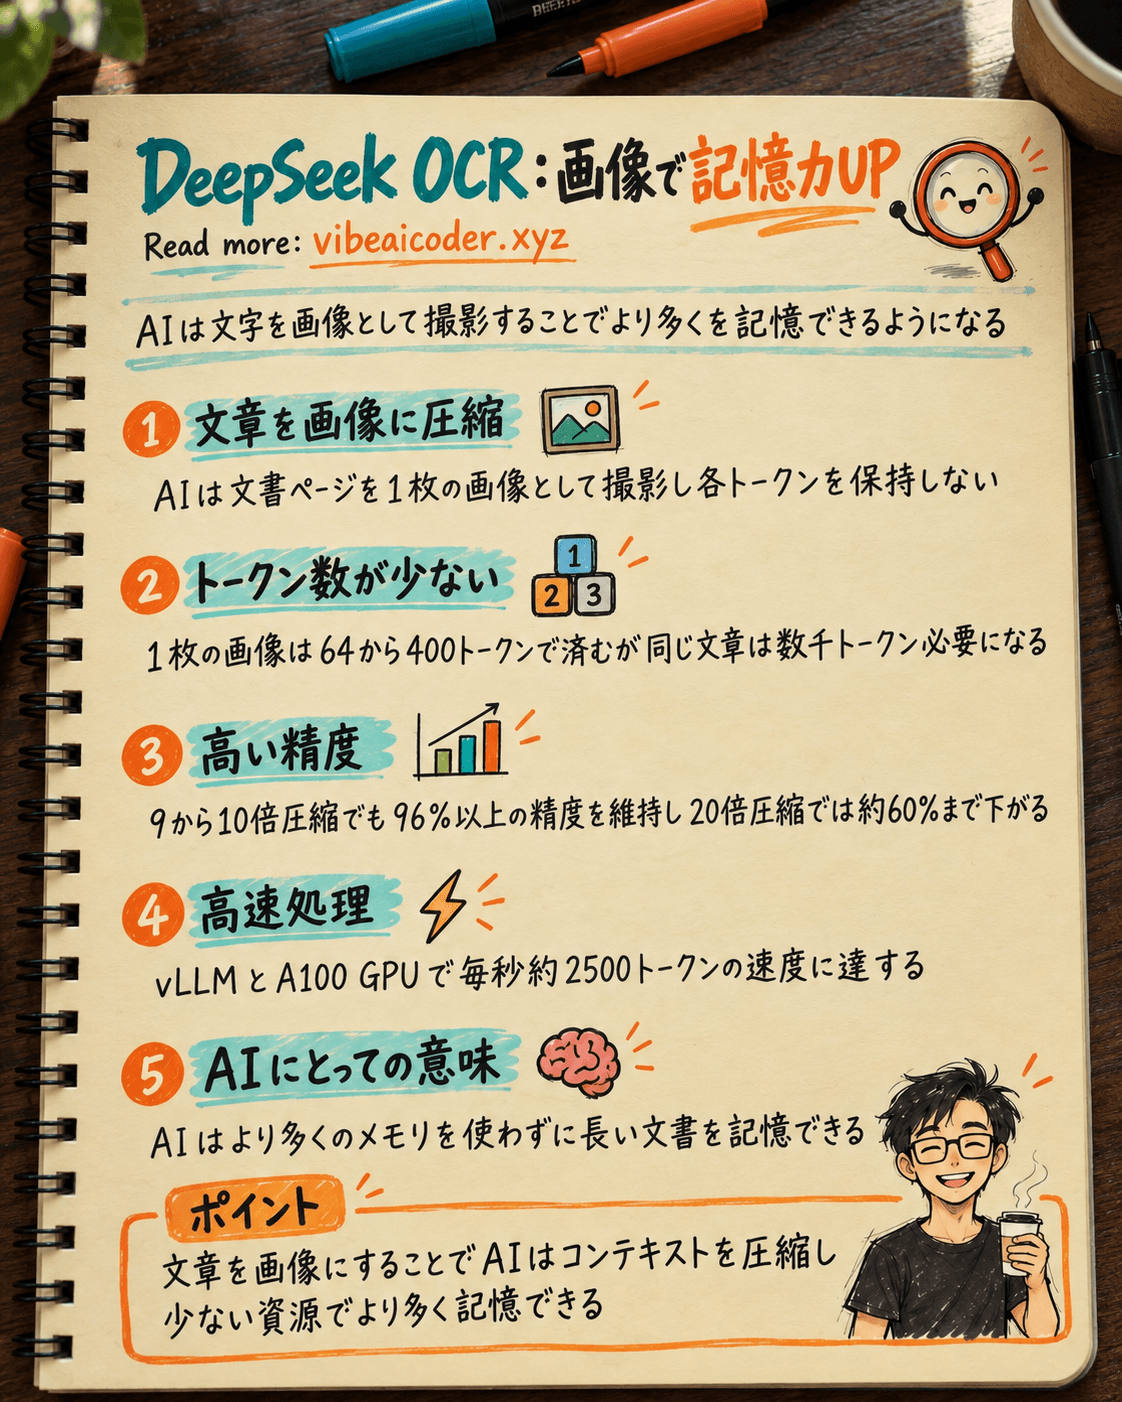
DeepSeek OCR:文章を画像に圧縮してAIの記憶力を上げる
DeepSeekが、AIの大きな壁のひとつを解決する意外な方法を発表しました。文章を一文字ずつ保持する代わりに、画像として撮影してAIに読み取らせるという方法です。
 何が起きているのか
ここ数日、AI界隈では一見ごく普通な名前のモデルが話題になっています。DeepSeek OCRです。画像から文字を読み取るだけのツールのように聞こえますが、実際に取り組んでいる課題はもっと大きなものです。AIの記憶の問題です。チャンネルTwo Minute Papersはこの話題だけで一本の動画を作り、なぜこれが今年の大規模言語モデル(LLM、ChatGPTやClaudeのようなAIの仕組み)にとって最も興味深いアイデアのひとつになり得るのかを解説しています。
DeepSeekが取り組んでいる問題は、AIをしばらく使ったことがある人なら誰でも心当たりがあるはずです。会話や文書が長くなるほど、AIは最初から全てを覚えておくためにより多くのリソースを必要とし、やがて古い部分を切り捨てたり忘れたりせざるを得なくなります。これがコンテキストウィンドウの限界です。AIが会話や入力された文書を追いかけるために使う一時的な記憶のことです。
 文章を画像に圧縮する、奇妙だが理にかなった方法
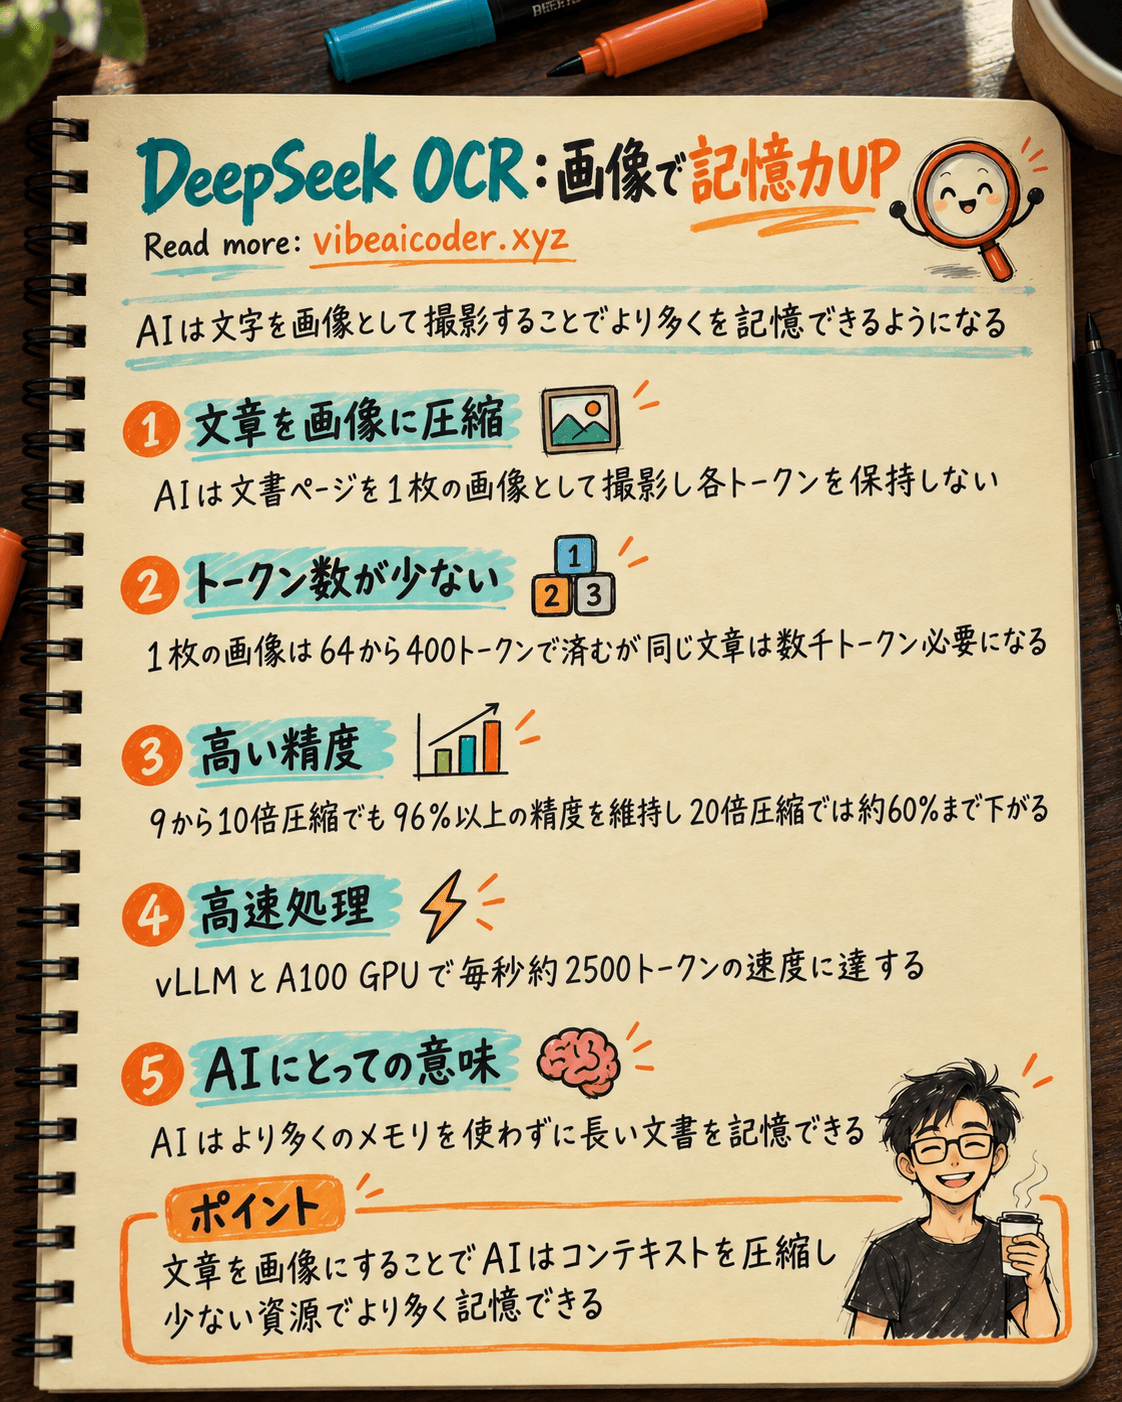
DeepSeek OCRのやり方は予想外のものです。文章をそのままテキストとして保持する代わりに、その文章を画像として撮影し、AIにその画像から内容を読み取らせます。一見すると逆効果に思えます。文章を画像に変えると、データは通常より重くなるからです。しかしAIにとっては事情が異なります。
AIが文章を処理するとき、単語や単語の断片ひとつひとつが計算のために個別の「トークン」に分割される必要があり、数千ページの文書は数十万のトークンを生み出します。一方、AIが画像を処理する場合、画像の中にどれだけ文字があろうと、画像全体を説明するために必要なトークン数は一定です。DeepSeek OCRはまさにこの差を利用しています。専用の視覚エンコーダー(2つの小型な画像認識コンポーネントを組み合わせたもの)を使って文書のページを「見て」、言語モデルがそこから内容を読み取る前に、ごく少ないトークン数に圧縮するのです。
このモデルは、文書ページを「撮影」する際に複数の詳細度をサポートしています。シンプルなページならわずか64トークン、より多くの詳細を保持したいページでは400トークンで済み、同じ量の文章をそのままテキストとして保持すると数千トークンが必要になる場合もあります。
 数字が物語るもの
DeepSeekが公開したデータによると、文章を約9倍から10倍の比率で画像に圧縮した場合(つまり元の文章のトークン数を約10分の1に圧縮した場合)、モデルは**96%を超える精度で内容を読み取ることができます。圧縮率をさらに約10倍から12倍まで上げても、精度は約90%前後を維持します。圧縮率を約20倍まで引き上げたときだけ、精度は約60%**まで下がり、AIが内容を読み間違えたり見落としたりし始めます。
簡単に言うと、長い文書に対して、AIは以前より大幅に少ないメモリで同程度の内容を「記憶」できるようになり、最大で約20分の1程度まで削減できる可能性があります。ただし最も高い圧縮率では、精度の一部をトレードオフとして受け入れる必要があります。研究チームはまた、vLLMというツールを使ってA100 GPU上でこのモデルをテストし、PDF文書の処理で毎秒約2500トークンという処理速度を達成しました。大量の文書を一括処理するには十分な数字です。
 これがあなたにとってなぜ重要なのか
長い会話の最初の部分をAIが「忘れて」しまったり、ページ数の多い文書を最後までうまく要約できなかったりした経験があるなら、この技術はまさにそうした限界を解決しようとしているものです。AI企業がこうした画像ベースのコンテキスト圧縮を取り入れ始めると、長期的には次のようなことが可能になるかもしれません。
- 契約書やレポート、書籍などより長い文書をAIに渡しても、途中で内容が切り捨てられる心配が減る。
- AIアシスタントとの会話履歴をより長く保持しても、処理コストが急に跳ね上がらない。
- AIがすでに話した内容を「読み返す」負担が減ることで、より速い応答が得られる。
これはAIとは何かを理解することが、ただ質問を入力するだけにとどまらない理由のひとつでもあります。裏側にある技術的な限界を知ることは、AIをより効果的に使う助けにもなります。たとえば、文書を一度に全て入力する代わりに、いつ小分けにすべきかを判断できるようになります。
 知っておくべき限界
これはまだ新しいモデルであり、大部分は研究段階や実験段階にとどまっています。あなたが日常的に使っているチャットボットに、すでに組み込まれているとは限りません。圧縮を強くすればするほど細かい部分を失いやすくなるため、契約書や財務数値のような重要な文書については、AIが圧縮画像から読み取った内容を全面的に信じるのではなく、自分自身でも確認することをお勧めします。チャットボットの記憶の仕組みについてさらに読んで、AIがなぜ時に覚えていて時に忘れてしまうのかを理解し、AIが人間のように忘れることを学ぶ仕組みと比較してみるのもよいでしょう。こちらは画像圧縮ではなく古い記憶を削る、全く異なる仕組みです。
よくある質問
DeepSeek OCRはただの普通の文字スキャンツールですか。 そうとも言い切れません。普通のOCRツールのように画像から文字を読み取ることはできますが、主な目的は画像をコンテキスト圧縮の手段として使い、AIが長い文書をより効率的に処理できるようにすることです。
なぜ「トークン」という言葉が何度も出てくるのですか。 トークンとは、AIが文章を「数え」、処理するための最小単位です。ひとつの単語が1つまたは複数のトークンに分割されることもあります。モデルが処理しなければならないトークンが多いほど、消費するリソースも増え、記憶の限界に達しやすくなります。
この技術でAIの利用コストは安くなりますか。 理論上はそうなります。処理するトークンが少ないほど、計算量も少なくなるからです。ただし、AI企業が実際にいつ、どのようにこれを製品に組み込むかによって大きく変わります。
この方法はDeepSeekが完全にゼロから発明したものですか。 メモリを節約するために画像を通して情報を圧縮するというアイデア自体は、AI研究の世界では全く新しいものではありません。しかしDeepSeekは、この方法を実際に動くOCRモデルの規模でコードと具体的な数値を公開したチームです。
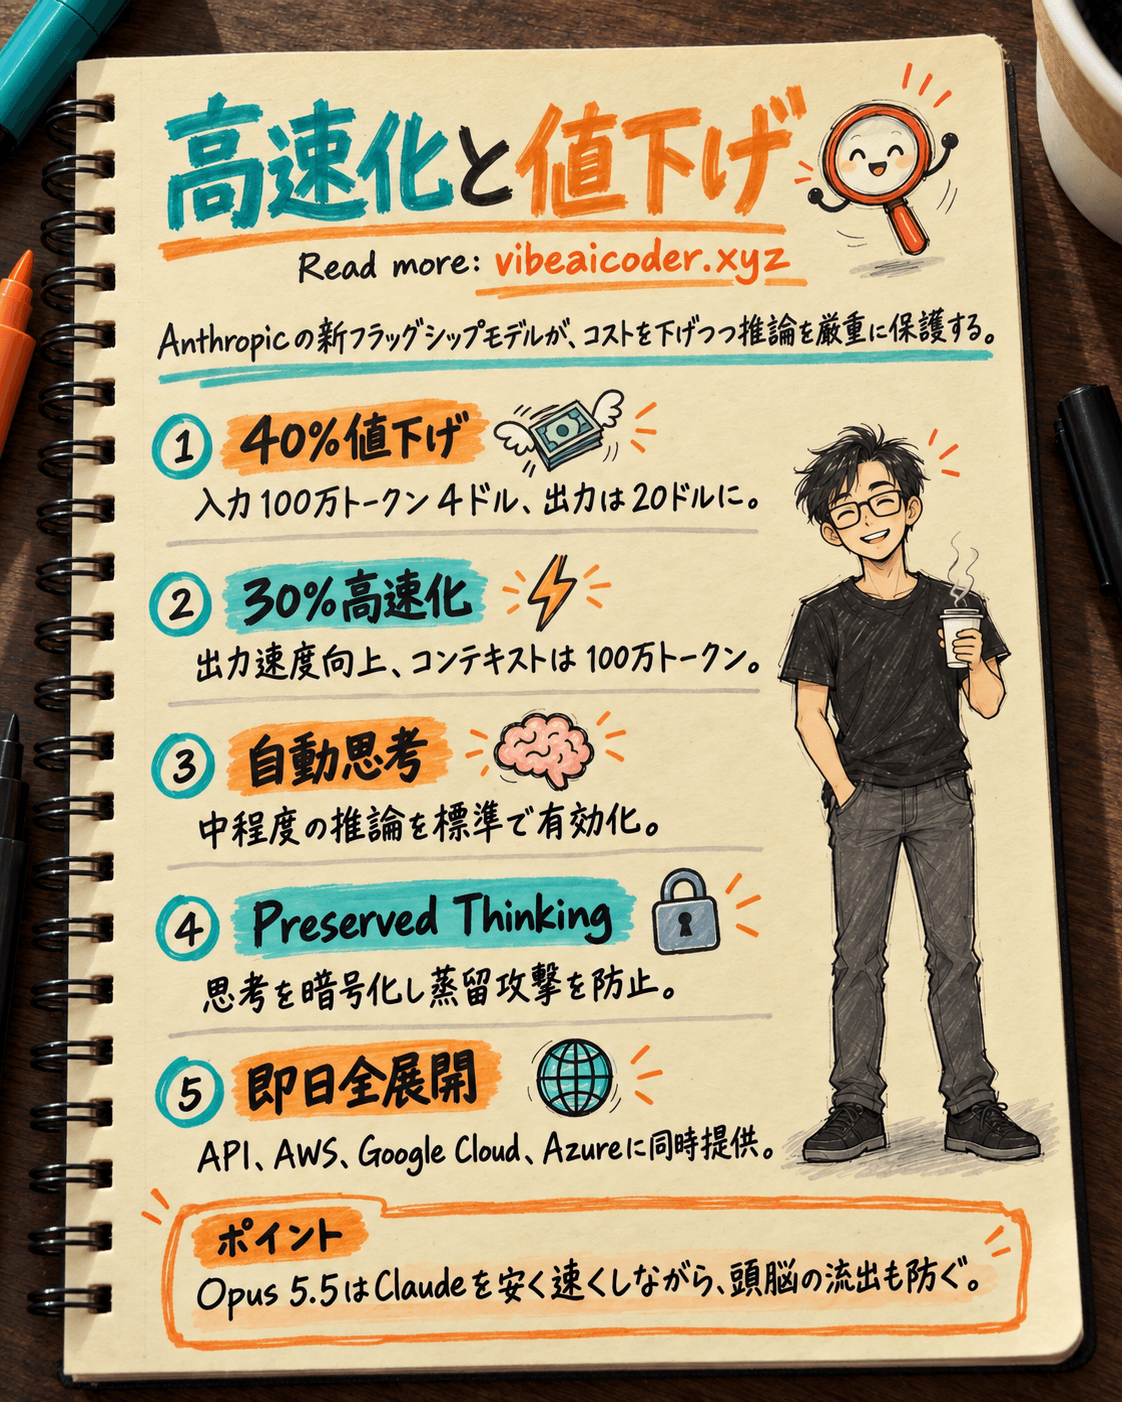
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止