DeepSeek OCR: Nén chữ thành ảnh để AI nhớ nhiều hơn
DeepSeek vừa công bố một cách giải quyết vấn đề bộ nhớ của AI nghe rất bất ngờ: biến văn bản thành ảnh để máy đọc lại, thay vì giữ nguyên từng con chữ.
 Chuyện gì đang xảy ra
Mấy ngày nay giới làm AI xôn xao về một mô hình có cái tên nghe rất bình thường: DeepSeek OCR. Nghe thì giống một công cụ quét chữ từ ảnh, nhưng thứ nó thật sự giải quyết lại lớn hơn nhiều: vấn đề bộ nhớ của AI. Kênh Two Minute Papers vừa làm hẳn một video để giải thích vì sao đây có thể là một trong những ý tưởng thú vị nhất năm nay cho các mô hình ngôn ngữ lớn (LLM, tức những AI như ChatGPT hay Claude).
Vấn đề mà DeepSeek đang nhắm tới rất quen thuộc với bất kỳ ai dùng AI lâu: bạn trò chuyện càng dài, AI càng "ngốn" nhiều tài nguyên để nhớ lại từ đầu, và đến một lúc nào đó nó buộc phải cắt bớt hoặc quên những đoạn cũ. Đó chính là giới hạn cửa sổ ngữ cảnh (context window), phần bộ nhớ tạm mà AI dùng để theo dõi cuộc trò chuyện hoặc tài liệu bạn đưa vào.
 Nén chữ thành ảnh, giải pháp nghe lạ mà hợp lý
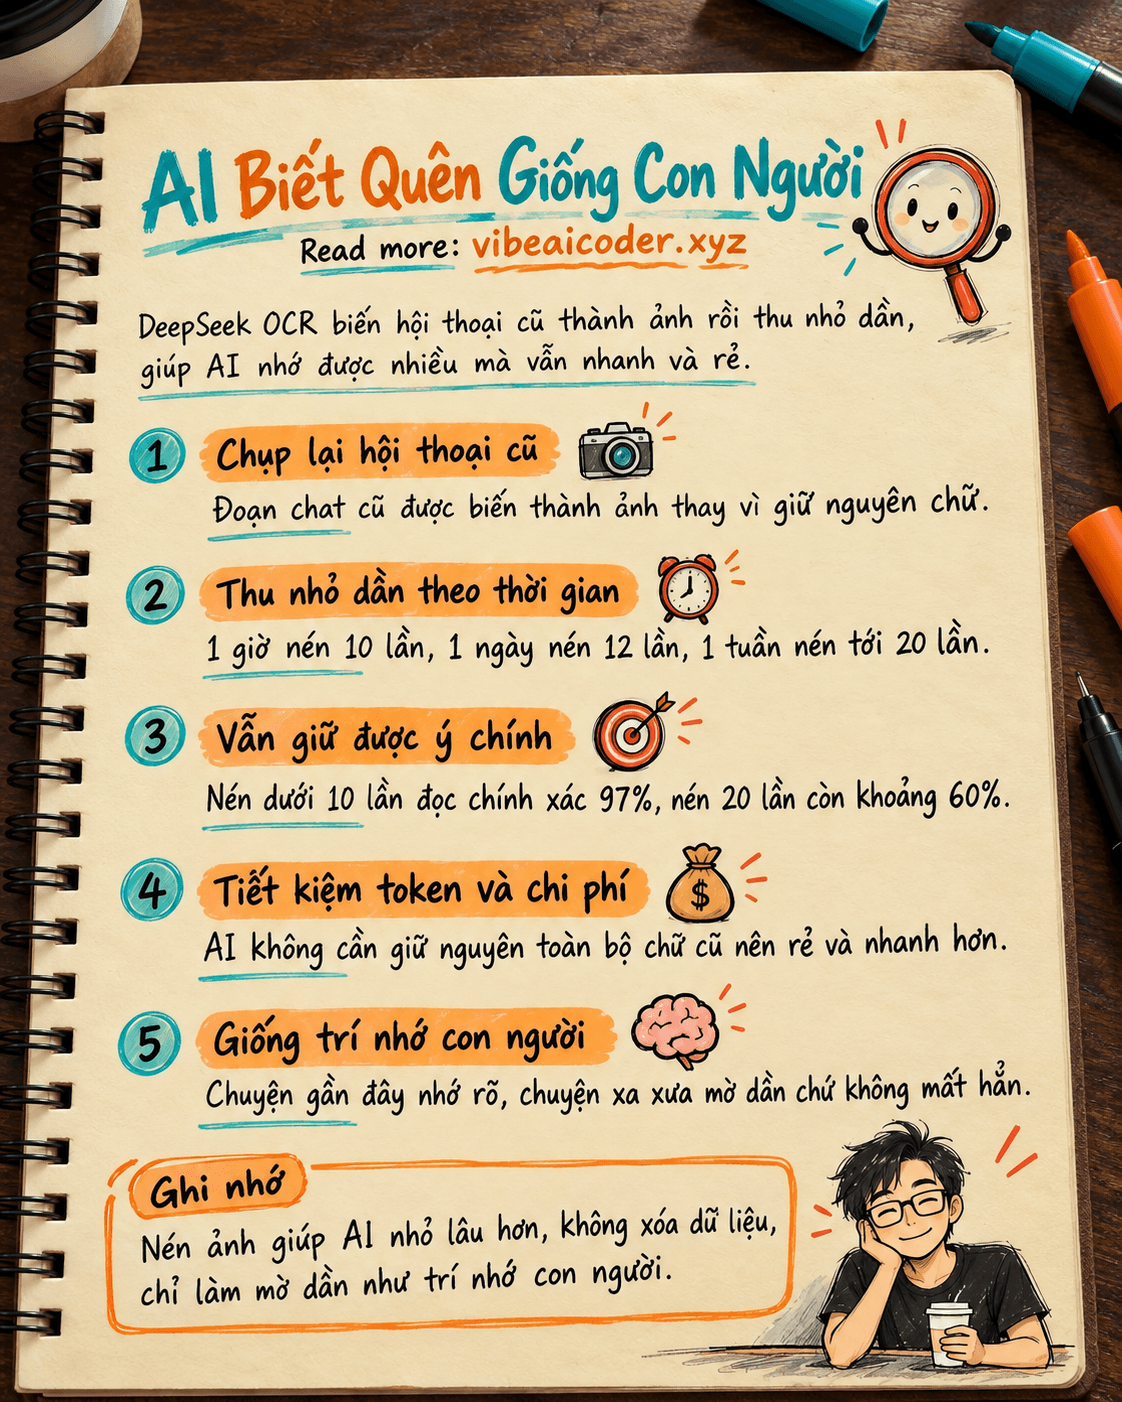
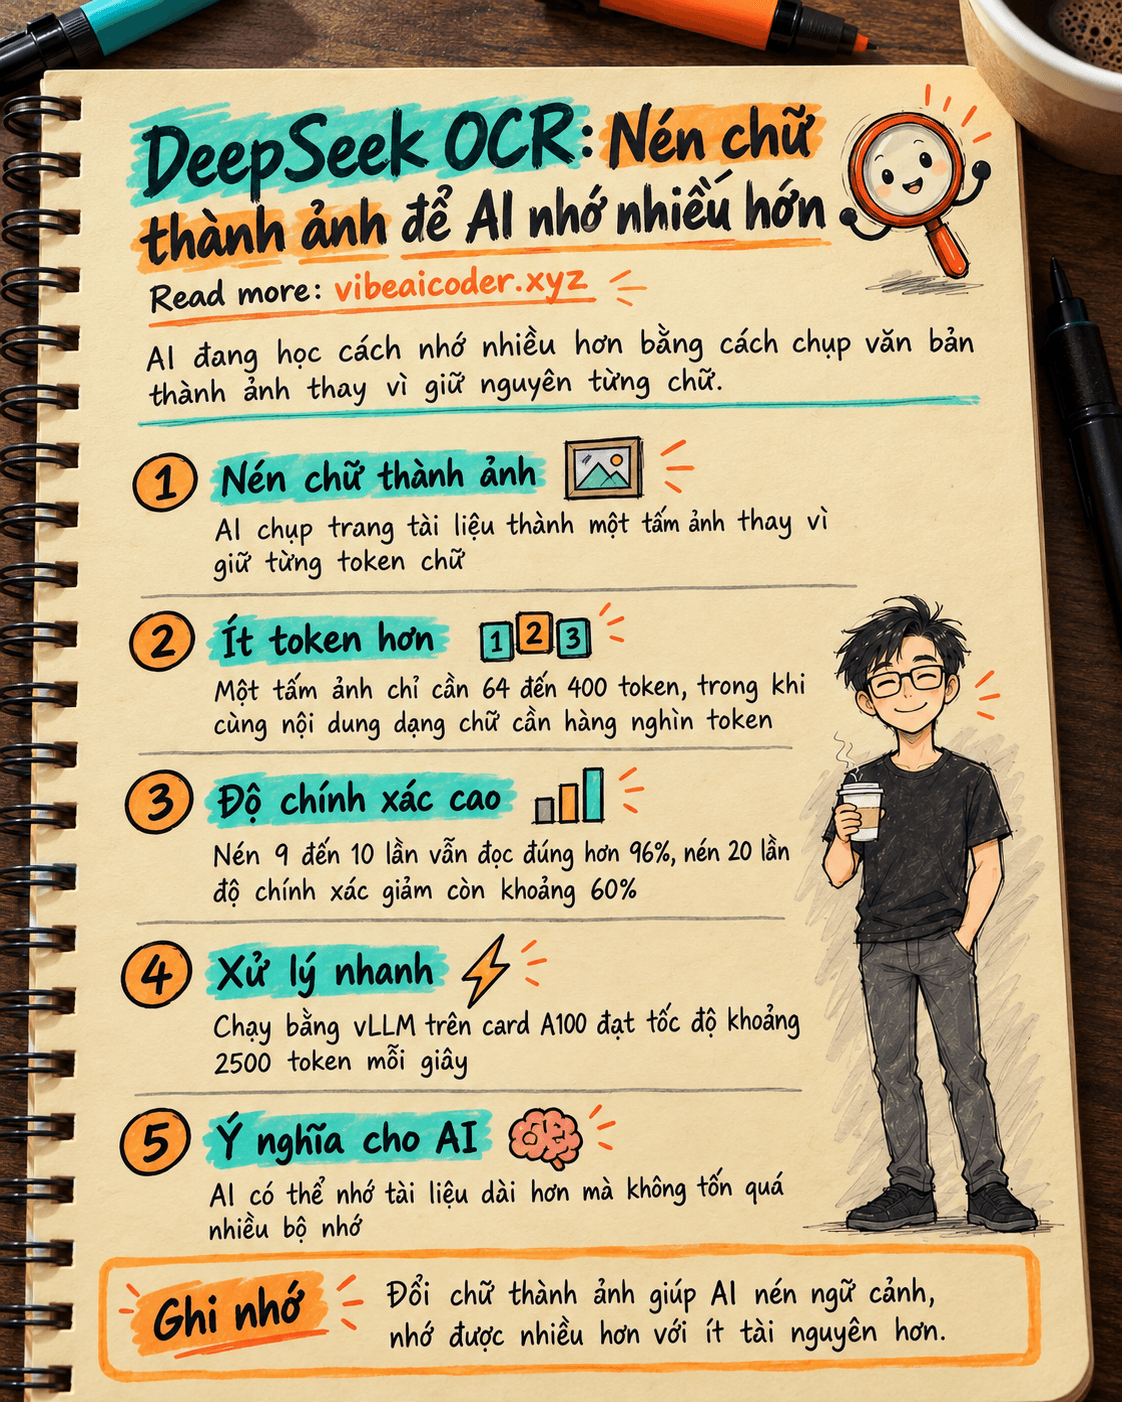
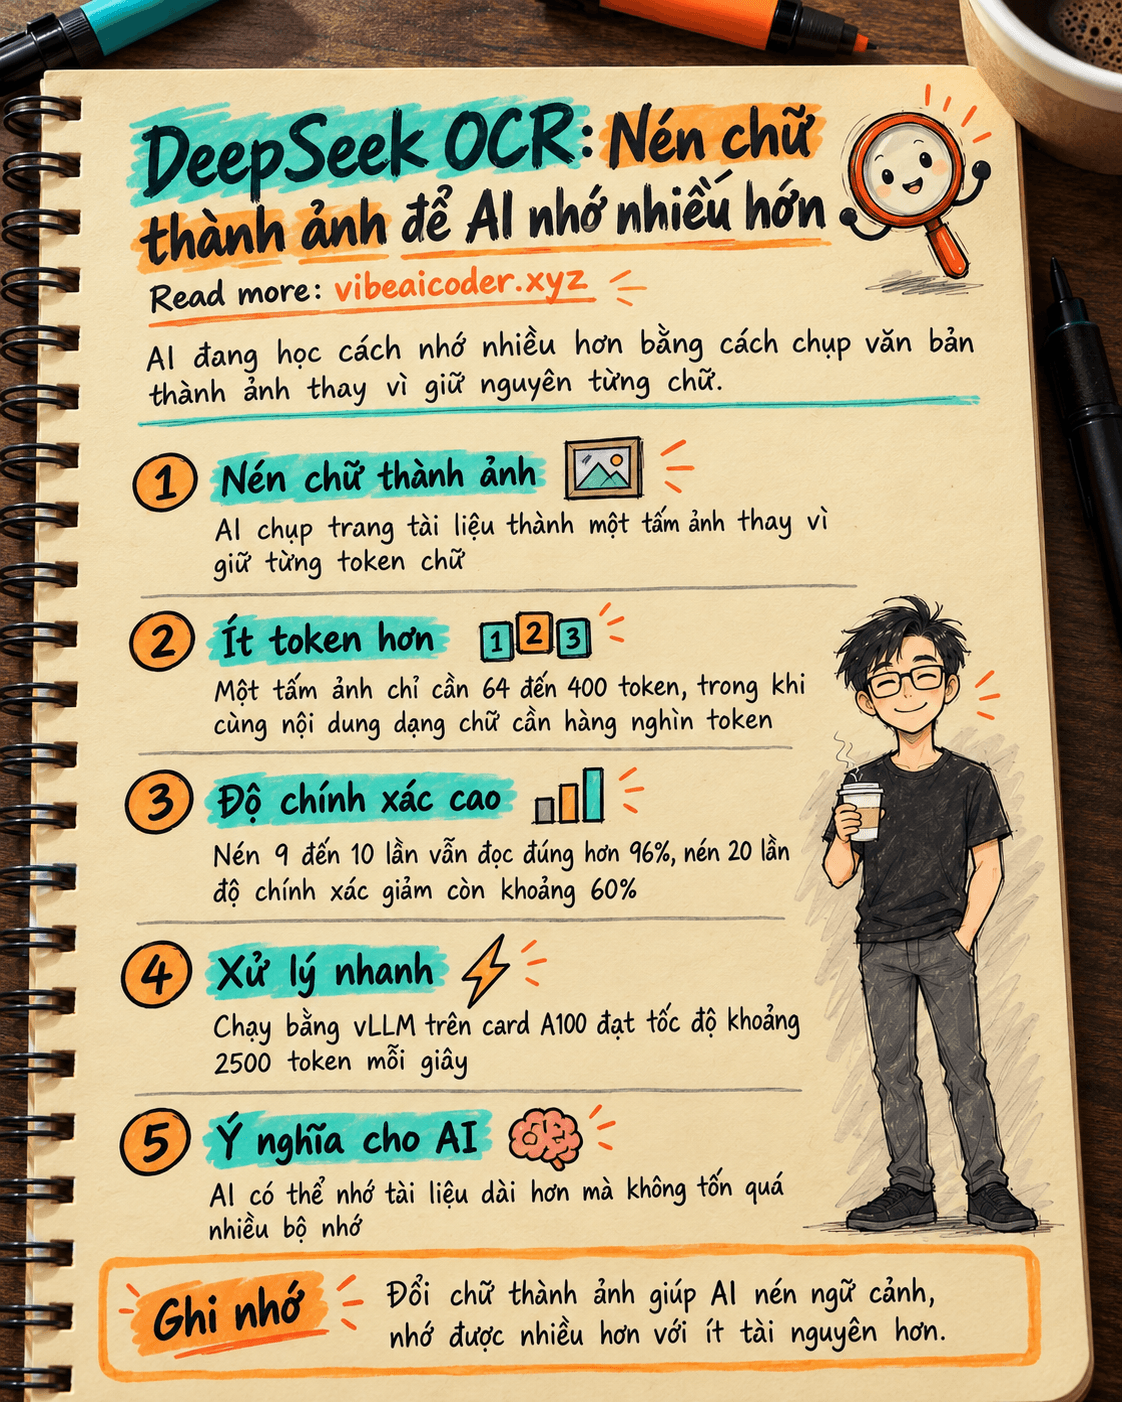
Cách làm của DeepSeek OCR khá bất ngờ: thay vì giữ nguyên văn bản dưới dạng chữ, họ chụp lại văn bản đó thành một tấm ảnh, rồi để AI đọc hiểu nội dung từ tấm ảnh ấy. Nghe có vẻ ngược đời, vì đổi chữ thành ảnh thường làm dữ liệu nặng hơn. Nhưng với AI thì khác.
Khi AI xử lý chữ, mỗi từ hoặc mỗi mảnh từ phải được tách thành một "token" riêng để tính toán, hàng nghìn trang tài liệu sẽ tạo ra hàng trăm nghìn token. Còn khi xử lý một tấm ảnh, AI chỉ cần một số lượng token cố định để mô tả toàn bộ bức ảnh đó, bất kể bên trong ảnh có bao nhiêu chữ. DeepSeek OCR tận dụng đúng kẽ hở này: nó dùng một bộ mã hóa thị giác riêng (kết hợp hai mô hình nhận diện ảnh nhỏ gọn) để "nhìn" trang tài liệu và nén lại thành rất ít token, trước khi để phần AI ngôn ngữ đọc hiểu nội dung từ đó.
Mô hình hỗ trợ nhiều mức độ chi tiết khi "chụp" trang tài liệu, từ chỉ 64 token cho một trang đơn giản đến 400 token cho trang cần giữ nhiều chi tiết, trong khi cùng lượng chữ đó nếu giữ nguyên dạng văn bản có thể cần tới hàng nghìn token.
 Con số chứng minh
Theo dữ liệu DeepSeek công bố, khi nén văn bản thành ảnh ở tỉ lệ khoảng 9 đến 10 lần (tức gói gọn lượng token chữ ban đầu vào chỉ còn một phần mười), mô hình vẫn đọc lại đúng nội dung với độ chính xác hơn 96%. Nếu nén mạnh hơn, khoảng 10 đến 12 lần, độ chính xác vẫn giữ quanh mức 90%. Chỉ khi đẩy tỉ lệ nén lên rất cao, khoảng 20 lần, độ chính xác mới tụt xuống còn khoảng 60%, tức là lúc này AI bắt đầu đọc sai hoặc bỏ sót một phần nội dung.
Nói dễ hiểu: với tài liệu dài, AI có thể "nhớ" được lượng nội dung tương đương nhưng chỉ tốn một phần nhỏ bộ nhớ so với trước, có thể ít hơn tới khoảng 20 lần, miễn là chấp nhận đánh đổi một chút độ chính xác ở mức nén cao nhất. Nhóm nghiên cứu cũng thử chạy mô hình bằng công cụ vLLM trên một card đồ họa A100 và đạt tốc độ xử lý khoảng 2500 token mỗi giây cho tài liệu dạng PDF, một con số khá nhanh với quy mô xử lý hàng loạt tài liệu.
 Vì sao chuyện này quan trọng với bạn
Nếu bạn từng thấy AI "quên" phần đầu của một cuộc trò chuyện dài, hoặc không thể tóm tắt trọn vẹn một tài liệu quá nhiều trang, đây chính là loại giới hạn mà cách làm này nhắm tới giải quyết. Khi các công ty AI áp dụng kiểu nén ngữ cảnh bằng hình ảnh như vậy, về lâu dài bạn có thể:
- Đưa vào AI những tài liệu dài hơn (hợp đồng, báo cáo, sách) mà không lo bị cắt bớt giữa chừng.
- Giữ được lịch sử trò chuyện dài hơn với trợ lý AI mà chi phí xử lý không tăng vọt.
- Nhận được phản hồi nhanh hơn, vì AI tốn ít tài nguyên hơn để "đọc lại" những gì đã nói.
Đây cũng là một ví dụ cho thấy việc tìm hiểu AI là gì không chỉ dừng ở việc gõ câu hỏi, mà hiểu được những giới hạn kỹ thuật phía sau cũng giúp bạn dùng AI hiệu quả hơn, ví dụ biết khi nào nên chia nhỏ tài liệu thay vì nhét hết vào một lần.
 Giới hạn cần biết
Đây vẫn là một mô hình mới, phần lớn mới dừng ở mức nghiên cứu và thử nghiệm, chưa chắc đã được tích hợp ngay vào các chatbot phổ biến mà bạn đang dùng hằng ngày. Việc nén dữ liệu càng mạnh thì càng dễ mất chi tiết nhỏ, nên với tài liệu quan trọng như hợp đồng hay số liệu tài chính, bạn vẫn nên tự kiểm tra lại thay vì tin tuyệt đối vào bản AI đã đọc qua ảnh nén. Bạn có thể đọc thêm về cách trí nhớ của chatbot hoạt động để hiểu rõ hơn vì sao AI đôi khi nhớ, đôi khi quên, và so sánh với cách AI biết quên giống con người bằng một cơ chế hoàn toàn khác, lược bỏ bớt ký ức cũ thay vì nén ảnh.
 Câu hỏi thường gặp
DeepSeek OCR có phải chỉ là công cụ quét chữ bình thường không? Không hẳn. Nó vẫn đọc được chữ từ ảnh như công cụ OCR thông thường, nhưng mục tiêu chính là dùng ảnh làm cách nén ngữ cảnh để AI xử lý tài liệu dài hiệu quả hơn.
Token là gì mà sao cứ nhắc hoài? Token là đơn vị nhỏ AI dùng để "đếm" và xử lý chữ, một từ tiếng Việt có thể tách thành một hoặc vài token. Mô hình AI càng phải xử lý nhiều token thì càng tốn tài nguyên và dễ chạm giới hạn bộ nhớ.
Công nghệ này có làm AI rẻ hơn khi dùng không? Về lý thuyết có, vì xử lý ít token hơn nghĩa là tốn ít tài nguyên tính toán hơn. Nhưng việc này còn phụ thuộc vào khi nào và cách nào các công ty AI đưa nó vào sản phẩm thật.
Mô hình này có phải do DeepSeek làm ra hoàn toàn mới không? Ý tưởng nén thông tin qua ảnh để tiết kiệm bộ nhớ không hoàn toàn mới trong giới nghiên cứu AI, nhưng DeepSeek là nhóm công bố công khai mã nguồn và số liệu cụ thể cho cách tiếp cận này ở quy mô một mô hình OCR thực tế.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ