CLM-35B 即将发布:AI 直接看屏幕截图做决定
CLM-35B 即将发布:AI 直接看屏幕截图做决定,不用再读文字描述
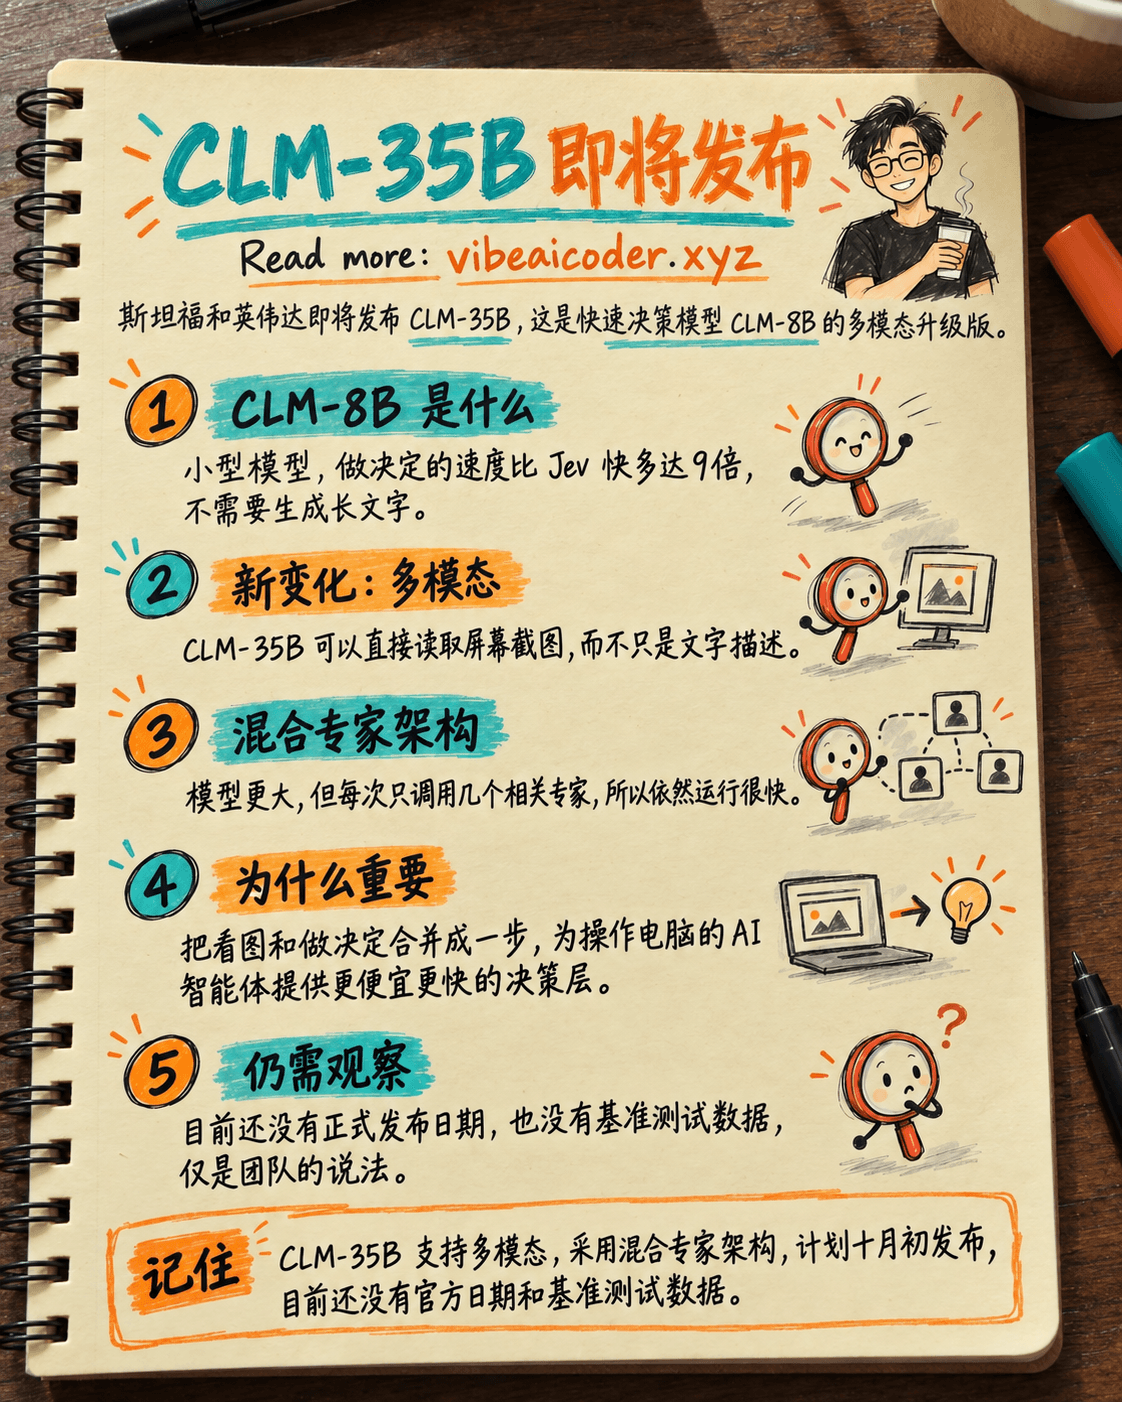
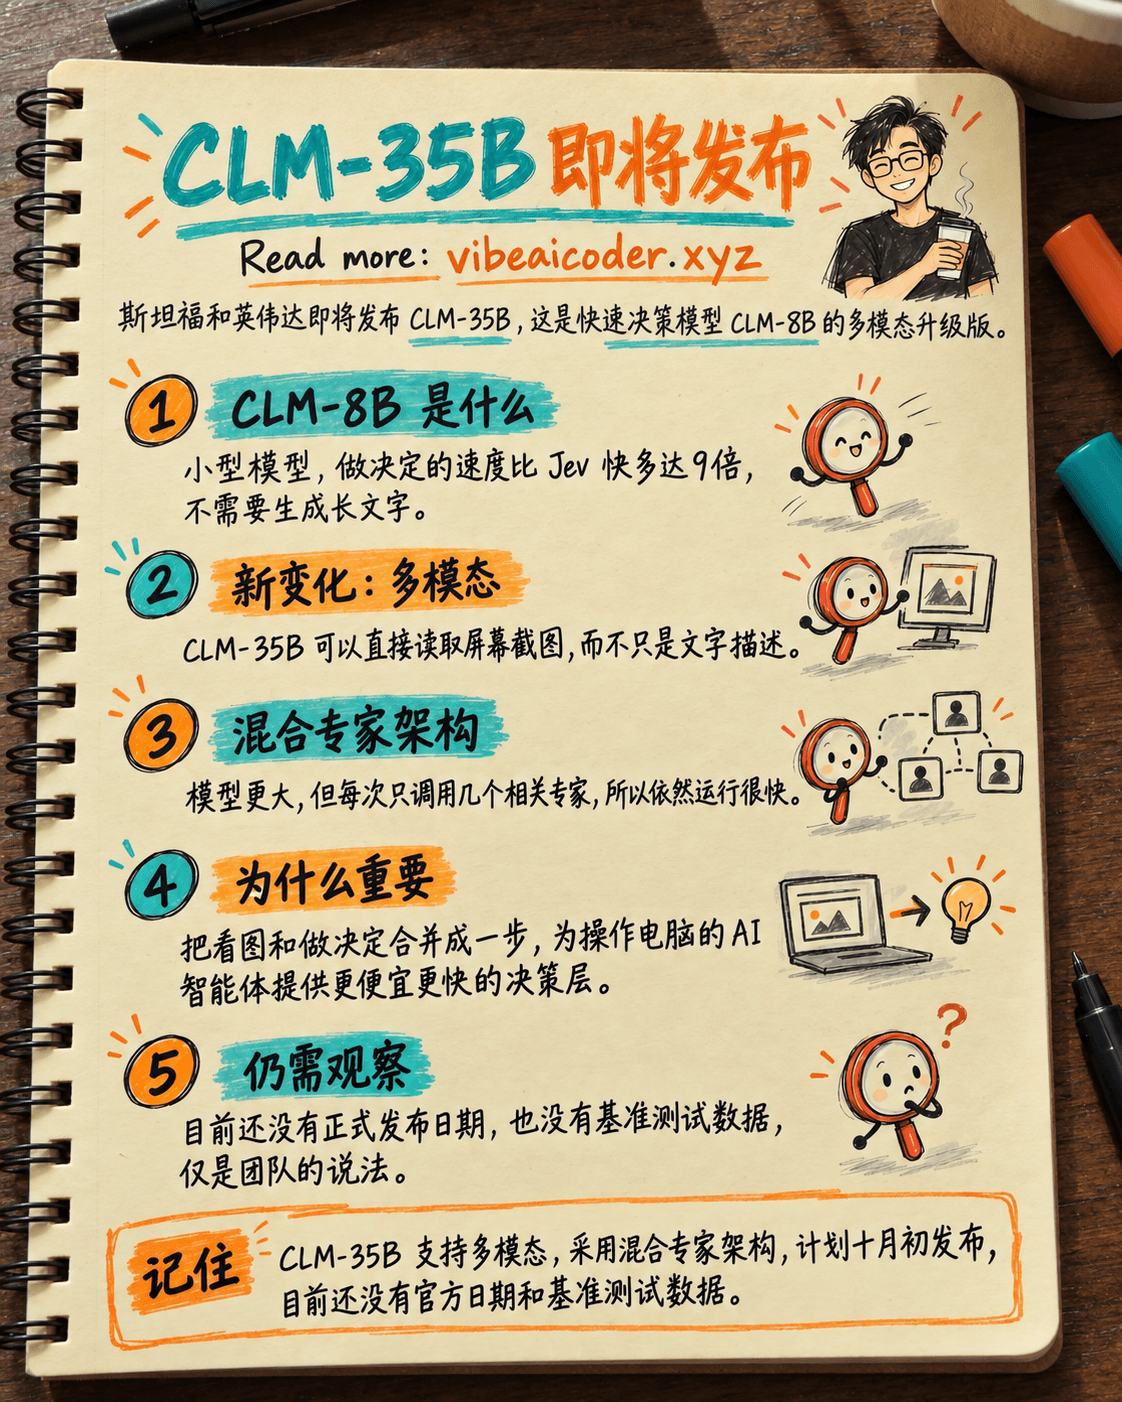
上个月底,斯坦福大学和英伟达(NVIDIA)发布的 CLM-8B 引起了不小的关注。这是一个小型 AI 模型,能让 AI 智能体(能自主行动的 AI 助手)做决定的速度比常用工具 Jev 快多达 9 倍。现在,项目团队透露了下一代版本:CLM-35B-A3B,体积更大,支持多模态,计划在十月初发布。
先简单回顾一下:CLM 是什么
我们日常用的大多数 AI(ChatGPT、Claude、Gemini)都是一个字一个字地生成答案。这种方式很灵活,但速度较慢,尤其是当 AI 智能体只需要从几个选项里选一个的时候(比如点哪个按钮、选哪个文件、回答是或否)。
CLM-8B 正好解决了这个问题:它不生成文字,而是把当前情况和每个候选动作都转换成一串数字(叫做 embedding,也就是 AI 把信息变成可以互相比较的数字的方式),然后选出最匹配的那个选项。因为不需要写出完整的回答,它比 AI 智能体开发者熟悉的工具 Jev 快很多。
CLM-35B-A3B 的新变化:它能"看"了
据项目负责人、斯坦福大学的 Jacky Kwok 介绍,CLM-35B-A3B 正在用更多数据和更强算力训练,计划于 2026 年十月初发布。相比小一号的 CLM-8B,它有两个主要区别:
- 多模态:新模型可以直接读取屏幕截图,而不只是文字描述的情况。如果按计划发布,它将是同类模型中第一个能直接"看"真实截图并做出决定的模型,不再需要先由人写出文字描述。
- 混合专家(mixture of experts,MoE)架构:简单来说,模型内部不是靠一个巨大的大脑去思考所有问题,而是拆分成很多个小"专家",每次只调用其中几个最相关的。这样模型可以做得更大(350 亿参数,是之前 80 亿的几倍),同时还能保持运行速度。
这对做 AI 智能体的人为什么重要
现在很多 AI 智能体(自动操作电脑、读取发票、处理文档的那种)都需要先通过截图"看"屏幕,然后再决定下一步做什么。以前,这一步通常需要一个庞大、缓慢又昂贵的模型,仅仅是为了把图片用文字描述出来,然后才能做决定。如果 CLM-35B-A3B 真能做到宣传的效果,它可以把这两步合并成一步:直接看图,马上做决定,中间不再需要文字描述。对于做 AI 智能体产品的人来说,这意味着可以在 Claude 或 通义千问 这类大模型背后,接上一个更便宜、更快的决策层。
还需要再观察,别急着全信
老实说,截至本文撰写时,CLM-35B-A3B 仍处于训练阶段,还没有确定的发布日期,也还没有公开任何基准测试数据来验证它真实的速度和准确率。目前所有信息都只来自开发团队自己的说法,还不是正式发布。接下来几周值得持续关注,但现在还不适合急着把它用进实际产品里。
记住这些
CLM-35B-A3B 是快速决策模型 CLM-8B(斯坦福、英伟达出品)的升级版,支持多模态,采用混合专家架构,计划于 2026 年十月初发布,但目前还没有官方发布日期和基准测试数据。如果顺利发布,它将是第一个可以直接根据屏幕截图做决定的模型,对操作电脑和处理文档的 AI 智能体很有帮助。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制