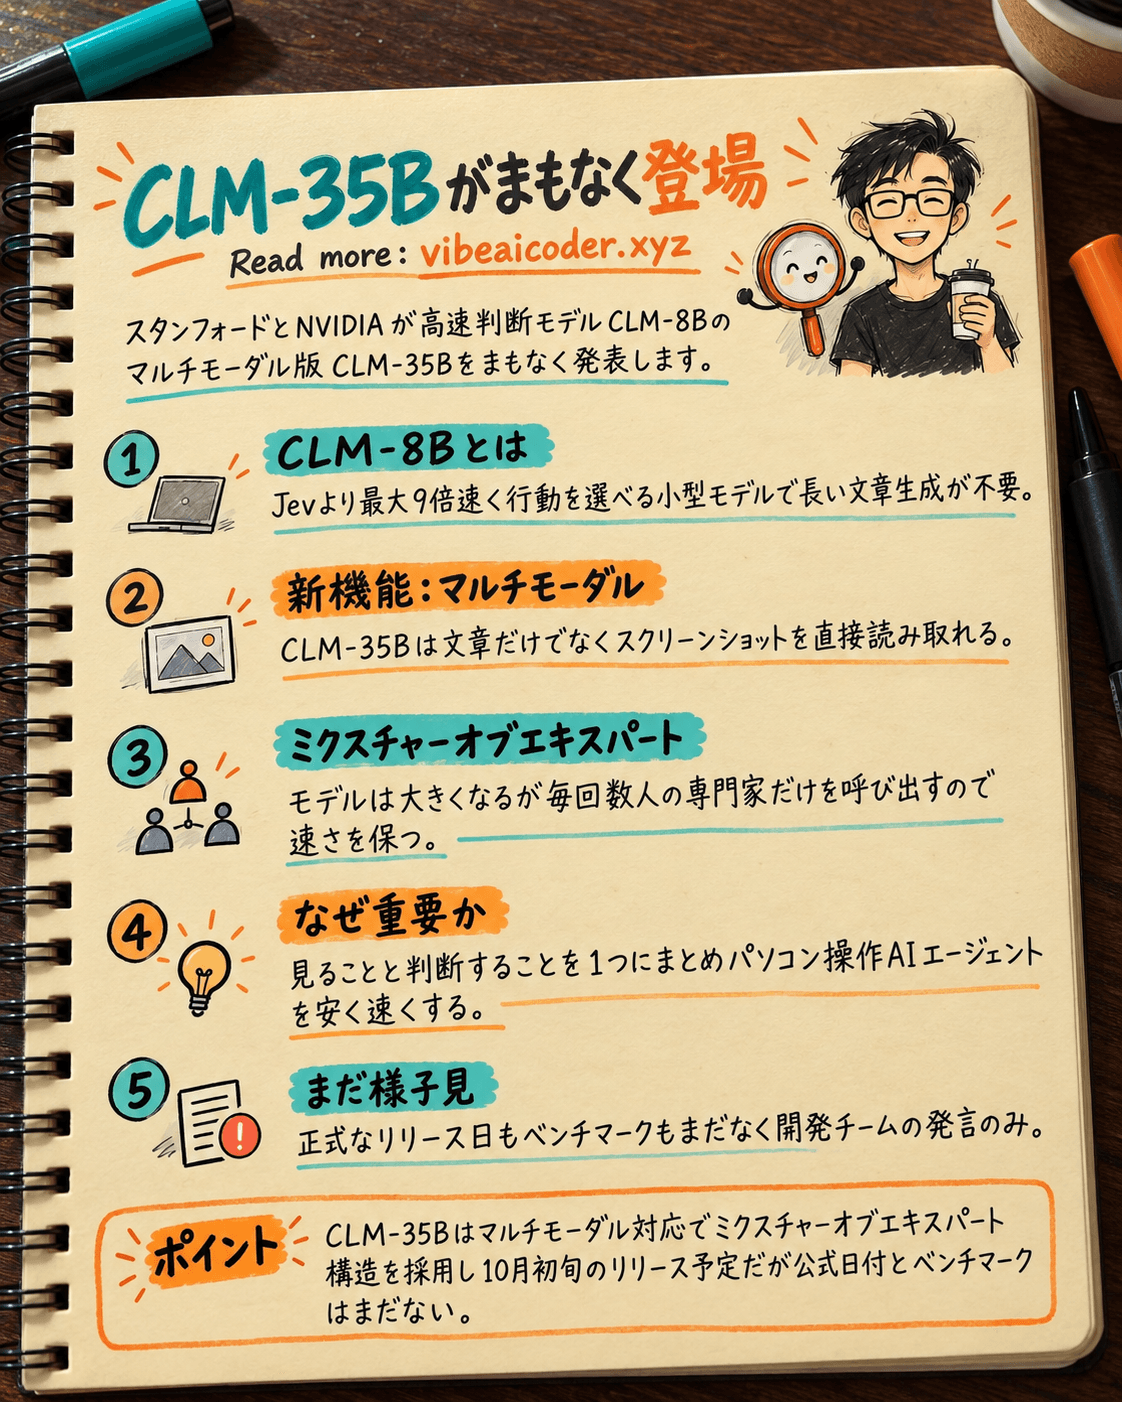
CLM-35B がまもなく登場:画面を見て判断するAI
CLM-35B がまもなく登場: 文章ではなく画面のスクリーンショットを見て判断するAI
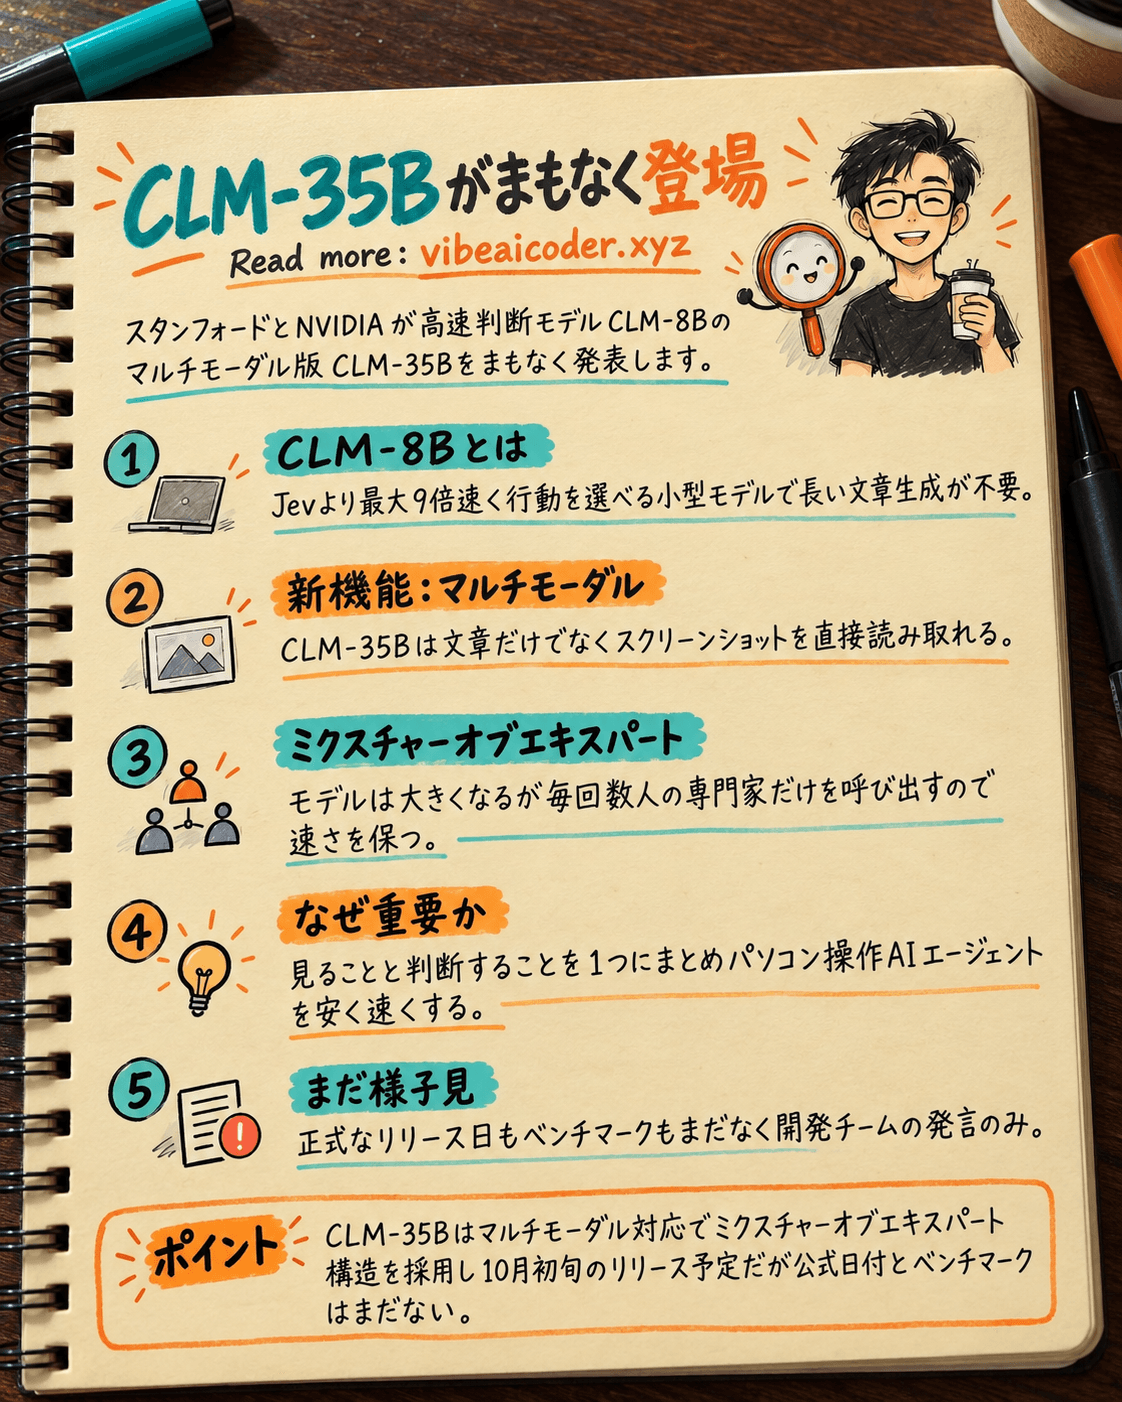
先月末、スタンフォード大学とNVIDIAが発表した CLM-8B が話題になりました。これは小型のAIモデルで、AIエージェント(自分で動くAIアシスタント)が行動を選ぶ速度を、よく使われるツール「Jev」より最大9倍速くします。そして今回、開発チームは次のバージョンを明らかにしました。CLM-35B-A3B、より大きく、マルチモーダル対応で、10月初旬のリリースが予定されています。
おさらい: CLMとは何か
普段使うAI(ChatGPT、Claude、Geminiなど)のほとんどは、文字を一つずつ生成して答えを作ります。柔軟な方法ですが、AIエージェントがいくつかの選択肢から一つを選ぶだけでいい場面(どのボタンを押すか、どのファイルを選ぶか、はいかいいえか)では、どうしても遅くなります。
CLM-8B はまさにこの問題を解決します。文章を生成する代わりに、今の状況と候補となる各行動を数字の列(embedding、AIが情報を比較できる数字に変換したもの)に変換し、最も合う選択肢を選びます。長い文章を書く必要がないため、AIエージェント開発者におなじみのツール Jev よりずっと高速です。
CLM-35B-A3B の新しい点: 「見る」ことができる
プロジェクトを率いるスタンフォード大学のJacky Kwok氏によると、CLM-35B-A3Bはより多くのデータと計算資源で訓練が進められており、2026年10月初旬のリリースが予定されています。小型版のCLM-8Bとの大きな違いは2つあります。
- マルチモーダル対応: 新しいモデルは状況を説明する文章だけでなく、画面のスクリーンショットを直接読み取ることができます。予定通りリリースされれば、文章による説明なしで実際のスクリーンショットを見て行動を選べる、この種では初めてのモデルになります。
- ミクスチャー・オブ・エキスパート(MoE)構造: 簡単に言うと、一つの巨大な脳がすべての問題を考えるのではなく、モデルの中に小さな「専門家」が多数存在し、そのたびに関係する数人の専門家だけが呼び出される仕組みです。そのおかげで、モデルを大きくしても(以前の80億パラメータに対して350億パラメータ)、速さを保てます。
AIエージェントを作る人にとってなぜ重要なのか
現在多くのAIエージェント(パソコンを自動操作する、請求書を読み取る、書類を処理するなど)は、スクリーンショットを通じて画面を「見た」上で次の行動を決める必要があります。これまでは、この段階のために大きくて遅く、コストの高いモデルが必要で、まず画像を文章で説明してからでないと判断できませんでした。CLM-35B-A3Bが宣伝通りに機能すれば、この2つの段階を1つにまとめることができます。画像を見て、そのまま判断する、間に文章による説明を挟む必要はありません。AIエージェント製品を作る人にとっては、ClaudeやQwenのような大きなモデルの裏側に取り付けられる、より安く速い判断レイヤーになります。
まだ様子見が必要
正直に言うと、この記事を書いている時点で、CLM-35B-A3Bはまだ訓練中です。正式なリリース日はまだ決まっておらず、実際の速度や精度を確認できるベンチマークデータもまだ公開されていません。現在分かっている情報はすべて開発チーム自身の発言によるもので、正式な発表ではありません。今後数週間は注目に値しますが、今すぐ製品に組み込むべきものではありません。
覚えておきたいこと
CLM-35B-A3Bは、高速判断モデルCLM-8B(スタンフォード大学、NVIDIA)のマルチモーダル版で、ミクスチャー・オブ・エキスパート構造を採用し、2026年10月初旬のリリースが予定されていますが、公式な日付やベンチマークデータはまだありません。もし実現すれば、スクリーンショットだけを見て行動を選べる初めてのモデルとなり、パソコンを操作したり書類を処理したりするAIエージェントに役立ちます。
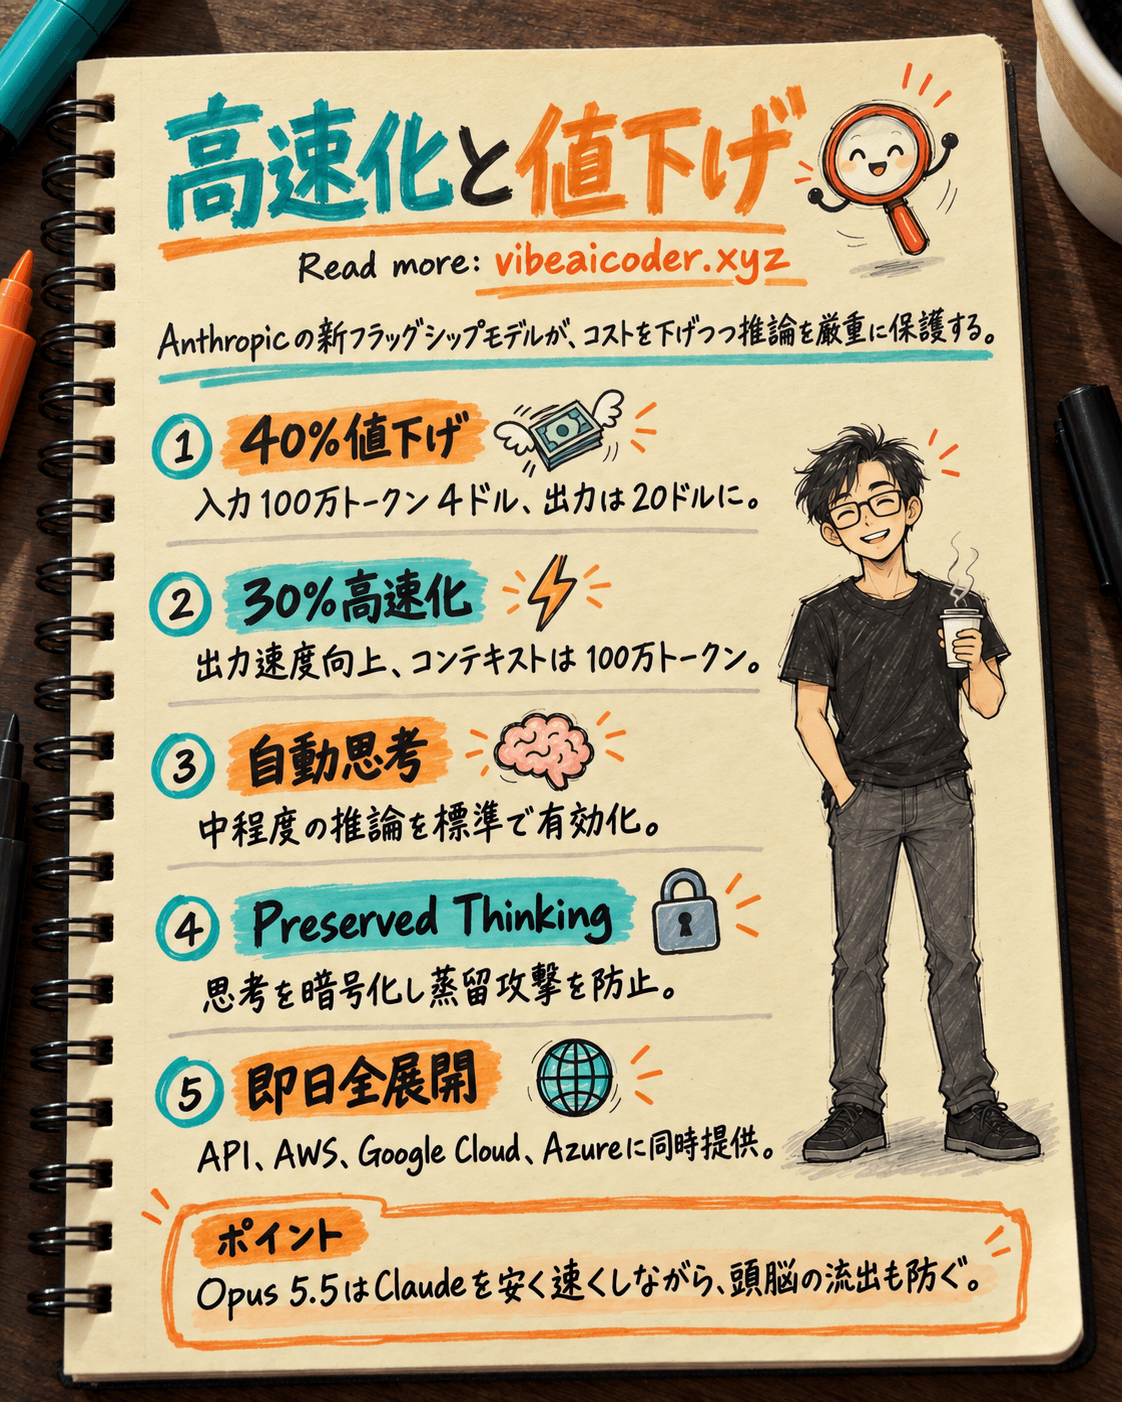
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止