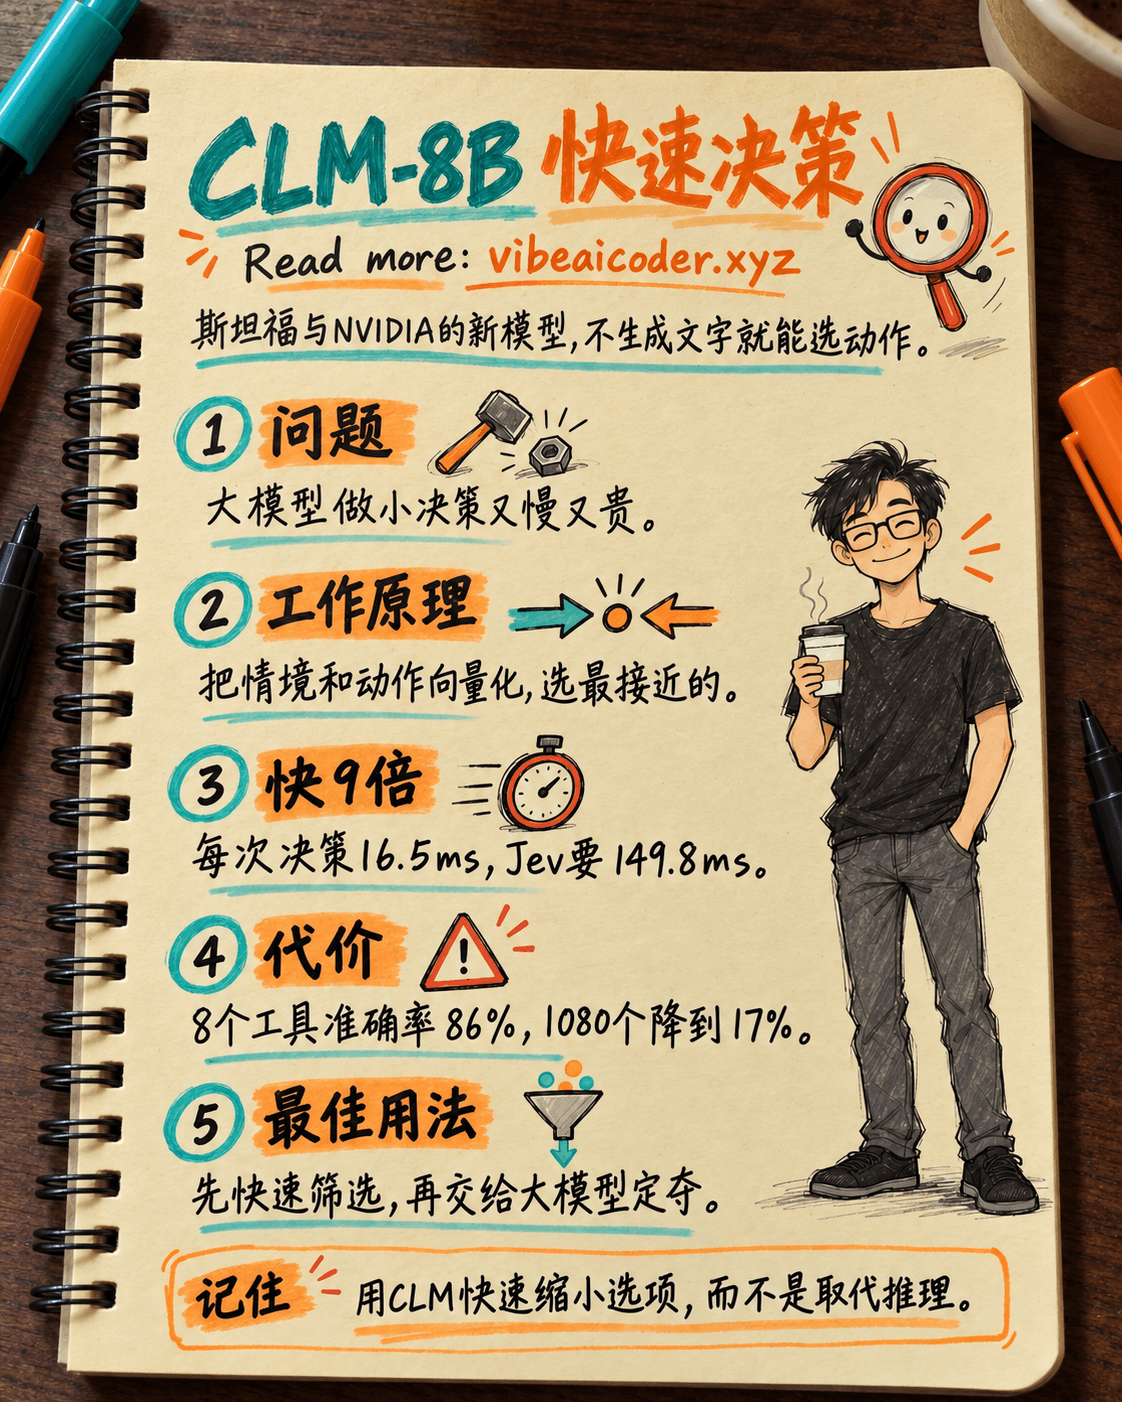
 CLM-8B:不生成文字的AI架构,决策速度比Jev快9倍
你有没有注意到,自己的智能体(agent)光是决定调用哪个工具,就要花上几百毫秒?这正是CLM-8B要解决的问题,这是来自斯坦福大学和英伟达研究院(NVIDIA Research)全新打造的模型。它完全不生成任何文字,只是……用极快的速度做出正确判断。
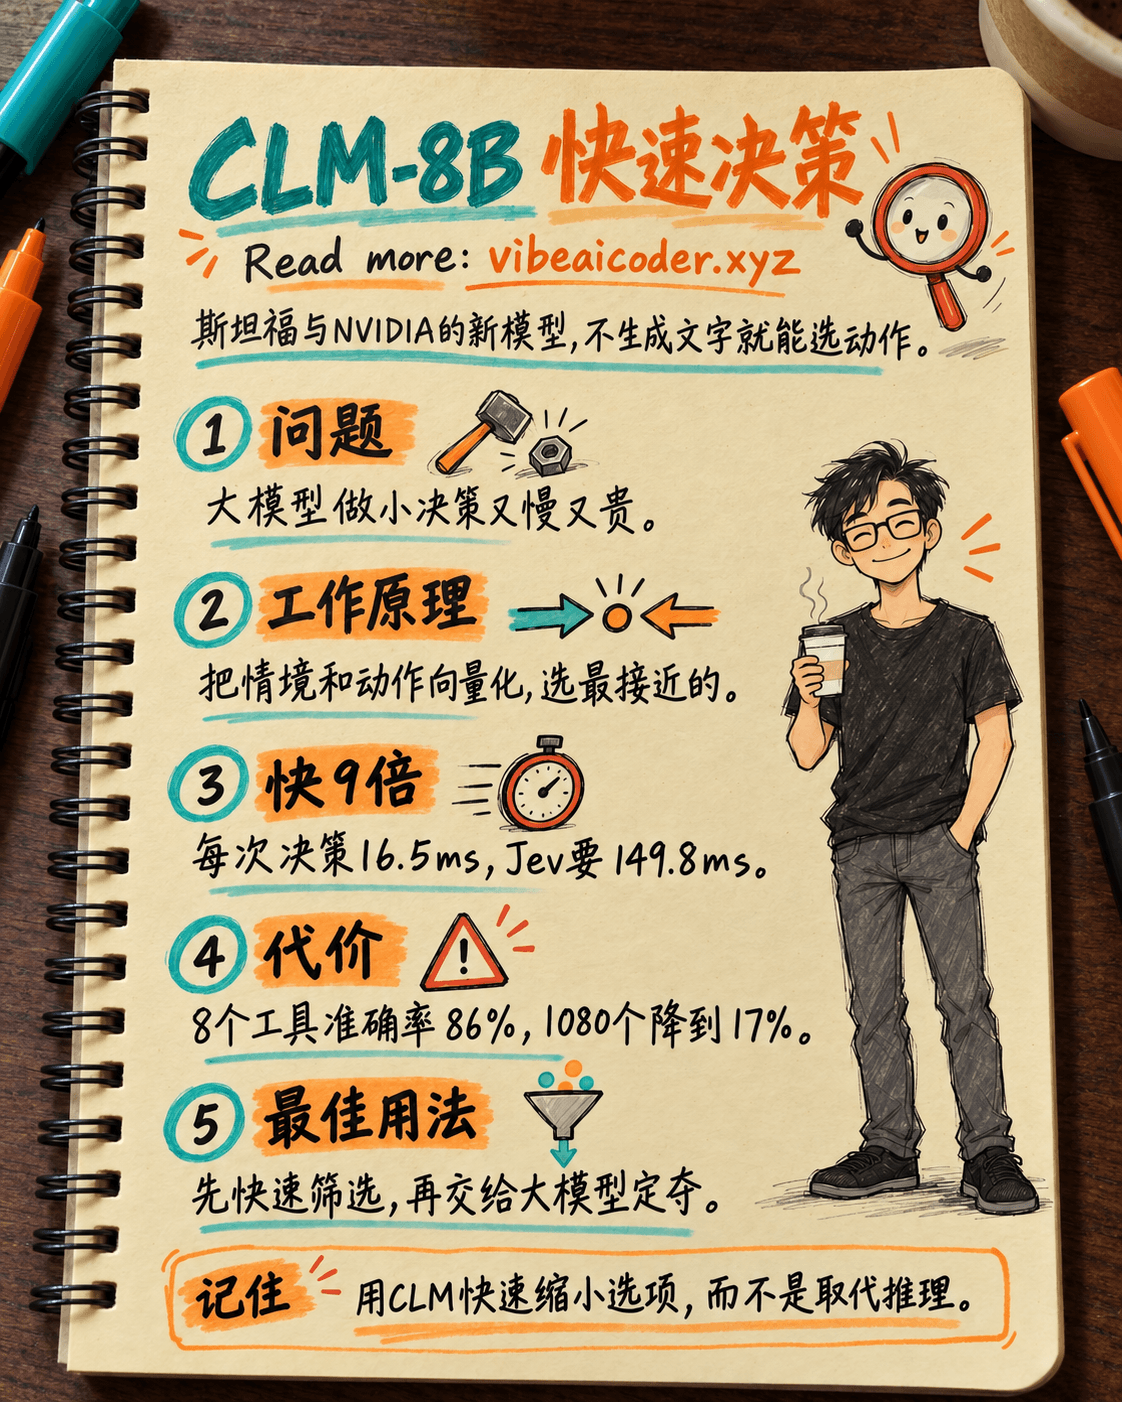
 问题:LLM对小决策来说太"重"了
每个AI智能体内部,其实都充满了大量琐碎的决策:选哪个工具、给哪个补丁排序、请求该路由到哪里、下一步该采取什么行动。用一个全尺寸LLM逐个生成token来做这些小决策,就像用宰牛刀杀鸡:又慢又费钱。这正是Jev(TypeSafe AI的System 1模型)一直称霸的领域。现在,斯坦福和英伟达带来了一种完全不同的思路。
 CLM是如何运作的
CLM(对比语言模型,Contrastive Language Model)不像传统模型那样生成答案,而是把决策变成一个检索(retrieval)问题,原理和CLIP将图片与文字说明配对的方式一模一样。它把当前情境和每一个可能的行动都嵌入(embed)到同一个向量空间中,然后选出距离最近的那个行动。
这是一个双编码器(dual-encoder)架构,包含:
- 一个冻结(frozen)的Qwen3-8B主干网络作为基础。
- 两个约2000万参数的MLP投影头(projection head),一个处理状态(state),一个处理行动(action),是唯一需要训练的部分。
- 使用**InfoNCE对比损失(contrastive loss)**训练,分三个阶段:约6000万组问答对、约3000万个"难负样本"(看似正确实则错误的答案),以及约100万条智能体轨迹用于后训练(post-train)。
由于每个行动都只编码一次并缓存,比较1000个选项的成本几乎和比较1个选项一样低。
 到底有多快
研究团队公布的官方数据(基于T-Rex游戏基准测试):CLM-8B做出决策只需16.5毫秒,而Jev需要149.8毫秒,快了将近9倍。
YouTube频道Prompt Engineering独立复测后发现,在高负载场景下差距更惊人:面对1000个候选行动,CLM只需44毫秒,而Jev要花579毫秒,因为Jev必须逐个为每个选项打分,而CLM只是查询已经缓存好的向量。
 代价:无法做选项间的直接比较
这是在把CLM加入你的流水线(pipeline)之前,最该留意的一点:由于每个行动都是独立编码的,CLM永远不会像LLM那样把所有选项放在一起读完再推理比较。
选项数量一多,这个短板就暴露出来了。同样是Prompt Engineering频道,在一台DGX Spark上用1080个工具做测试:准确率从只有8个工具时的86%,暴跌到满编1080个工具时的17%。研究团队自己公布的基准数据也印证了类似趋势:
- BFCL v4(工具调用测试):CLM-8B拿到95.2%,Jev是99.2%。
- WikiRacing:CLM完成了26/30个任务,Jev是30/30。
- 但在另外两项测试中,CLM反而赢了:DeepSWE编程任务81.6% 对比 Jev的71.1%,以及Terminal-Bench 87.6% 对比 Jev的83.1%。
换句话说:CLM并不是每次都赢,而且需要精细区分的选项越多,它就越容易掉链子。
 CLM到底该用在哪里
CLM项目负责人Jacky Kwok直言不讳地谈到了局限性:"我不会用CLM去取代一个通用推理模型,来处理需要开放式推理的任务,比如解数学题、生成长篇回答,或者做高层次的规划。"
目前在智能体流水线中,CLM最合适的位置是:充当第一层过滤器,又便宜又快,先把工具或行动的候选列表缩小到几个选项,再交给一个全尺寸LLM做最终决策。千万别在选项太多或太相似的时候,让它独自做主。
斯坦福和英伟达已经开源了CLM-8B的代码,而它的多模态后继版本CLM-35B预计会在2026年10月初发布。如果你正在构建一个每一步都要调用几十个工具的智能体,这个架构现在就值得一试,前提是你清楚它的盲区在哪里。