CLM-35B đa phương thức sắp ra mắt: AI nhìn ảnh màn hình để quyết định, không cần đọc mô tả
CLM-35B đa phương thức sắp ra mắt: AI nhìn ảnh màn hình để ra quyết định, không cần đọc mô tả
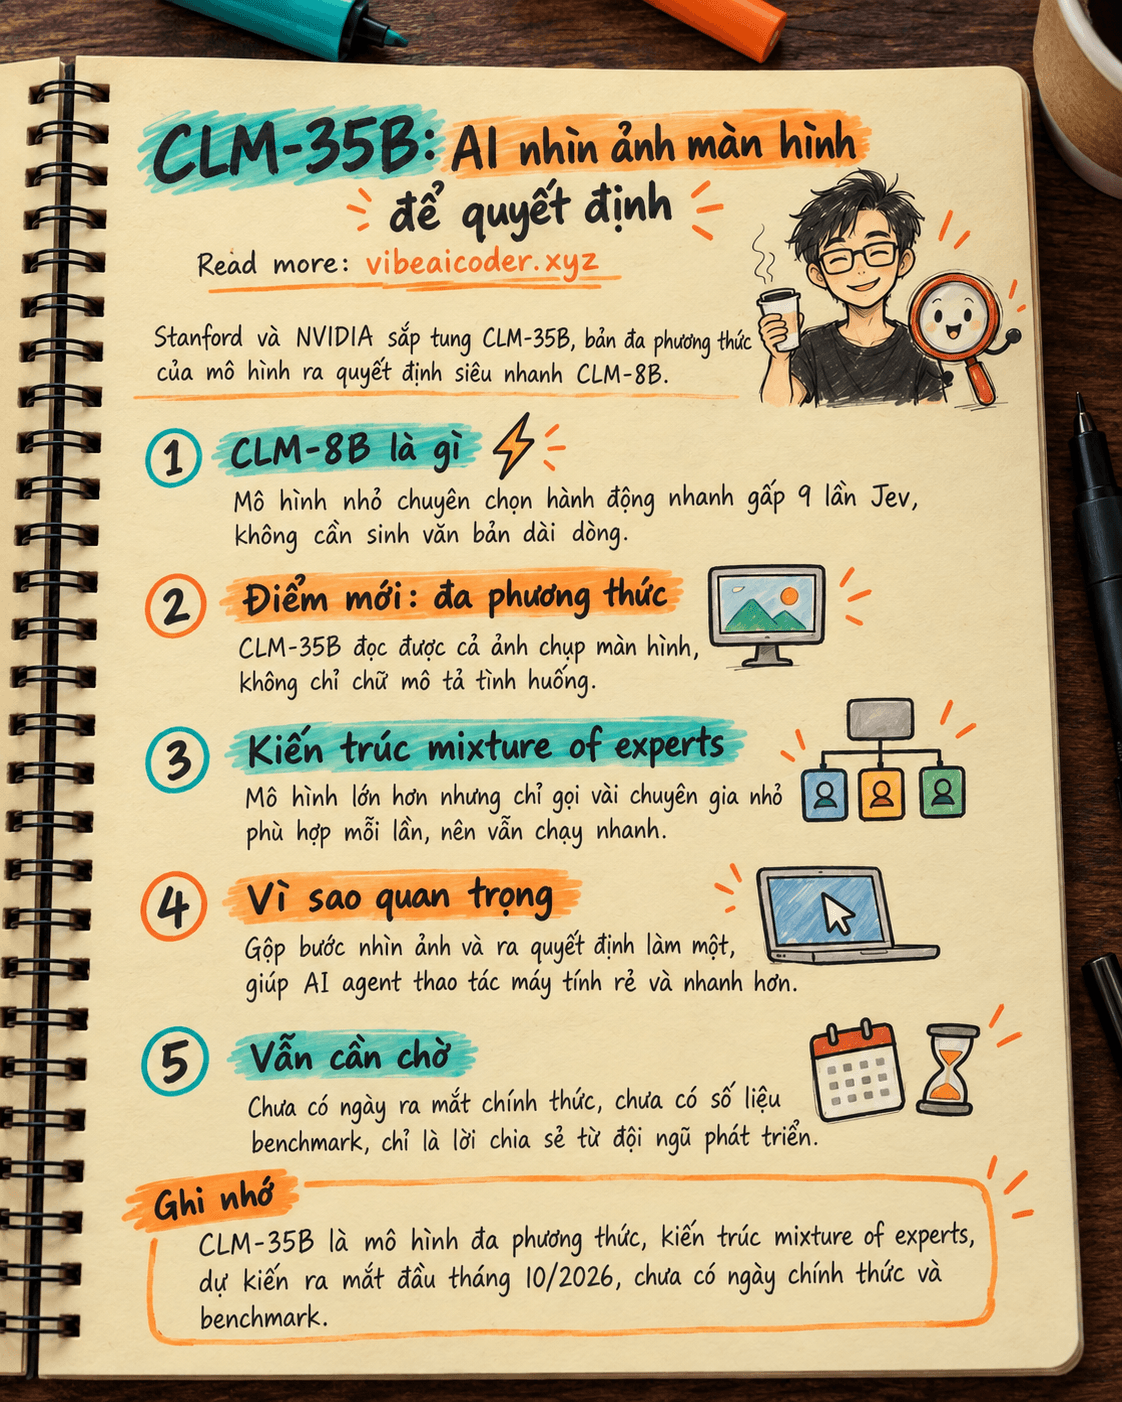
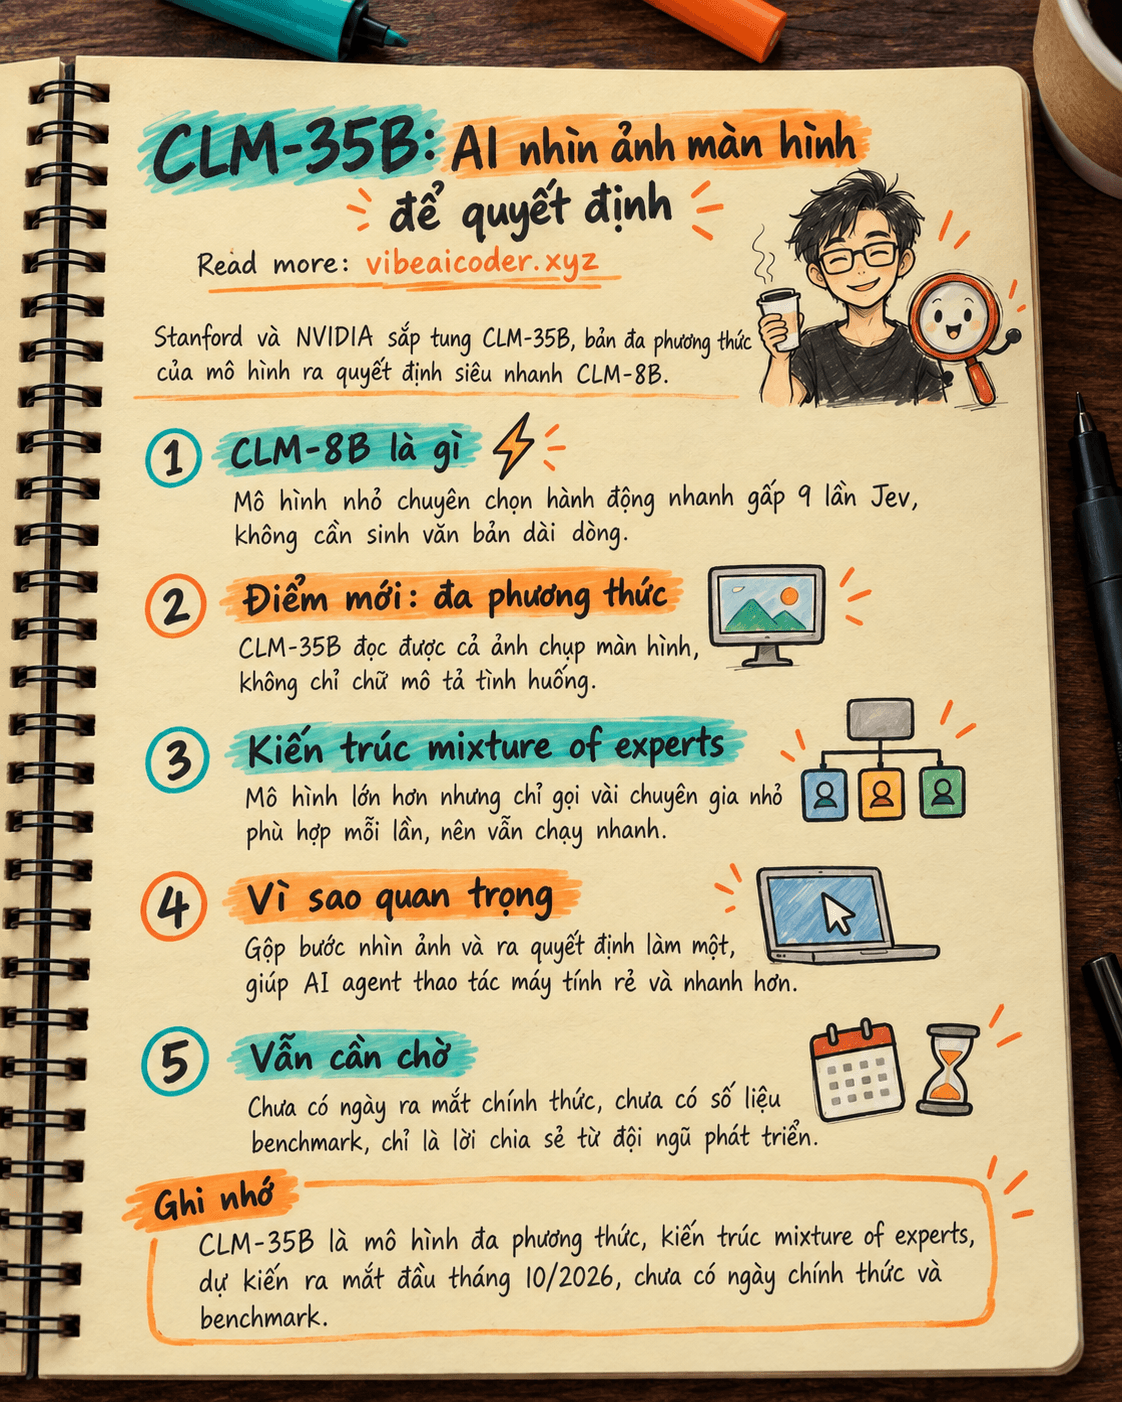
Hồi cuối tháng 9, Stanford và NVIDIA từng gây chú ý khi tung ra CLM-8B, một mô hình AI nhỏ gọn giúp các AI agent (trợ lý AI tự hành động) chọn hành động nhanh gấp 9 lần so với công cụ quen thuộc Jev. Giờ đây, đội ngũ đứng sau dự án tiết lộ phiên bản kế tiếp: CLM-35B-A3B, lớn hơn, hiểu được cả hình ảnh, và dự kiến ra mắt ngay trong đầu tháng 10 này.
CLM là gì, nhắc lại cho ai chưa biết
Hầu hết AI mà bạn hay dùng (ChatGPT, Claude, Gemini) hoạt động theo kiểu sinh từng chữ một để trả lời. Cách này linh hoạt nhưng chậm, nhất là khi AI agent chỉ cần chọn một trong vài lựa chọn có sẵn (ví dụ: bấm nút nào, chọn file nào, trả lời "có" hay "không").
CLM-8B giải quyết đúng vấn đề đó: thay vì sinh chữ, nó biến tình huống hiện tại và từng lựa chọn thành các dãy số (gọi là embedding, cách AI biến thông tin thành con số để so sánh), rồi chọn ra lựa chọn nào "khớp" nhất. Vì không phải viết câu trả lời dài dòng, nó nhanh hơn hẳn Jev, công cụ quen thuộc trong giới làm AI agent.
Điểm mới của CLM-35B-A3B: biết "nhìn"
Theo Jacky Kwok, trưởng dự án tại Stanford, CLM-35B-A3B đang được huấn luyện thêm dữ liệu và sức mạnh tính toán, với kế hoạch ra mắt đầu tháng 10/2026. Hai điểm khác biệt lớn nhất so với đàn anh CLM-8B:
- Đa phương thức (multimodal): mô hình mới đọc được cả ảnh chụp màn hình, không chỉ chữ mô tả tình huống. Nếu đúng như kế hoạch, đây sẽ là mô hình dạng này đầu tiên có thể "nhìn" một ảnh màn hình thật và chọn luôn hành động, thay vì phải có người viết sẵn mô tả bằng chữ.
- Kiến trúc mixture of experts (MoE): hiểu nôm na, thay vì một bộ não khổng lồ phải suy nghĩ cho mọi câu hỏi, mô hình chia thành nhiều "chuyên gia" nhỏ bên trong, mỗi lần chỉ gọi vài chuyên gia phù hợp nhất với tình huống. Nhờ vậy mô hình có thể lớn hơn (35 tỷ tham số, so với 8 tỷ của bản cũ) mà vẫn chạy nhanh.
Vì sao điều này quan trọng với người dùng AI agent
Rất nhiều AI agent hiện nay (tự động điều khiển máy tính, đọc hóa đơn, xử lý tài liệu) phải "nhìn" màn hình qua ảnh chụp rồi mới quyết định bước tiếp theo. Trước giờ, bước này thường cần một mô hình lớn, chậm và tốn kém chỉ để mô tả lại ảnh bằng chữ trước khi ra quyết định. Nếu CLM-35B-A3B hoạt động đúng như quảng bá, nó có thể gộp hai bước đó làm một: nhìn ảnh, ra quyết định luôn, không cần bước trung gian viết mô tả. Với người làm sản phẩm AI agent, đây là lớp quyết định rẻ và nhanh hơn để gắn phía sau các mô hình lớn như Claude hay Qwen.
Vẫn cần chờ, chưa vội tin hết
Nói thật với bạn: đến thời điểm viết bài, CLM-35B-A3B vẫn đang trong giai đoạn huấn luyện, chưa có ngày ra mắt chính xác, cũng chưa có số liệu benchmark nào được công bố để kiểm chứng tốc độ hay độ chính xác thực tế. Thông tin hiện có chỉ đến từ lời chia sẻ của đội ngũ phát triển, chưa phải bản phát hành chính thức. Đây là điểm đáng theo dõi tiếp trong vài tuần tới, chứ chưa phải thứ bạn nên vội vàng tích hợp vào sản phẩm ngay.
Ghi nhớ
CLM-35B-A3B là phiên bản lớn hơn, đa phương thức của mô hình ra quyết định nhanh CLM-8B (Stanford, NVIDIA), dùng kiến trúc mixture of experts, dự kiến ra mắt đầu tháng 10/2026 nhưng chưa có ngày chính thức lẫn số liệu benchmark. Nếu thành hiện thực, nó sẽ là mô hình đầu tiên chọn hành động trực tiếp từ ảnh màn hình, hữu ích cho các AI agent tự thao tác máy tính và xử lý tài liệu.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
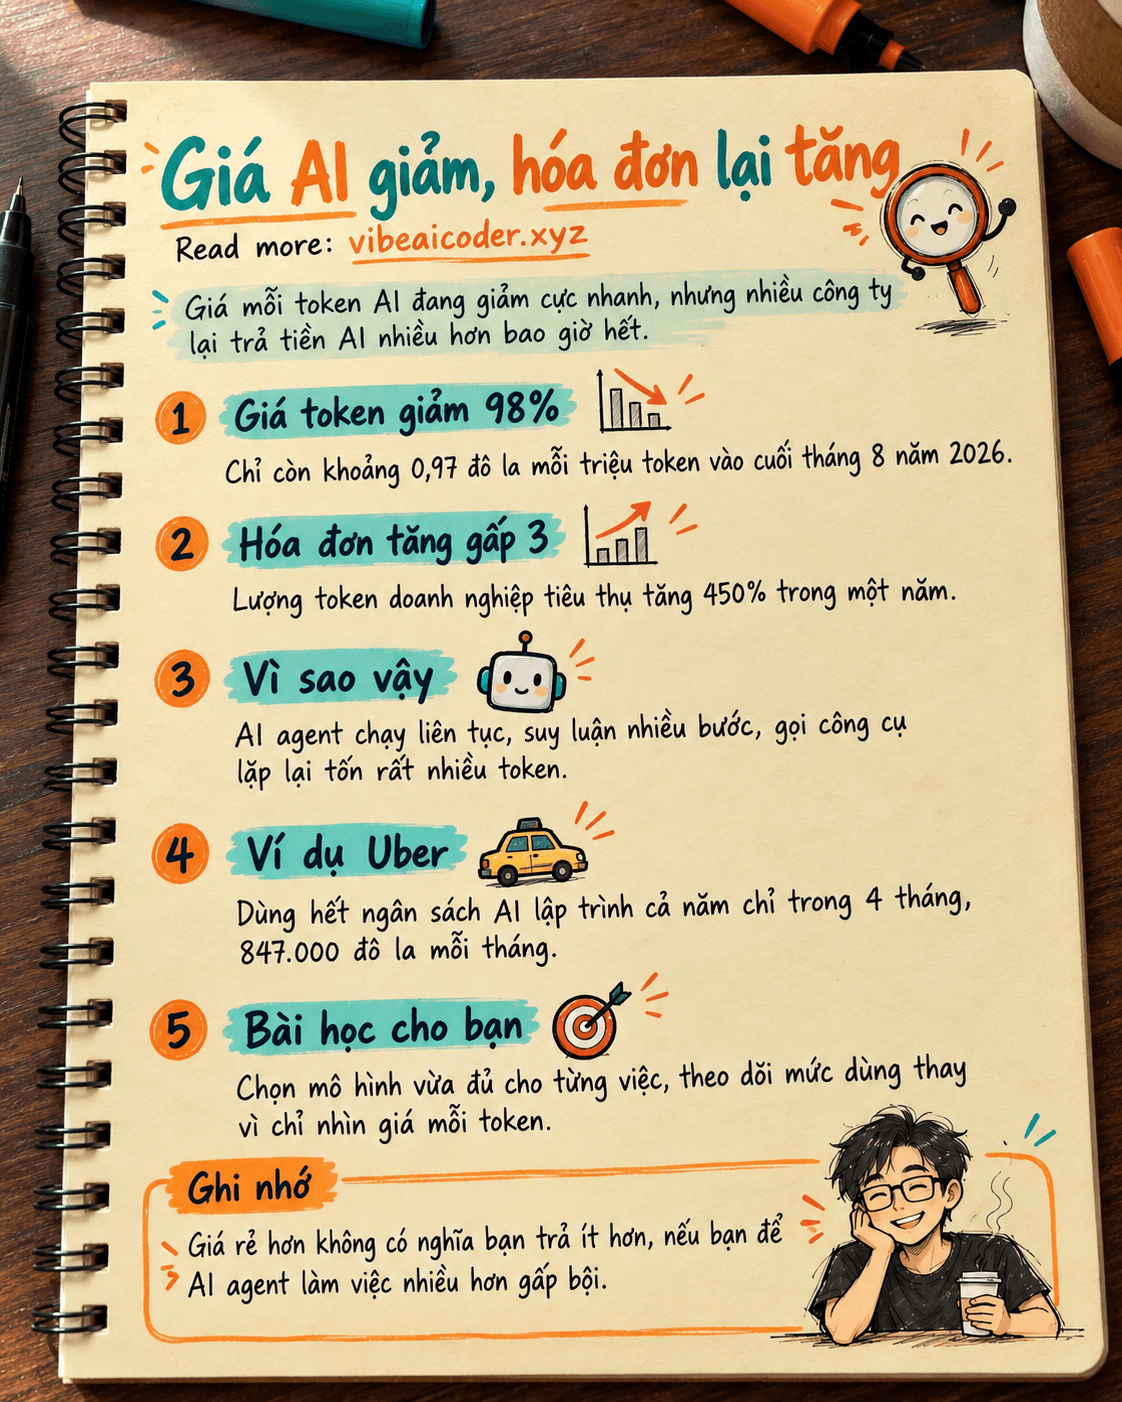
 Giá AI giảm 98% nhưng hóa đơn công ty lại tăng gấp 3