DeepSeekがAIに人間のように忘れることを教え、コストのかかる記憶問題を解決
DeepSeekがAIに人間のように忘れることを教え、コストのかかる記憶問題を解決
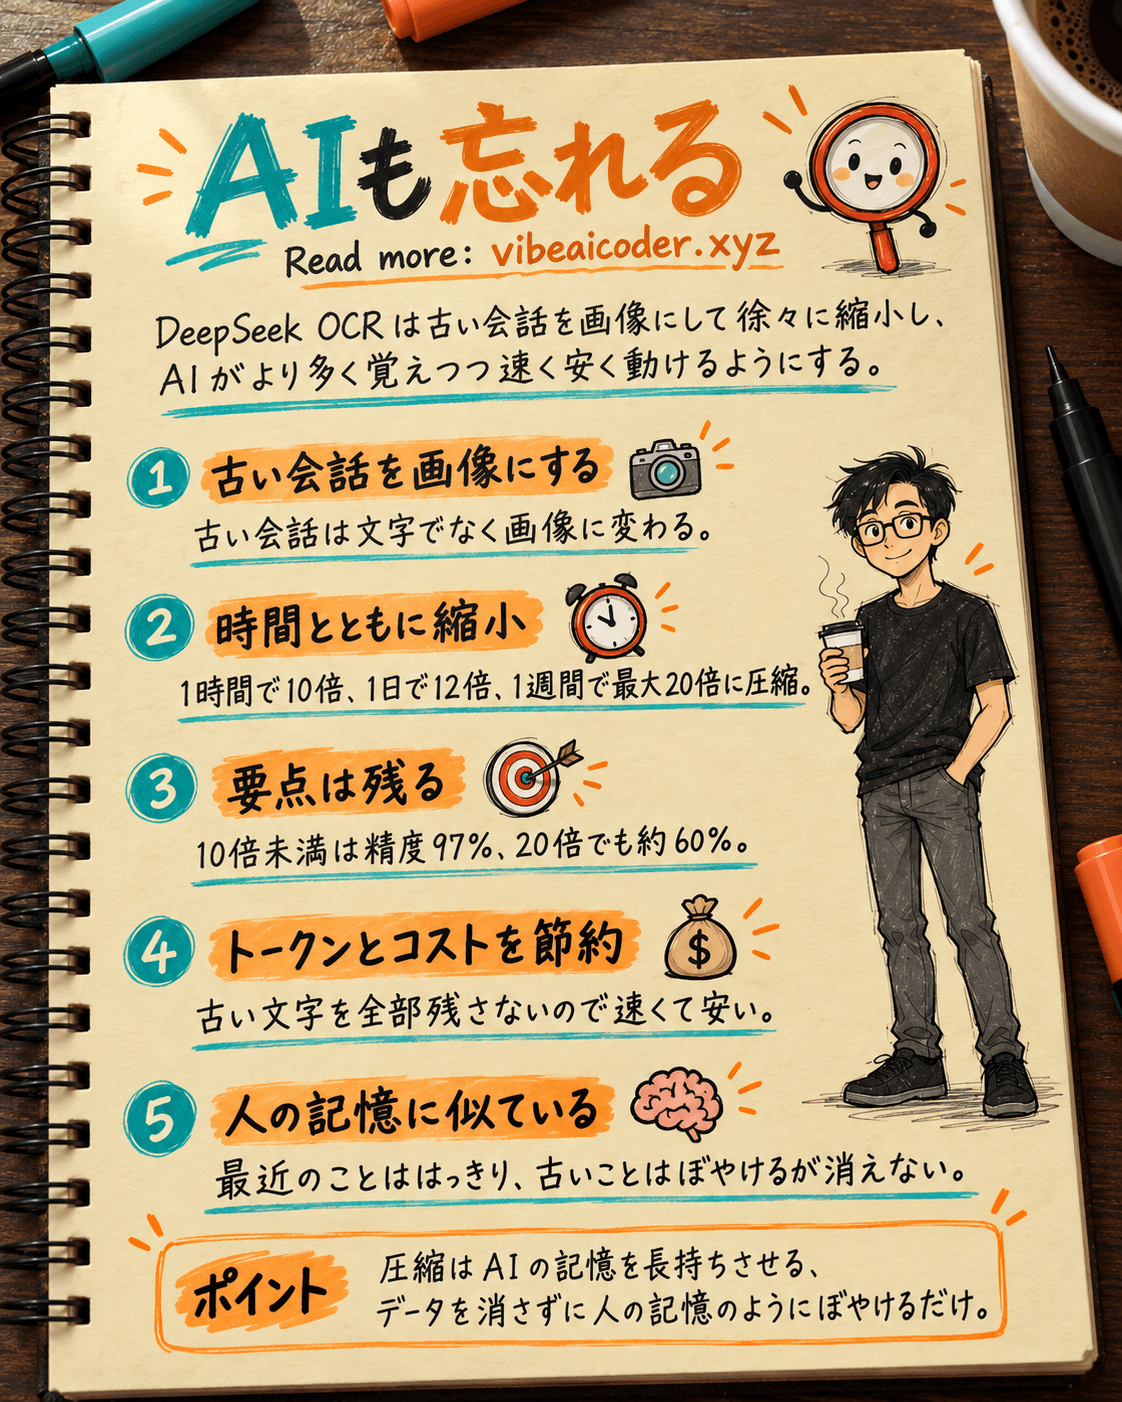
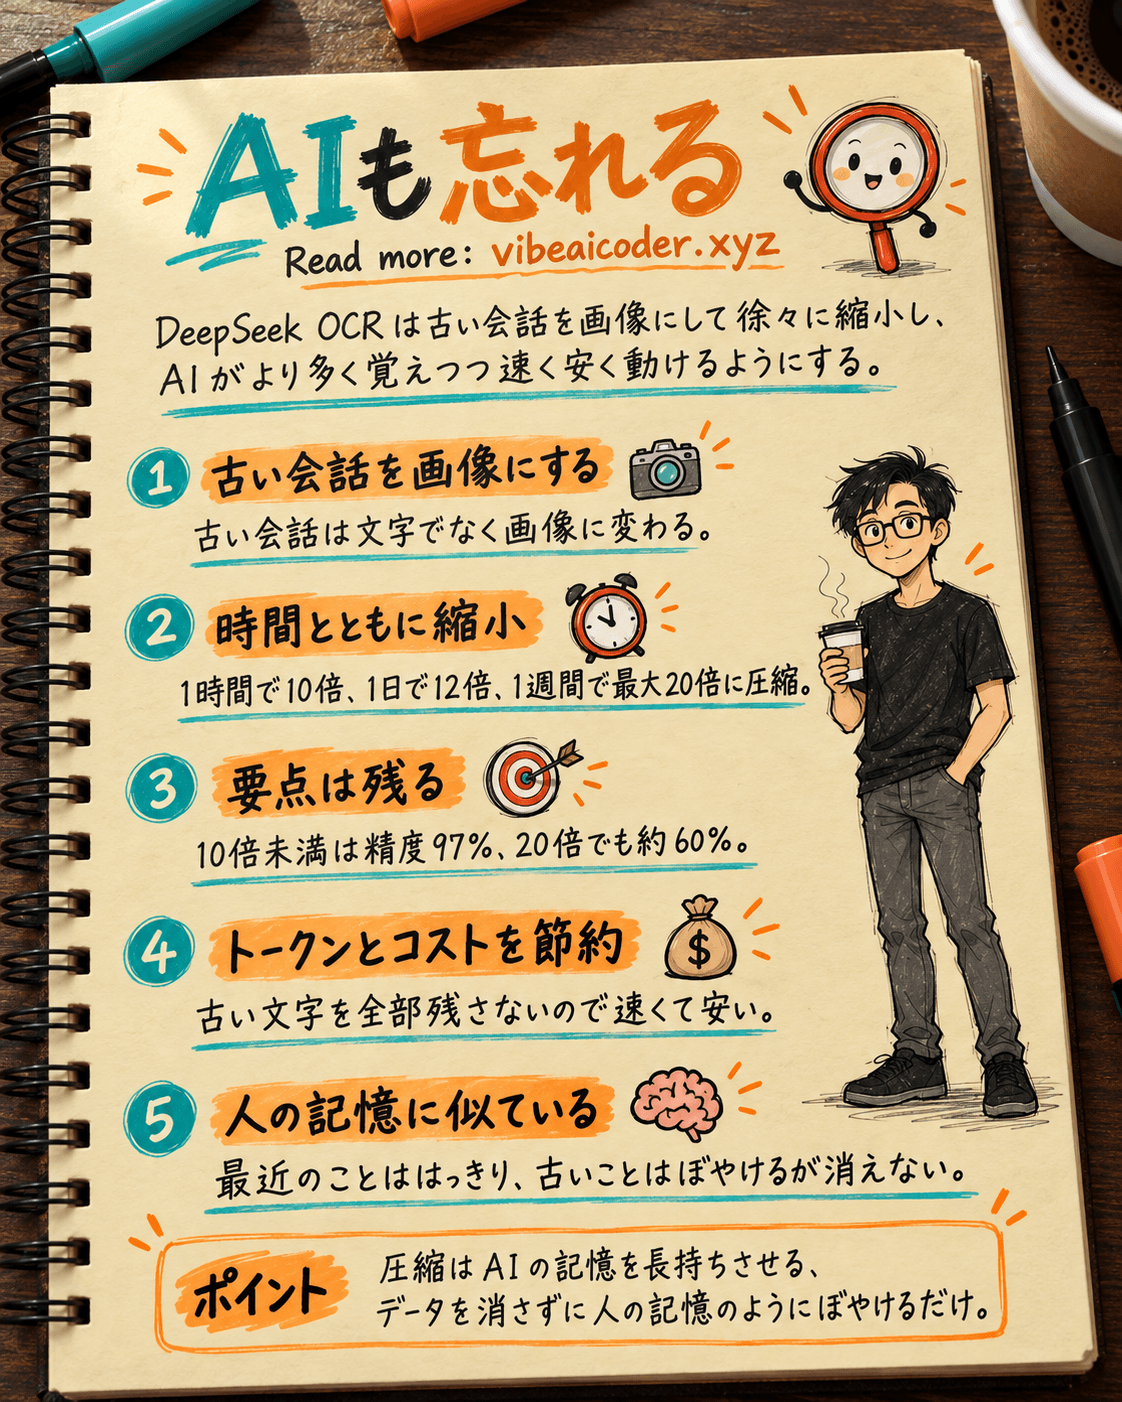
DeepSeek OCRは、会話の古い部分を画像に変え、時間とともにその画像を少しずつ縮小していく新しい技術です。これは人間の記憶が薄れていく様子によく似ています。これによりAIは、すべての言葉をフル解像度で覚えておかなくても、とても長い会話の内容を把握できるようになり、トークン(AIが文章を数え、課金の単位にも使う単位)と計算コストを大きく節約できます。この考え方は、人気の科学チャンネルTwo Minute Papersが最近改めて紹介したもので、DeepSeekのContexts Optical Compressionという研究に基づいています。基本をまず理解したい方は、AI là gìの解説記事もあわせてご覧ください。
 身近な例でざっくり理解する
毎回の会話を文字で打ち直す代わりに、スクリーンショットを撮ると想像してみてください。鮮明なスクリーンショットは元の文章とほぼ同じに見えますが、その画像を何度も縮小していくと文字はどんどんぼやけていき、最後には細かいカンマまでは読み取れず、大まかな内容しかわからなくなります。DeepSeek OCRはAIの会話の古い部分に対してまさにこれを行います。文字を画像に変え、時間が経つにつれてその画像を縮小し続けるのです。昨日の出来事ははっきり覚えていても、一年前の出来事はぼんやりとしか覚えていないのと同じ感覚です。
 実際の仕組み
- 会話の最新部分は、AIが正確に答えられるよう、フル解像度の文字のまま保持されます。
- 約1時間前の会話部分は中程度の解像度の画像として「撮影」され、元の文字に対しておよそ10倍に圧縮されます。
- 約1日前の会話はさらに圧縮され、およそ12倍になります。
- 1週間以上前の会話は最も強く圧縮され、15倍から20倍に達し、文字はほぼぼやけてしまいますが、大まかな内容は残ります。
- 内部では、DeepSeek OCRは画像を読み取る部分と小さなデコーダーという2つの要素を使っています。画像読み取り部分は、文書1ページ全体をわずか約100個の画像トークンに変換でき、これまで必要だった数千個の文字トークンよりはるかに少なくて済みます。研究チームの測定によると、圧縮率が10倍未満の場合、読み取り精度は97%に達し、20倍まで圧縮しても精度は約60%にとどまり、それでも要点をつかむには十分とのことです。
AIが会話の途中で「忘れた」ように見える理由をさらに詳しく知りたい方は、Context Window là gìとToken là gì trong AIもあわせてお読みください。
 これがあなたにとって意味すること
- 話が途切れない長い会話: もしこの技術が一般的なAIアシスタントに取り入れられれば、非常に長いセッションの中で何度も質問を重ねても、AIは最初に話した内容の要点を覚えていられるようになります。
- AI利用コストの低下: AIが古い会話のすべてのトークンを保持する必要がなくなるため、コストが下がる可能性があります。これは以前、あるPythonライブラリがAIエージェントのコンテキストウィンドウのトークンを最大80%節約するのに役立った事例に似ていますが、今回は画像をベースにした別のアプローチです。
- チャット以外の用途: 研究チームによると、この技術は大量の文書をスキャンする用途にも使え、A100を1枚使うだけで1日に20万ページ以上の学習データを生成でき、PDF処理速度は毎秒約2500トークンに達するといいます。
 よくある誤解
- 「AIが忘れるというのは、古いデータが削除されるということ」 実際には:これは損失を伴う圧縮であり、古い情報は消えるのではなく、縮小された写真のようにぼやけた状態で残っています。
- 「この機能はすでにChatGPTやClaudeに搭載されている」 実際には:これはDeepSeekのオープンソース研究であり、現時点では主に文書読み取り(OCR)に使われています。この段階的に忘れていく仕組みを主要なチャットボットに導入すると発表した大手AI企業はまだありません。
- 「文字を画像に圧縮してトークンを節約するというのは全く新しい発想」 実際には:古い会話を要約して記憶領域を節約するという発想は以前からありました。DeepSeek OCRは、従来の方法よりもはるかに効果的に圧縮できる画像ベースの手法を新たに示しただけです。
よくある質問
DeepSeek OCRは新しいチャットボットですか? いいえ。これは文書や画像を読み取ることに特化したモデル(OCR)で、今回光学的なコンテキスト圧縮の仕組みが追加されたものです。ChatGPTやClaudeのように直接会話するチャットボットではありません。
画像ベースの圧縮によって、AIが古い情報を間違って答えることはありますか? あります。ずいぶん前の会話の細かい部分について質問した場合、最も強い圧縮レベルでは精度が約60%まで下がります。ただし、最近の内容や中程度の圧縮であれば、精度は97%以上を維持します。
この技術はいつ普段使いのAIアプリに登場しますか? DeepSeekはすでにコードとモデルをオープンソースとして公開し、開発者が自由に試せるようにしていますが、ChatGPT、Claude、Geminiなどの主要なチャットボットは、この忘却の仕組みを採用するとはまだ発表していません。
全部の文字をそのまま残さず、なぜわざわざ圧縮するのですか? 非常に長い会話の文字をすべて保持すると大量のトークンを消費し、計算コストが上がり、応答も遅くなります。圧縮することで、AIは高速かつ低コストを保ちながら、より多くの内容を覚えておけるようになります。
これを理解するのにプログラミングの知識は必要ですか? 必要ありません。これは、AIがリソースを使いすぎることなく長い会話を覚えておけるようにする賢い工夫だと理解すれば十分です。人間の脳が最近の出来事をはっきり覚え、古い記憶を少しずつ薄れさせていくのとよく似ています。
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止