AI học như thế nào: dữ liệu huấn luyện, huấn luyện trước và tinh chỉnh
 AI học như thế nào, dữ liệu huấn luyện, huấn luyện trước và tinh chỉnh là gì
AI như Claude hay ChatGPT không "biết" mọi thứ từ khi sinh ra. Nó học qua một quy trình nhiều bước: đọc một lượng khổng lồ văn bản để hiểu ngôn ngữ, rồi được chỉnh sửa thêm để trả lời đúng ý con người. Hiểu quy trình này giúp bạn biết vì sao AI giỏi một số việc, dở một số việc khác, và vì sao câu trả lời của nó có thể lỗi thời hoặc sai lệch.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng việc đào tạo một AI giống như đào tạo một nhân viên mới.
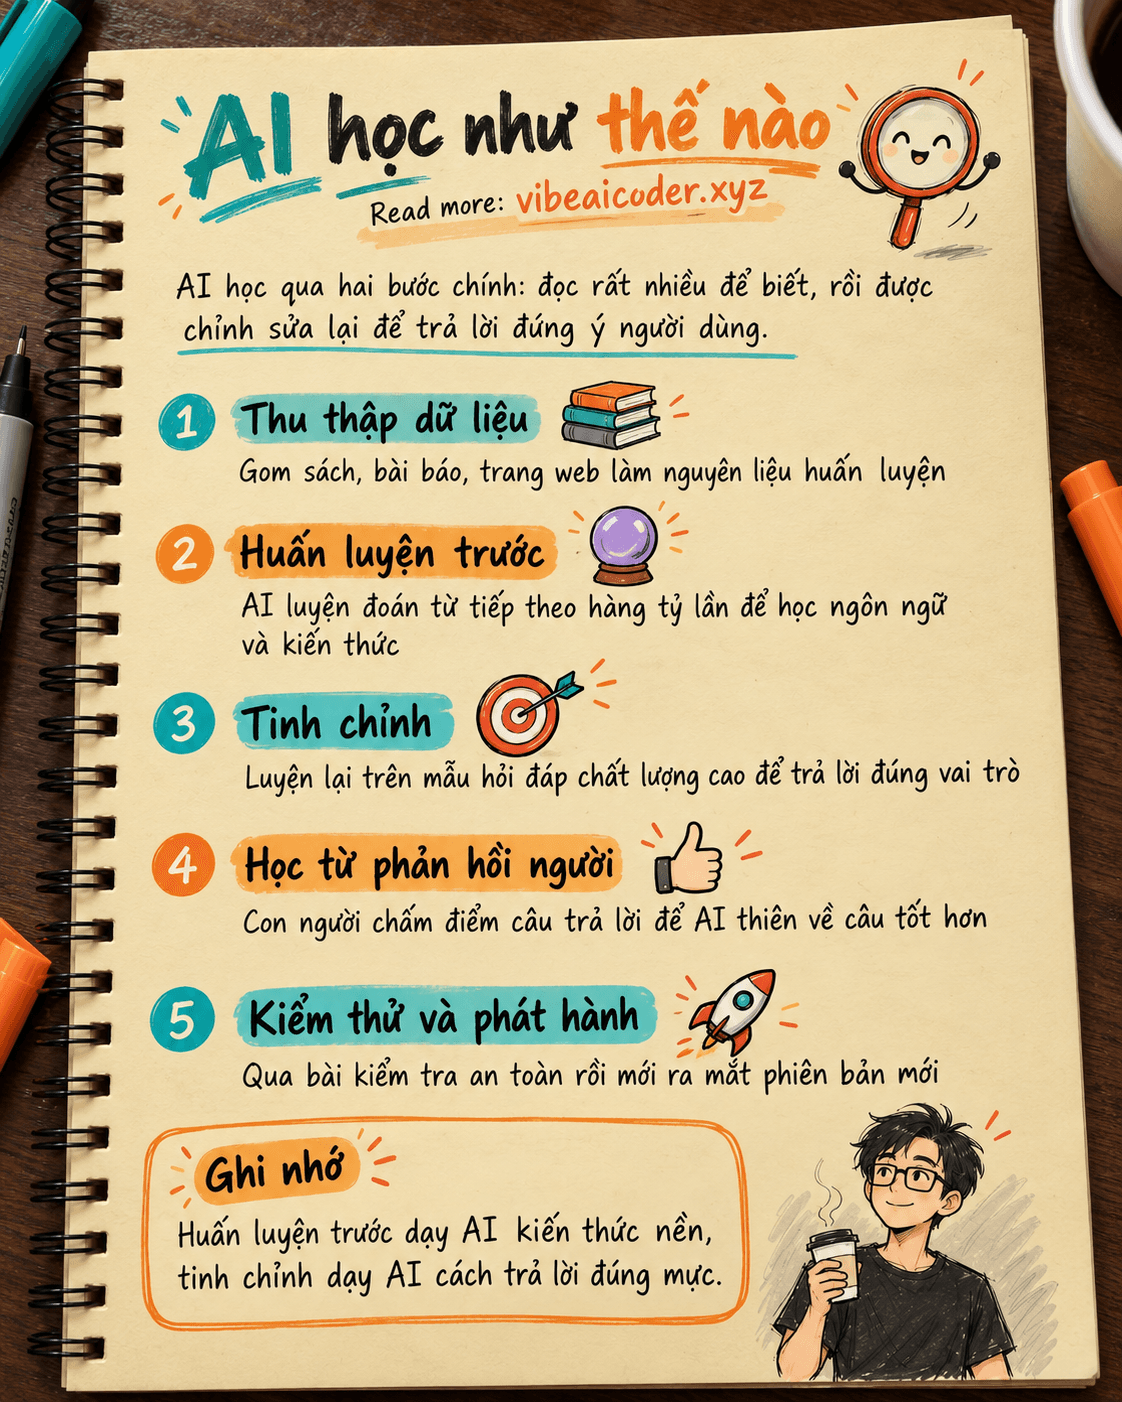
Đầu tiên, người này đọc hàng triệu cuốn sách, bài báo, trang web suốt nhiều năm để tích lũy kiến thức tổng quát về thế giới, cách hành văn, cách lập luận. Đây là giai đoạn đọc để biết (huấn luyện trước, tiếng Anh là pretraining). Sau giai đoạn này, người đó biết rất nhiều thứ nhưng chưa biết cách làm việc theo đúng yêu cầu của công ty: chưa biết trả lời ngắn gọn, chưa biết từ chối việc nguy hiểm, chưa quen văn phong lịch sự.
Vì vậy công ty cho người này học thêm một khóa đào tạo nội bộ ngắn hơn, có người giám sát chỉnh sửa trực tiếp: cách trả lời khách hàng, cách từ chối yêu cầu sai quy định, cách trình bày gọn gàng. Đây là giai đoạn luyện lại cho đúng việc (tinh chỉnh, fine-tuning), thường đi kèm một bước học từ phản hồi của con người để AI "hiểu ý" người dùng hơn.
AI cũng được đào tạo theo đúng hai giai đoạn này: đọc nhiều trước, rồi chỉnh sửa sau.
 Nó hoạt động thế nào
1. Thu thập dữ liệu huấn luyện. Các công ty AI gom một khối lượng văn bản khổng lồ: sách, bài báo, trang web, tài liệu kỹ thuật, đoạn hội thoại mẫu. Đây chính là dữ liệu huấn luyện, nguyên liệu đầu vào quyết định AI biết gì và không biết gì. Nếu dữ liệu không có thông tin sau một thời điểm nào đó, AI sẽ không biết chuyện xảy ra sau đó, trừ khi nó được nối mạng để tra cứu thêm.
2. Huấn luyện trước (pretraining). AI được cho "đọc" toàn bộ dữ liệu đó và luyện một việc rất đơn giản lặp đi lặp lại hàng tỷ lần: đoán từ tiếp theo trong câu. Việc đoán từ nghe có vẻ tầm thường, nhưng để đoán đúng, AI buộc phải học được ngữ pháp, kiến thức thực tế, cách lập luận, thậm chí cả một phần logic toán học ẩn trong văn bản. Giai đoạn này tốn rất nhiều máy tính và thời gian, tạo ra cái gọi là mô hình nền (base model), hiểu nhiều nhưng chưa biết cách trò chuyện đúng mực.
3. Tinh chỉnh theo hội thoại (fine-tuning). Mô hình nền được huấn luyện thêm trên một tập dữ liệu nhỏ hơn nhiều, gồm các mẫu hỏi đáp chất lượng cao do con người viết hoặc chọn lọc. Bước này dạy AI cách trả lời đúng định dạng câu hỏi, giữ đúng vai trò trợ lý, không trả lời theo kiểu "viết tiếp đoạn văn" nữa mà trả lời thẳng vào câu hỏi.
4. Học từ phản hồi của con người. Sau tinh chỉnh cơ bản, AI tạo ra nhiều câu trả lời cho cùng một câu hỏi, người đánh giá chấm câu nào tốt hơn, và mô hình được điều chỉnh để thiên về những câu trả lời được chấm cao. Đây là bước giúp AI trở nên hữu ích hơn, an toàn hơn, biết từ chối những yêu cầu có hại. Ở Claude, Anthropic gọi chung các kỹ thuật này là huấn luyện để trở thành trợ lý "hữu ích, trung thực và vô hại".
5. Kiểm thử và phát hành. Trước khi ra mắt, mô hình được kiểm tra qua hàng loạt bài kiểm tra (benchmark) và thử nghiệm an toàn. Sau khi phát hành, mô hình gần như không "học thêm" từ những cuộc trò chuyện của bạn theo thời gian thực, nó vẫn là phiên bản đã huấn luyện xong cho đến khi công ty phát hành phiên bản mới.
 Điều này có ý nghĩa gì với bạn
Biết quy trình này giúp bạn dùng AI thực tế hơn, thay vì kỳ vọng sai:
- AI có "ngày chốt kiến thức". Vì dữ liệu huấn luyện được thu thập đến một mốc thời gian nhất định, AI có thể không biết sự kiện mới gần đây. Nếu cần tin tức mới, hãy hỏi AI có khả năng tra cứu web, hoặc tự cung cấp thông tin mới trong câu hỏi.
- Fine-tuning giải thích vì sao các AI "giống mà khác". Hai mô hình có thể dùng chung kiến thức nền tảng gần giống nhau, nhưng được tinh chỉnh khác nhau nên trả lời khác phong cách, khác mức độ thận trọng. Đó là lý do Claude, ChatGPT, Gemini trả lời cùng một câu hỏi theo giọng điệu khác nhau.
- Bạn hiếm khi cần tự tinh chỉnh mô hình. Với hầu hết công việc hàng ngày, viết một prompt rõ ràng, có ví dụ mẫu, là đủ để AI làm đúng ý bạn, không cần đụng đến việc huấn luyện lại mô hình (việc này tốn kém và chỉ doanh nghiệp lớn mới cần). Bài Fine-tuning là gì giải thích rõ khi nào mới thật sự cần bước này.
 Hiểu lầm thường gặp
- "AI tự học thêm sau mỗi lần tôi trò chuyện với nó." Sai. Một cuộc trò chuyện thông thường không làm thay đổi mô hình. AI chỉ đọc lại đoạn hội thoại hiện tại (nằm trong cửa sổ ngữ cảnh) để trả lời, chứ không ghi nhớ vĩnh viễn trừ khi ứng dụng có tính năng trí nhớ riêng được bật rõ ràng.
- "Dữ liệu huấn luyện càng nhiều thì AI càng đúng." Không hẳn. Dữ liệu nhiều giúp AI biết rộng hơn, nhưng dữ liệu sai lệch, thiên vị hoặc chất lượng thấp sẽ khiến AI học luôn cả lỗi đó. Chất lượng dữ liệu quan trọng không kém số lượng.
- "Huấn luyện trước và tinh chỉnh là một bước giống nhau." Không. Huấn luyện trước là giai đoạn tốn nhiều tài nguyên nhất, dạy AI kiến thức nền. Tinh chỉnh là bước sau, nhẹ hơn nhiều, dạy AI cách cư xử đúng vai trò trợ lý.
 Câu hỏi thường gặp
AI có tiếp tục học từ dữ liệu của tôi khi tôi trò chuyện không? Thông thường không, tùy chính sách từng ứng dụng. Một số dịch vụ có hỏi xin phép dùng dữ liệu trò chuyện để cải thiện mô hình trong tương lai, nhưng đó là việc huấn luyện phiên bản sau, không phải AI "học ngay lập tức" trong lúc bạn đang chat.
Vì sao AI đôi khi trả lời sai dù kiến thức rất rộng? Vì AI được huấn luyện để đoán câu trả lời có khả năng đúng cao nhất dựa trên mẫu đã học, không phải tra cứu một cơ sở dữ liệu sự thật cố định. Khi dữ liệu huấn luyện thiếu hoặc mơ hồ về một chủ đề, AI vẫn có thể "đoán" ra một câu nghe hợp lý nhưng sai, hiện tượng này gọi là ảo giác.
Tinh chỉnh có làm AI kém thông minh hơn không? Không, tinh chỉnh không lấy đi kiến thức nền mà mô hình đã học ở giai đoạn huấn luyện trước. Nó chỉ định hướng lại cách mô hình dùng kiến thức đó để trả lời đúng mực hơn.
Tôi có thể tự huấn luyện một AI như Claude tại nhà không? Huấn luyện trước một mô hình lớn từ đầu cần hạ tầng máy tính khổng lồ, chi phí hàng triệu đô la, nên gần như chỉ các công ty lớn mới làm được. Việc cá nhân hoặc doanh nghiệp nhỏ có thể làm là tinh chỉnh nhẹ một mô hình có sẵn, hoặc đơn giản hơn là viết prompt tốt và cung cấp ví dụ mẫu.
Mô hình ngôn ngữ lớn (LLM) có phải chính là kết quả của quy trình này không? Đúng. "LLM" là tên gọi chung cho loại mô hình được tạo ra qua đúng quy trình huấn luyện trước rồi tinh chỉnh như bài viết mô tả. Bạn có thể đọc thêm trong bài LLM là gì để hiểu sâu hơn về cách AI "đoán chữ tiếp theo".
Muốn tìm hiểu tổng quan hơn về Claude, bạn có thể đọc bài Claude AI là gì, hoặc tìm hiểu vì sao các dịch vụ AI tính phí theo token, đơn vị nhỏ nhất mà mô hình xử lý trong cả hai giai đoạn huấn luyện lẫn khi bạn trò chuyện.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
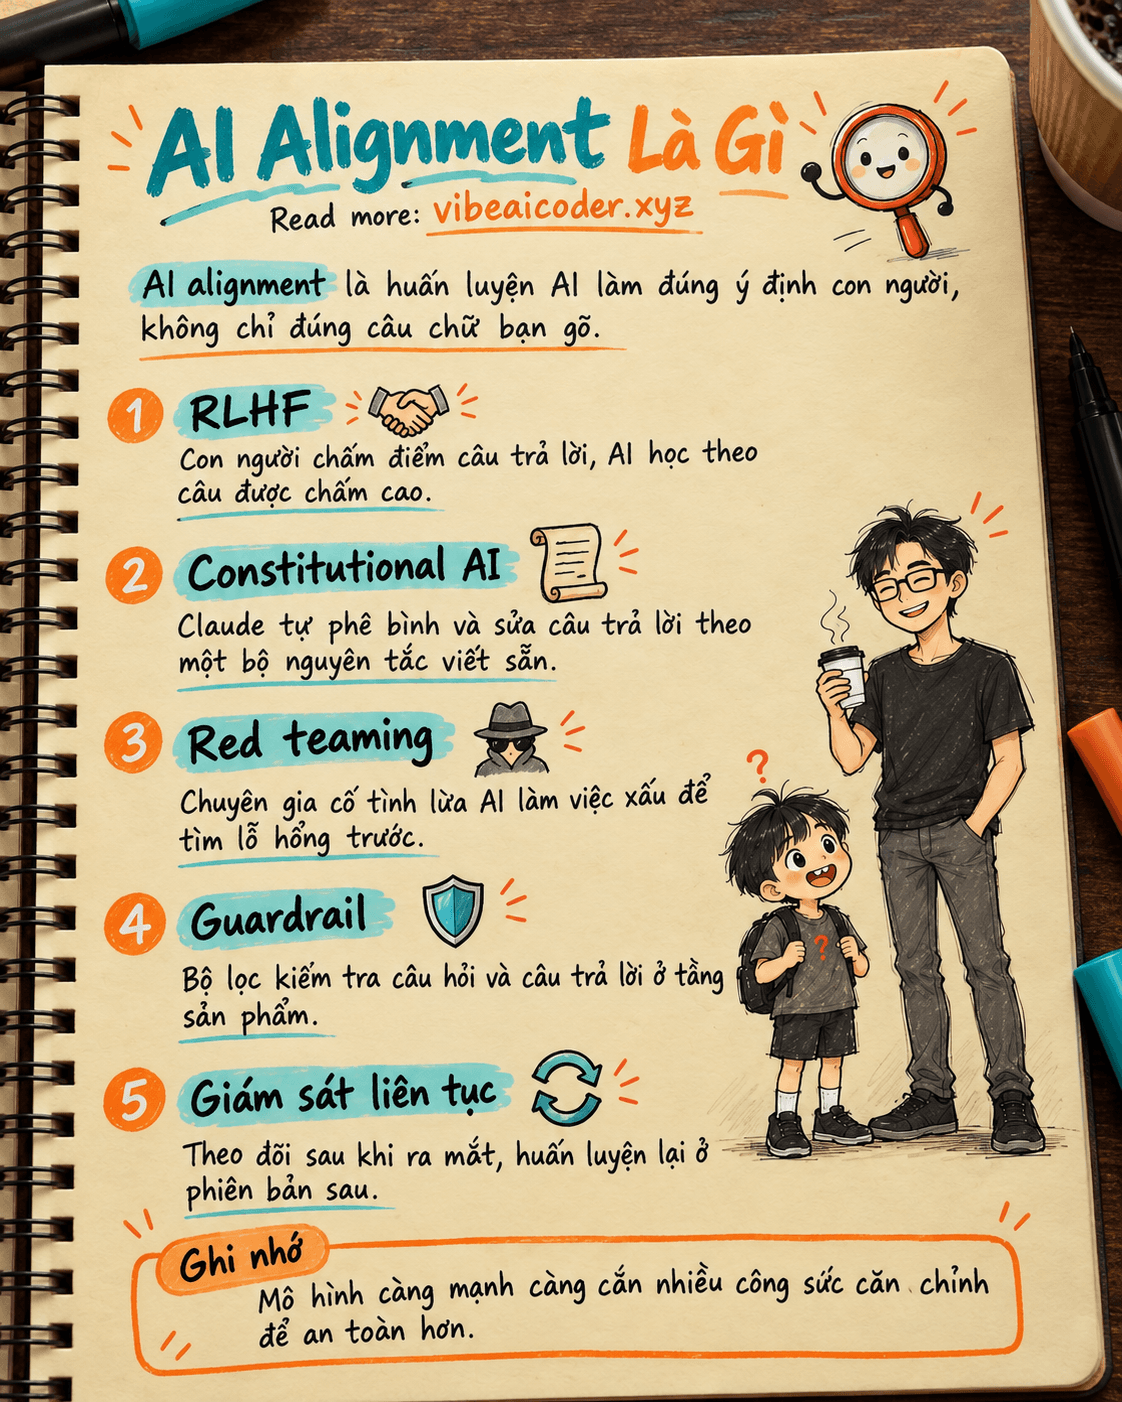
 AI alignment là gì? Vì sao công ty AI phải dạy mô hình điều không nên làm