Mixture of Experts (MoE) là gì? Vì sao AI khổng lồ vẫn trả lời nhanh
Mixture of Experts (MoE) là gì? Vì sao AI khổng lồ vẫn trả lời nhanh
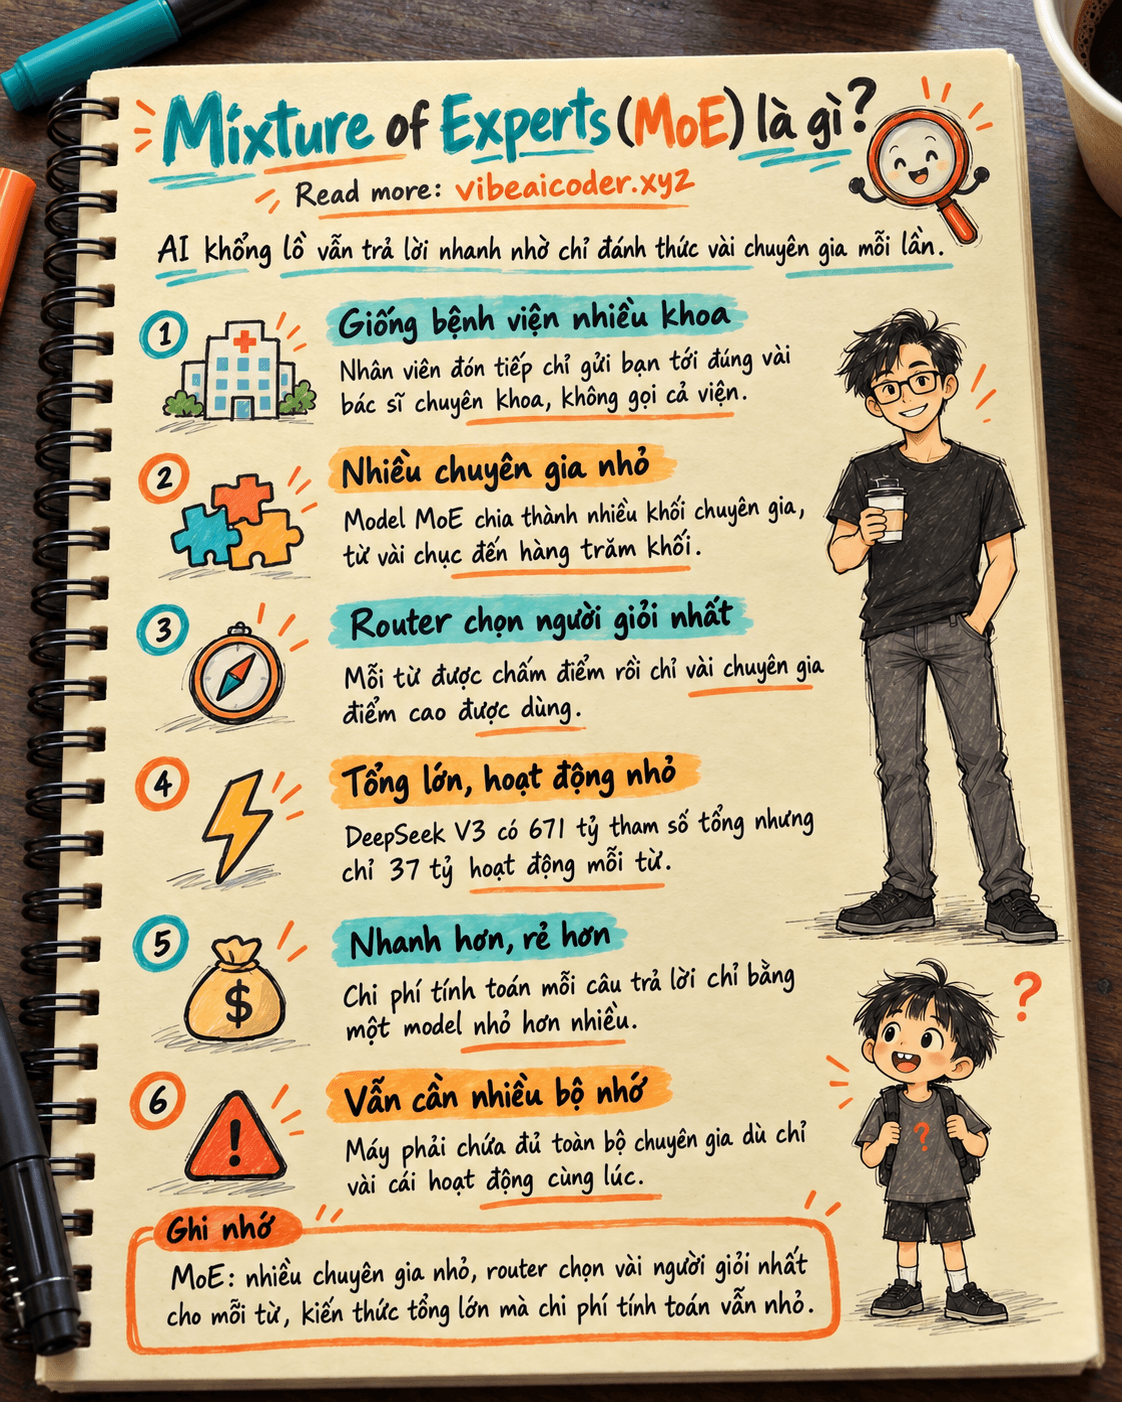
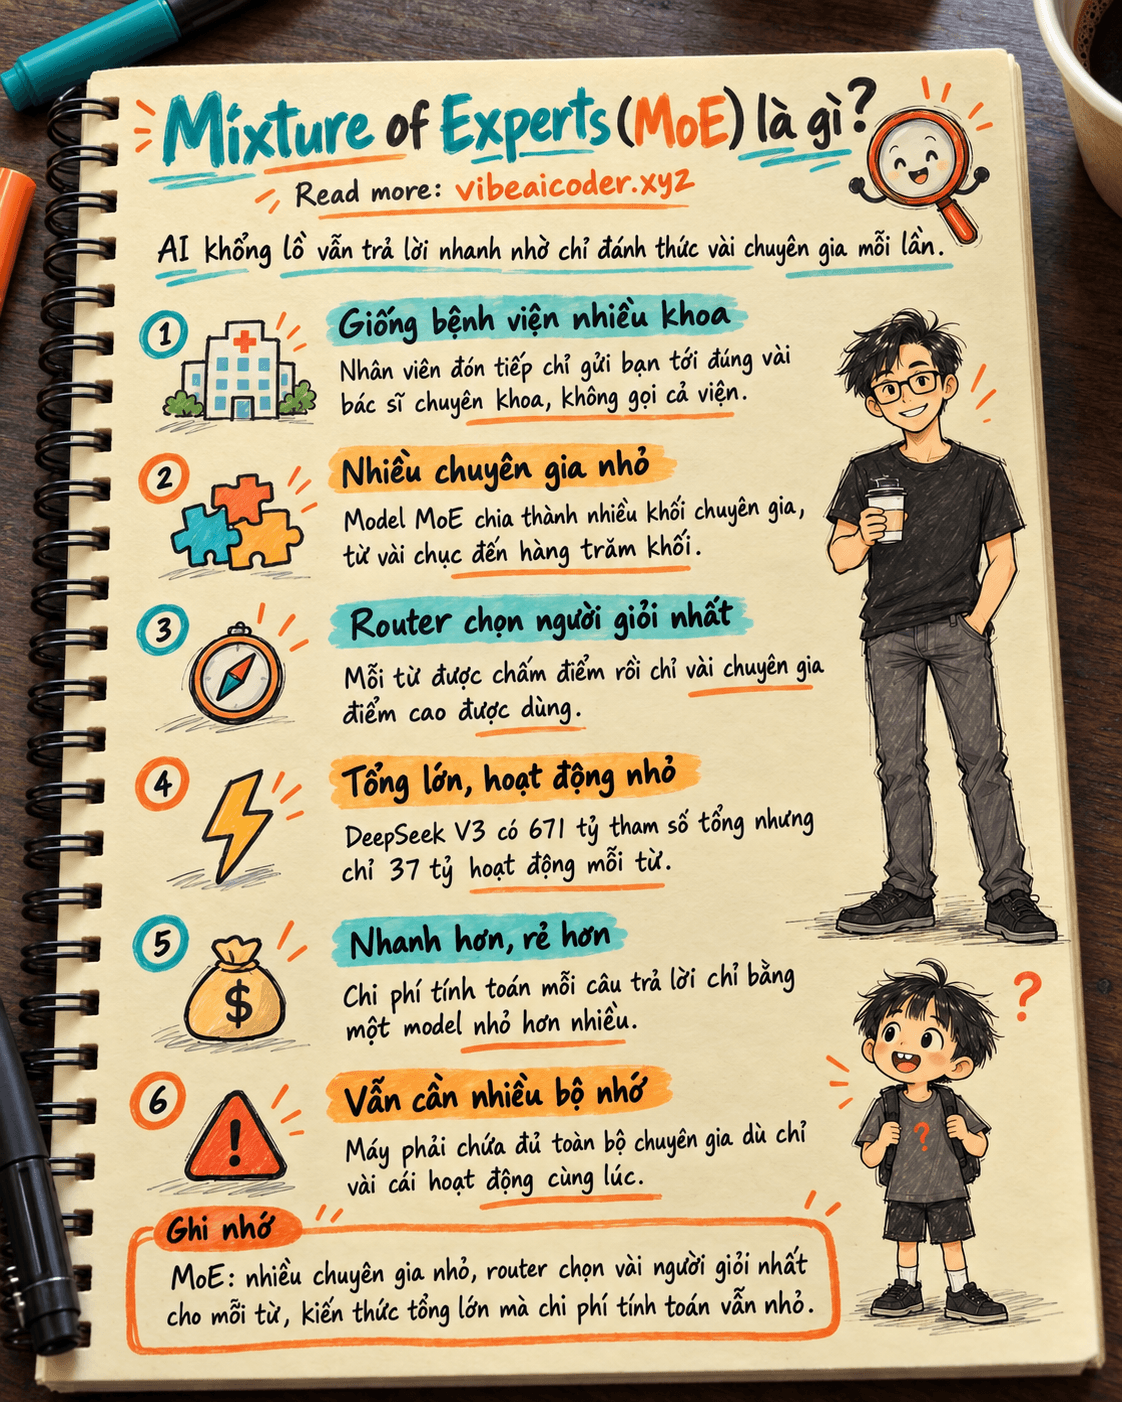
Mixture of Experts, viết tắt là MoE, là một cách thiết kế bộ não AI gồm nhiều "chuyên gia" nhỏ thay vì một khối kiến thức khổng lồ dùng chung cho mọi câu hỏi. Khi bạn gửi một câu hỏi, AI không huy động toàn bộ các chuyên gia đó, nó chỉ chọn ra vài chuyên gia phù hợp nhất để trả lời. Nhờ vậy, một model có thể chứa lượng kiến thức cực lớn mà vẫn trả lời nhanh và tốn ít tài nguyên hơn nhiều so với việc dùng toàn bộ bộ não cho mọi câu hỏi. Đây là một trong những ý tưởng nền tảng giúp bạn hiểu rõ hơn AI là gì ở tầng kỹ thuật bên dưới.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng một bệnh viện lớn có hàng trăm bác sĩ chuyên khoa: tim mạch, da liễu, nhi khoa, xương khớp... Khi bạn đến khám, lễ tân (người gác cổng) không gọi tất cả bác sĩ cùng vào phòng khám cho bạn. Lễ tân chỉ xem triệu chứng rồi gửi bạn tới đúng hai ba bác sĩ chuyên khoa liên quan nhất. Bạn vẫn đang khám ở một bệnh viện có đầy đủ mọi chuyên khoa, nhưng mỗi lần khám chỉ dùng đúng vài người, nên nhanh và đỡ tốn công hơn hẳn so với việc huy động cả viện cho một ca bệnh đơn giản.
MoE hoạt động y như vậy. Model gồm nhiều "chuyên gia" (các mạng nơ ron nhỏ, mỗi cái học một kiểu kiến thức), cộng với một "lễ tân" gọi là bộ định tuyến (router). Với mỗi từ bạn gõ vào, bộ định tuyến chấm điểm rồi chọn ra một số ít chuyên gia phù hợp nhất để xử lý, sau đó gộp câu trả lời của họ lại thành kết quả cuối cùng.
 Nó hoạt động thế nào
- Model MoE được chia thành nhiều khối "chuyên gia" (expert), có thể từ vài chục đến hàng trăm khối tùy model.
- Mỗi khi xử lý một từ (token), một mạng nhỏ gọi là router sẽ chấm điểm xem chuyên gia nào phù hợp nhất với từ đó.
- Router chỉ chọn ra một số ít chuyên gia có điểm cao nhất, ví dụ hai trong số tám, để thực sự tính toán. Các chuyên gia còn lại đứng yên, không dùng đến cho từ này.
- Kết quả của các chuyên gia được chọn sẽ được gộp lại theo trọng số để ra câu trả lời cho từ đó.
- Vì chỉ một phần nhỏ của model "thức dậy" cho mỗi từ, nên dù tổng số tham số của cả model rất lớn, lượng tính toán thực tế cho mỗi câu trả lời vẫn nhỏ. Người ta gọi đó là tham số tổng (total parameters) và tham số hoạt động (active parameters).
Ví dụ thực tế: Mixtral 8x7B của Mistral AI có tám chuyên gia, mỗi lần xử lý một từ chỉ hai trong số tám chuyên gia được dùng. DeepSeek-V3, một trong những model mã nguồn mở nổi bật gần đây, còn ấn tượng hơn: tổng cộng khoảng 671 tỷ tham số, nhưng mỗi từ chỉ có khoảng 37 tỷ tham số thực sự hoạt động. Nghĩa là model mang trong mình lượng kiến thức cỡ 671 tỷ tham số, nhưng chi phí tính toán cho mỗi câu trả lời chỉ tương đương một model 37 tỷ tham số.
 Điều này có ý nghĩa gì với bạn
- Vì sao có model "siêu to khổng lồ" mà bạn vẫn dùng được với giá hợp lý: kiến trúc MoE là một lý do lớn. Công ty có thể huấn luyện model chứa lượng kiến thức như một model cực lớn, nhưng chi phí chạy (inference) lại rẻ như model nhỏ hơn nhiều, nên họ có thể đưa ra mức giá API dễ chịu hơn.
- Khi so sánh thông số kỹ thuật giữa các model, con số "tổng tham số" nghe rất to (ví dụ 671 tỷ) không có nghĩa model đó chạy chậm hay tốn kém như con số đó gợi ý. Nếu tài liệu có ghi thêm "active parameters", đó mới là con số phản ánh tốc độ và chi phí thực tế mỗi lần bạn hỏi.
- Nếu bạn định tự chạy một model mã nguồn mở dùng MoE ở nhà (qua Ollama hay một server riêng), vẫn cần đủ bộ nhớ để chứa toàn bộ các chuyên gia dù chỉ vài chuyên gia hoạt động cùng lúc. Đây là điểm dễ hiểu lầm nhất: MoE giúp tính toán nhanh hơn chứ không giúp giảm dung lượng lưu trữ cần có, khác với lượng tử hóa (quantization) vốn giúp giảm cả dung lượng lẫn tốc độ.
 Hiểu lầm thường gặp
- "MoE nghĩa là model yếu hơn vì chỉ dùng một phần bộ não": Sai. MoE thường giúp model mạnh hơn ở cùng một chi phí tính toán, vì nó cho phép nhồi nhiều kiến thức chuyên biệt hơn mà không làm chậm tốc độ trả lời.
- "Mỗi chuyên gia chuyên về một chủ đề như y học, luật, hay lập trình": Thường không rõ ràng như vậy trong thực tế. Các chuyên gia học cách chia việc dựa trên đặc điểm thống kê của dữ liệu trong lúc huấn luyện, không nhất thiết theo chủ đề mà con người dễ đặt tên.
- "Model MoE luôn chạy nhanh hơn mọi model khác cùng kích thước": Chỉ đúng khi so với model có tổng tham số tương đương. So với một model nhỏ, "dày đặc" (dense) cùng tốc độ xử lý, MoE không tự động nhanh hơn. Lợi thế thật sự của nó là mang được lượng kiến thức lớn trong khi tốc độ vẫn nhỏ gọn.
 Câu hỏi thường gặp
MoE khác gì với model "dense" (dày đặc) thông thường? Model dense dùng toàn bộ tham số cho mọi từ bạn hỏi. Model MoE có nhiều khối chuyên gia nhưng chỉ bật một phần nhỏ cho mỗi từ, nên tiết kiệm tính toán hơn ở cùng mức kiến thức.
Những model nào đang dùng kiến trúc MoE? Mixtral của Mistral AI, DeepSeek-V3 và các bản sau, một số bản Qwen, cùng nhiều model mã nguồn mở khác. Một vài công ty lớn cũng được cho là dùng kiến trúc tương tự cho các model đóng, dù không công bố chi tiết kỹ thuật.
Là người dùng bình thường, tôi có cần quan tâm đến MoE không? Không bắt buộc, nhưng biết khái niệm này giúp bạn hiểu vì sao một model "khổng lồ" vẫn trả lời nhanh, và đọc thông số kỹ thuật của model chính xác hơn khi so sánh các lựa chọn.
MoE có làm AI kém chính xác hơn không? Không tự động như vậy. Chất lượng phụ thuộc vào cách huấn luyện và cách cân bằng tải giữa các chuyên gia, không phải do bản thân kiến trúc MoE. Nhiều model MoE hiện đại đạt điểm benchmark ngang hoặc vượt model dense cùng chi phí tính toán.
Tôi có thể tự chạy một model MoE trên máy cá nhân không? Về lý thuyết có, nếu máy đủ RAM hoặc VRAM để chứa toàn bộ các chuyên gia. Với các model MoE rất lớn như DeepSeek-V3 (671 tỷ tham số tổng) thì cần phần cứng cấp server, không phải máy tính cá nhân thông thường. Model MoE nhỏ hơn như Mixtral 8x7B thì vừa sức với một số máy tính mạnh.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 Context caching là gì? Vì sao dùng lại ngữ cảnh giúp AI nhanh và rẻ hơn
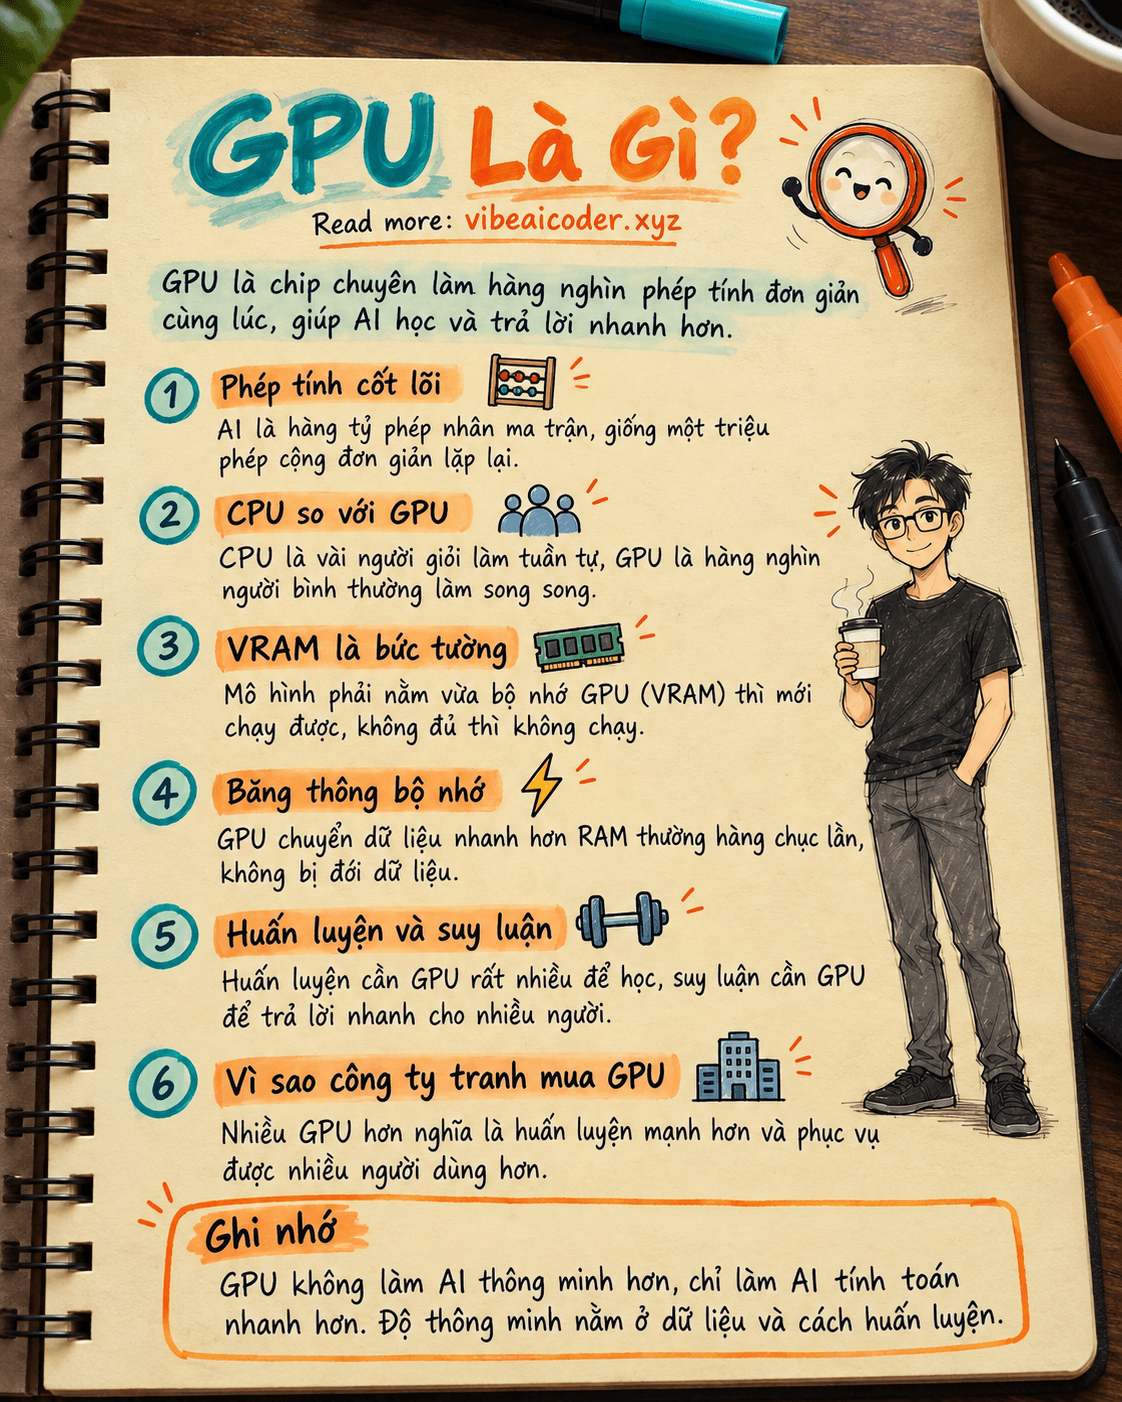
 GPU Là Gì? Vì Sao AI Cần Chip Đồ Họa Mạnh Để Huấn Luyện Và Chạy