什么是上下文窗口?为什么AI在对话中突然忘记
 什么是上下文窗口?为什么AI在对话中突然"忘记"了
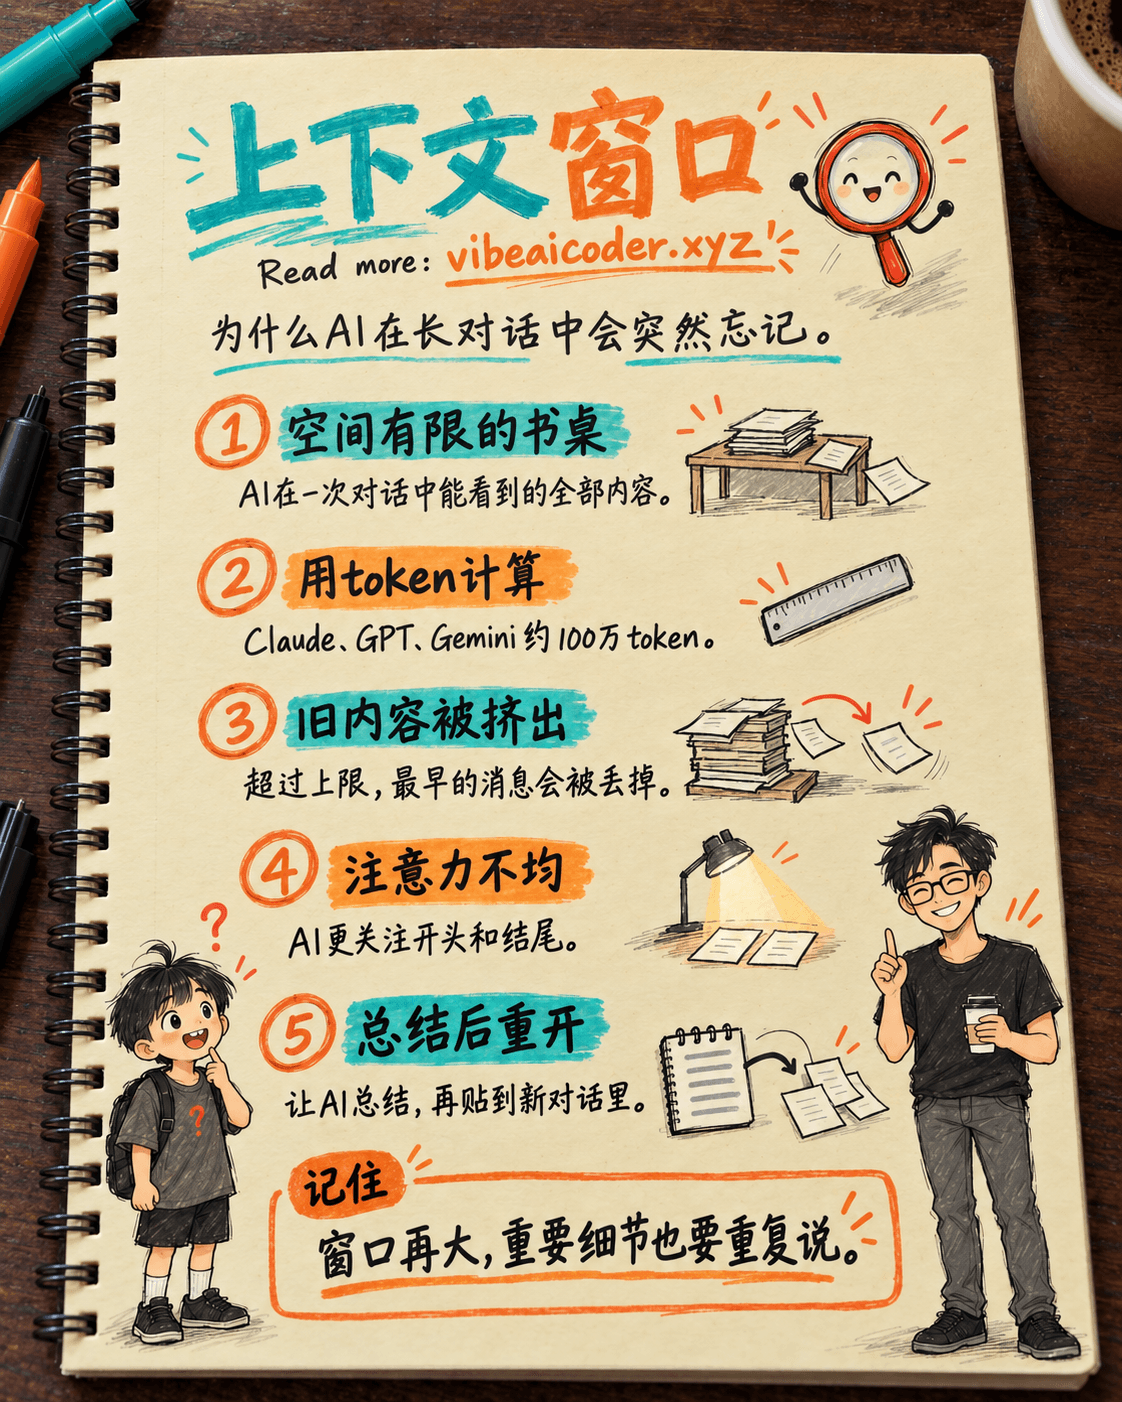
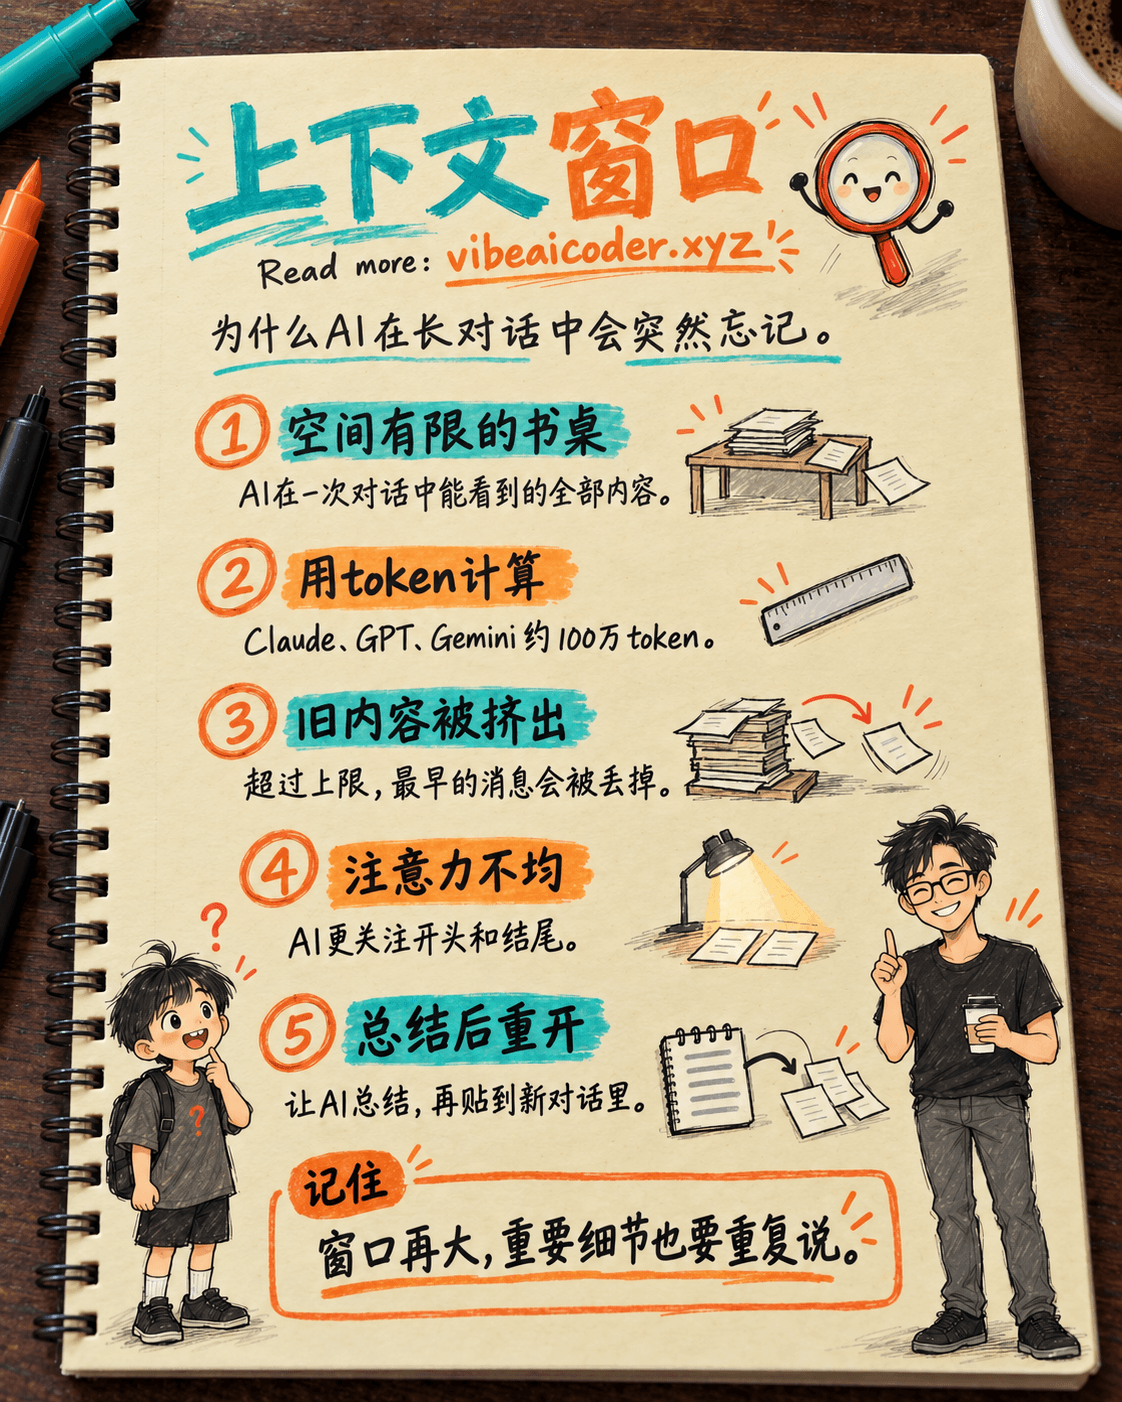
**上下文窗口(context window)**是指Claude、ChatGPT、Gemini这类AI在一次对话中能够同时"看到"的最大文本量,包括你至今输入的所有内容和AI已经回复的内容。可以把它理解为AI在这次会话中的短期记忆:一旦超过这个限制,最早的部分就会被挤出去,AI也就不再记得了。
如果你曾遇到AI突然答非所问、忘记你之前提到的细节,或者记不住你几十条消息之前起的人物名字,很可能就是对话已经触及了上下文窗口的上限。这篇文章用最简单的语言解释这个概念。
 把它想象成一张空间有限的书桌
想象AI坐在一张书桌前。对话中的每一条消息,无论是你写的还是AI回复的,都会被放到这张桌子上,供AI阅读和思考后作答。这张桌子的大小是固定的。当纸张(消息)越堆越多、占满整张桌子时,最早的那些就必须被收走,好腾出空间放新的。
上下文窗口就是这张桌子的大小。 桌子越大,AI能同时保留的内容就越多:对话可以更长,文档可以更长,能同时处理更多文件,而不会忘记最开始的部分。
有一点很关键:上下文窗口只存在于单次会话之内。它不是AI跨越多天的长期记忆(像Claude这类产品新增了跨对话记忆的功能,但那是一项独立的能力,并不是上下文窗口本身)。
 目前的上下文窗口有多大
上下文窗口是以**token(词元)**为单位计算的,而不是字符或单词。token是AI模型在处理文本前,将其切分出来的最小单位。
截至2026年,主流AI模型的上下文窗口已经远远超过几年前的水平:
- Claude(Sonnet和Opus):通过API大约可达100万token,相当于几千页的内容。
- 较新的GPT模型:也大约在100万多token。
- Gemini:部分版本达到100万到200万token,某些专用版本甚至更高。
换算一下,100万token大约相当于70万到75万个英文单词,几乎可以把好几部长篇小说一次性塞进一个提示词里。不过,你日常使用的大多数免费聊天应用(Claude.ai网页版、ChatGPT、Gemini)通常会把实际可用的上下文窗口限制得比模型理论上限更低,目的是控制运行成本。完整的上限通常只有通过API或更高级的付费方案才能用到。
😵 为什么窗口有上百万token,AI还是会"忘记"
窗口更大并不等于完美的记忆力。原因主要有三个:
- 桌子终究是有限的。 如果你粘贴了一份很长的文档,又加了几个文件,再聊上几百条消息,总的token数仍可能超过上限。这时,对话最早的部分就会被挤出去。
- 记得多不等于注意力均匀。 AI模型往往更关注上下文窗口的开头和结尾部分;而中间的内容,尤其是在非常长的上下文中,有时处理得不够细致。这是真实存在的技术限制,并不是AI"偷懒"。
- 聊天界面本身也可能设置了自己的上限,如前所述是为了控制成本,所以网页版对话可能比模型理论上限截断得更早。
换句话说,上下文窗口决定了AI能够看到多少内容,但并不保证AI对每一部分的利用都同样出色。
 应对上下文限制的实用技巧
几个简单的习惯可以帮你更好地使用Claude、ChatGPT或Gemini:
- 继续之前先做个总结。 如果对话已经很长,可以让AI把已经达成共识的要点总结一下,然后开启一个新对话,把这段总结粘贴进去。这样就能"释放"上下文窗口。
- 把大任务拆分成几步。 不要一次性粘贴一份巨大的文档再提出几十个问题,而是分段处理。这样既省token,也有助于AI更专注于你真正需要的部分。
- 在长对话中重复关键信息,比如名字、目标或重要数字,而不要假设AI一定还记得。
- 把问题写得清晰、聚焦,这样AI就不必在大量无关的上下文中翻找你真正需要的内容。
如果你在使用那种能自动完成多个步骤的"智能体(agent)"式AI(调用工具、浏览网页、编辑文件等),上下文窗口就更加重要,因为每一个中间步骤也会占用这个窗口的空间。
 Claude的跨对话记忆,是不是靠更大的上下文窗口实现的
Claude最近新增了一项功能,可以记住跨越多个对话的细节,不需要你每次打开新对话都重复一遍背景信息。这并不是简单地扩大了上下文窗口,而是一套独立的机制,让Claude能够保存并在之后调用之前会话中的信息,更像是放在桌子外面的笔记,而不是换了一张更大的桌子。
 常见问题
上下文窗口等于AI的长期记忆吗? 不是。上下文窗口只存在于单次对话会话中。当你打开一个新对话时(除非产品有单独的记忆功能),旧窗口中的一切都会消失,AI会从零开始。
上下文窗口越大,AI就越"聪明"吗? 不一定。更大的窗口让AI能一次处理更多内容,但推理能力和理解意图的水平,取决于模型本身的质量,而不仅仅是窗口的大小。
为什么很多免费聊天应用把上下文窗口限制得比底层模型允许的更低? 因为处理的token越多,所需的计算成本就越高,所以很多免费或低价位的产品会限制对话长度以控制运行成本。
可以把一整本书粘贴给AI吗? 理论上,在大约100万token的上下文窗口下是可以的。但实际情况还要看你使用的平台是否支持,而且AI在非常长的中间部分,注意力可能分配得不够均匀。
我怎么知道自己快要用完上下文窗口了? 大多数面向普通用户的聊天界面并不会显示剩余token数。最明显的信号就是AI开始忘记长对话前面提到的细节,这时就该做个总结,重新开始一段新对话了。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制