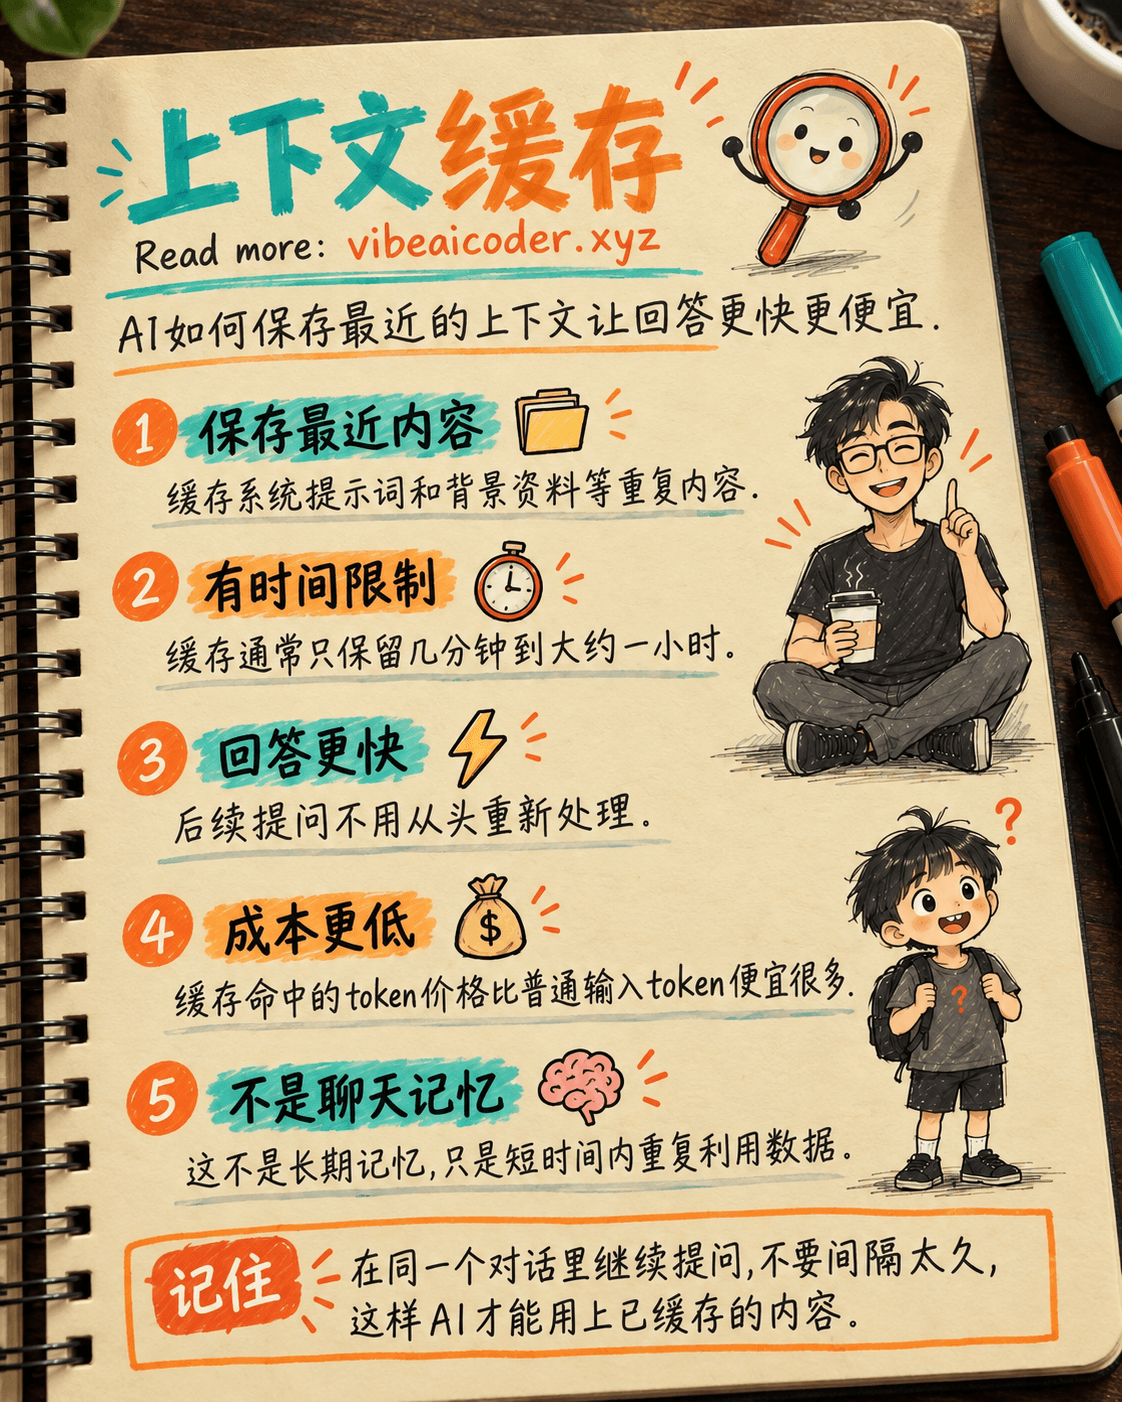
什么是上下文缓存?为什么重复利用上下文能让AI更快更便宜
 什么是上下文缓存?为什么重复利用上下文能让AI更快更便宜
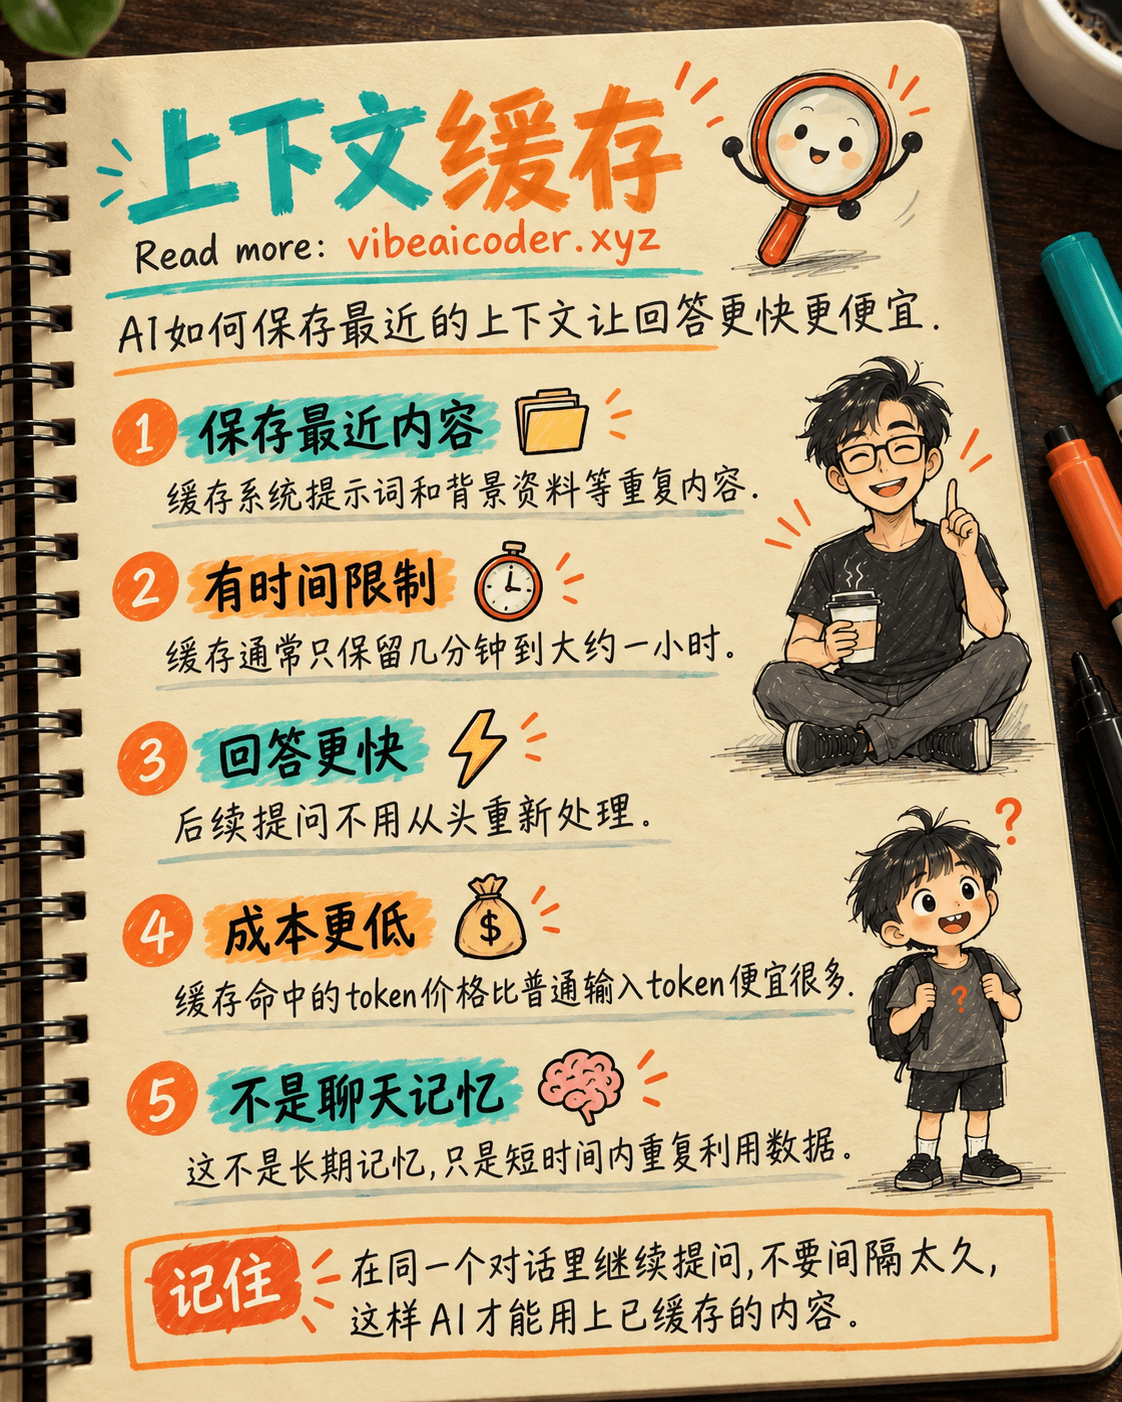
上下文缓存(也叫提示词缓存)是AI系统把你之前发送过的内容临时保存下来的方式,这样下一次请求就不用从头重新处理一遍。结果就是:回答更快,每次调用AI的成本也明显更低。这项功能在AI服务商那一侧运行,普通用户通常不需要自己设置,只会感受到效果:对话更流畅,AI应用也能定更低的价格。
 一个生活中的比喻
想象你把一份五十页的文件交给一位助理,然后接连问了好几个关于这份文件的不同问题。如果每次提问,助理都要从第一页重新读到第五十页,那会非常浪费时间,尽管文件内容根本没有变化。但如果助理把这五十页的内容先记在短期记忆里,只要你紧接着继续提问,他们只需要听你的新问题,马上就能回答,不用再重新读一遍。
上下文缓存做的正是同样的事情。重复出现的部分,比如系统提示词、背景资料,或者同一对话中更早的消息,会被保存在一个临时的缓存区里。AI只需要处理你刚刚新增的内容,而不是每次你多打一句话,就把整段对话从零重新处理一遍。
 它具体是怎么运作的
- 当你发送一段很长的对话或文档时,其中很少变化的部分(比如系统提示词、背景资料、更早的聊天记录)会被标记,保存进缓存。
- 第一次调用时,AI的缓存里还什么都没有,所以要像平时一样处理全部内容,同时把这部分内容写入缓存。
- 之后的调用,如果发生在一个较短的时间窗口内,通常是几分钟,有些服务商最长可以延长到大约一小时,AI就会直接读取缓存里的内容,而不是从头重新处理。
- 系统只会仔细处理你刚刚新增的内容(新问题、新消息),然后把它和缓存里已有的内容拼接起来生成答案。
- 如果你间隔太久没有继续提问,缓存就会过期并被清除。之后再提问时,就要从头重新处理,就像开始一段全新的对话一样。
这也是为什么很多AI应用建议你在同一个对话里继续提问,而不是每次都开一个新对话。如果你中断太久再回来提问,AI之前缓存的内容就会丢失,必须重新处理全部内容。
 这对你意味着什么
如果你只是日常使用ChatGPT、Claude或Gemini聊天的普通用户,上下文缓存正是为什么同一段对话里后续的回答往往比第一条回答更快,尤其是当你粘贴了一大段文档,然后连续问了好几个相关问题的时候。一个实用的小技巧:只要还在讨论同一个主题或文档,就继续在同一个对话里提问,而不是每个问题都开新对话,这样才能真正利用到已经缓存的内容。
如果你是在用Claude的API开发产品,为固定不变的内容(比如系统提示词、背景资料或示例提示)开启缓存,大约可以把这部分内容的成本降低九成左右,响应时间也会明显缩短。这也是为什么每家AI服务商的价格表里,缓存命中的token都会单独列出一个比普通输入token便宜得多的价格。你可以在我们这篇关于AI价格是怎么计算的文章里读到更多细节。
以下几种具体场景能明显受益于上下文缓存:
- 一个工具先读一遍很长的合同,然后让用户针对同一份合同连续提出多个问题。
- 一个编程助理在同一个工作过程中反复读取同一份较大的源代码。
- 一个AI智能体在保持同一个任务背景不变的情况下,反复调用外部工具(搜索网页、执行命令)。
在这三种情况里,背景内容(合同、源代码、任务背景)在各个步骤之间都没有变化,所以只保存一次,就能明显节省时间和成本。
 常见的误解
"缓存意味着AI会永远记住。" 这是不对的。缓存只会存在很短的一段时间,通常是几分钟到大约一小时,具体取决于服务商。这段时间一过,数据就会被清除,下一次请求就必须从头重新处理。
"上下文缓存就是聊天机器人的记忆功能。" 并不完全是。长期记忆是让AI能在不同对话之间回忆信息的机制,有时可以持续好几天,甚至一直保留到你自己删除为止。而上下文缓存只是在很短的时间窗口内重复利用数据,主要目的是节省速度和成本,而不是让AI长期"了解"你。
"普通用户需要自己去开启这个功能。" 不需要。这是开发团队在调用AI系统时设置的一个技术选项。如果你只是在用ChatGPT或Claude这类应用,你不需要做任何操作,速度和成本上的好处会自动体现在你的使用体验或应用的定价里。
 常见问题
上下文缓存和聊天机器人的记忆功能一样吗? 不一样。聊天机器人的记忆功能是在不同对话之间回忆信息,而上下文缓存只是在一个较短的时间窗口内重复利用内容,避免重复处理完全相同的内容。
缓存能保存多久? 这取决于服务商。最常见的是几分钟,有些服务商提供延长到大约一小时的选项,但存储成本会稍高一些。
缓存会降低回答的质量吗? 不会。被缓存的内容和原始内容完全一样,AI只是跳过了重新处理这一步,并没有丢掉任何信息。
我在用普通的AI应用时需要自己开启缓存吗? 不需要。这是开发团队在调用API时设置的。你只需要在同一个对话里继续提问,就很可能已经享受到了这个好处。
为什么第一条回答有时候比后面的回答慢? 因为第一次调用时,AI的缓存里还没有任何内容,所以必须处理全部内容。后续的问题可以利用已经缓存的部分,所以通常会更快,前提是你没有间隔太久才继续提问。这个概念也和AI一次能"看到"多少内容密切相关,我们在什么是上下文窗口这篇文章里有更详细的介绍。