 Context caching là gì? Vì sao dùng lại ngữ cảnh giúp AI nhanh và rẻ hơn
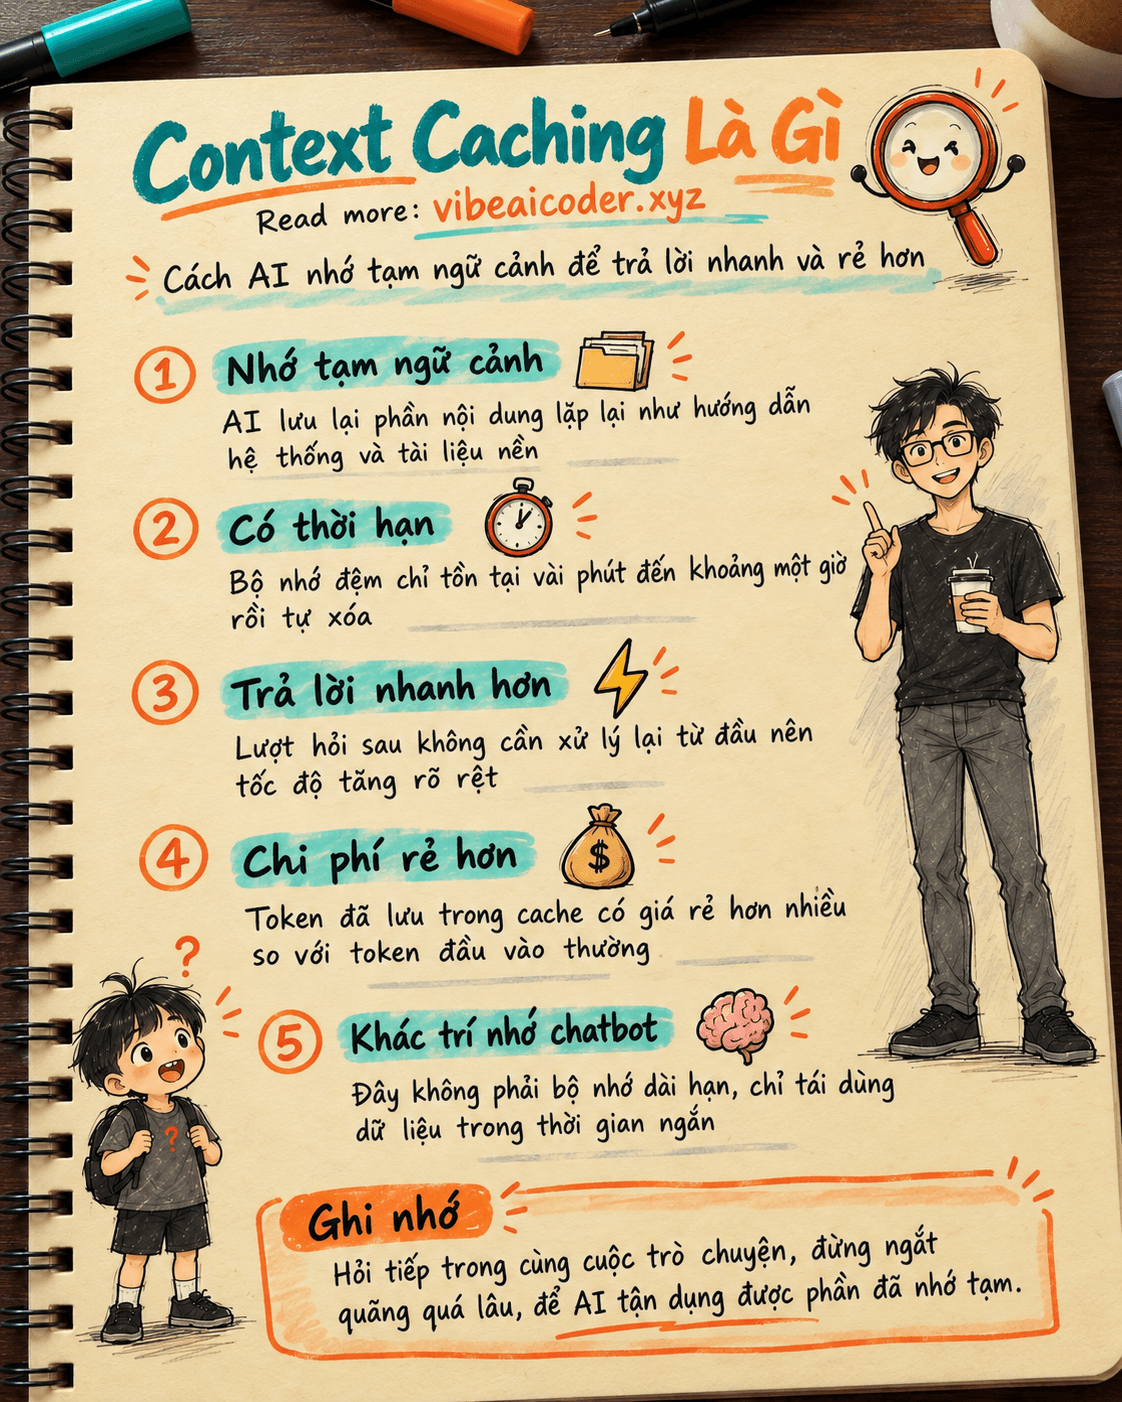
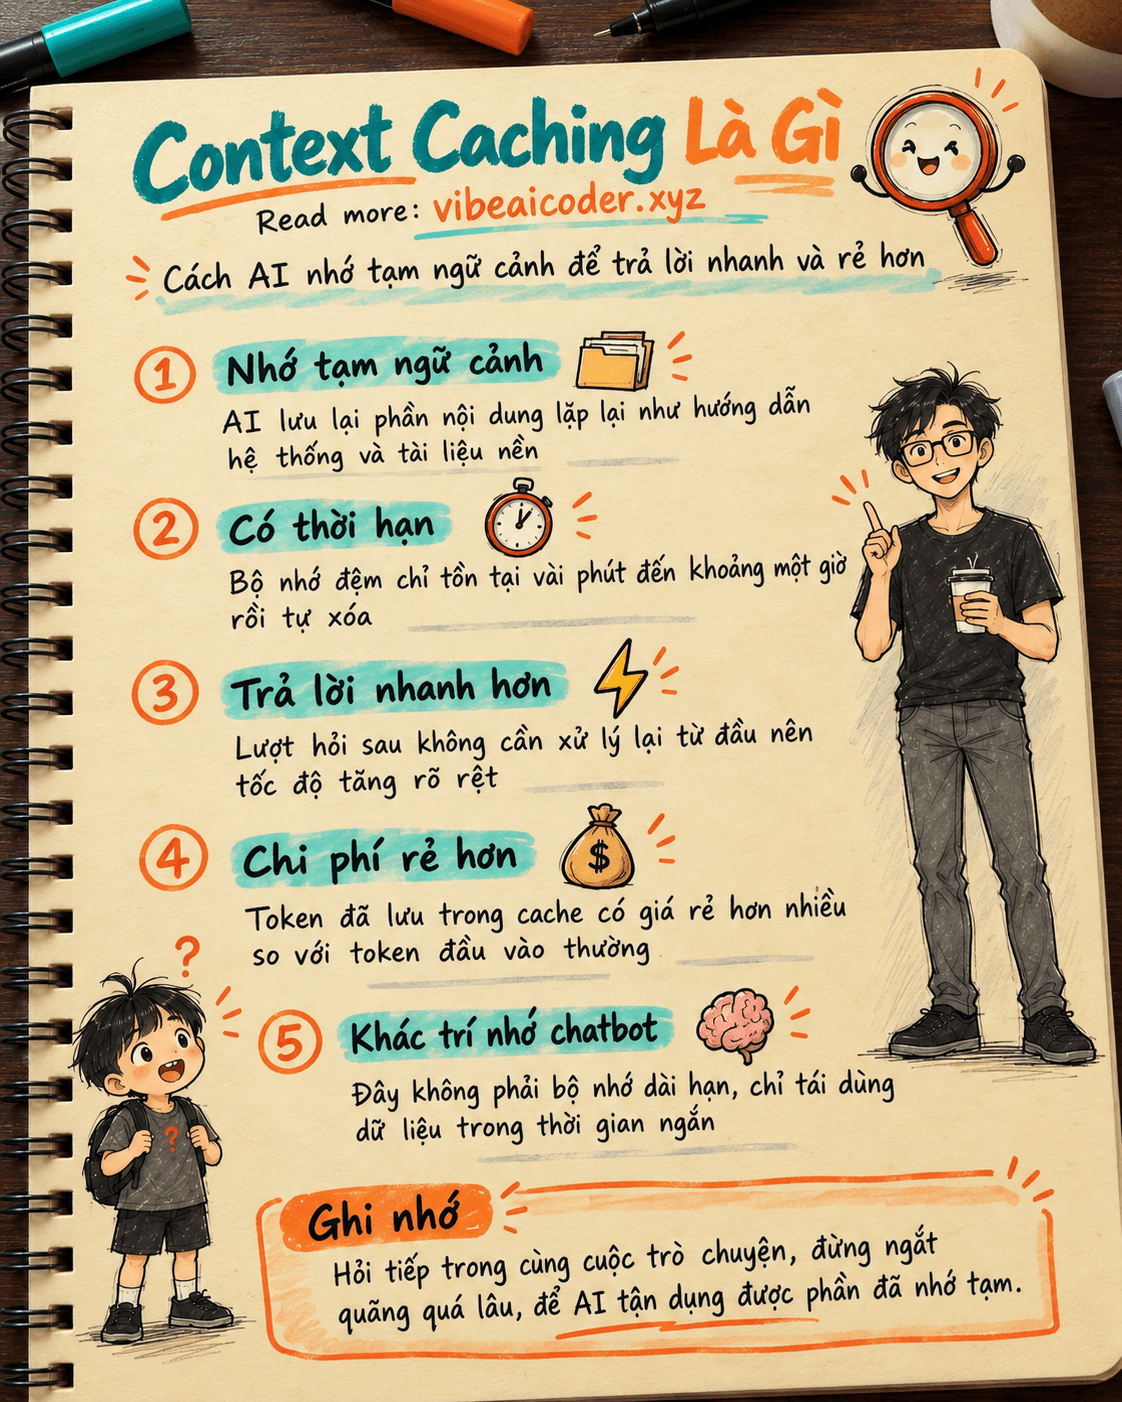
Context caching (còn gọi là prompt caching) là cách AI lưu tạm lại phần nội dung bạn đã gửi trước đó, để lần hỏi tiếp theo không phải đọc lại từ đầu. Nhờ vậy câu trả lời ra nhanh hơn, và chi phí cho mỗi lượt gọi AI cũng rẻ hơn đáng kể. Đây là tính năng chạy ở phía hệ thống AI, người dùng bình thường thường chỉ cảm nhận được kết quả: trò chuyện mượt hơn, ứng dụng AI rẻ hơn, chứ không cần tự bật hay tắt gì cả.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng bạn đưa cho một trợ lý tập hồ sơ dày năm mươi trang rồi hỏi liên tục nhiều câu khác nhau về nó. Nếu mỗi lần bạn hỏi, trợ lý lại phải mở ra đọc lại từ trang một đến trang năm mươi thì rất mất thời gian, dù nội dung hồ sơ chẳng đổi. Nhưng nếu trợ lý "nhớ tạm" nội dung năm mươi trang đó, miễn là bạn hỏi tiếp trong một khoảng thời gian ngắn, họ chỉ cần nghe câu hỏi mới và trả lời ngay, không cần đọc lại từ đầu.
Context caching chính là cách AI làm điều tương tự. Phần nội dung lặp lại, như hướng dẫn hệ thống, tài liệu nền hoặc các tin nhắn cũ trong cùng cuộc trò chuyện, được giữ lại trong một bộ nhớ đệm tạm thời. AI chỉ cần xử lý phần mới bạn vừa thêm vào, thay vì xử lý lại toàn bộ cuộc hội thoại từ con số không mỗi lần bạn gõ thêm một câu.
 Nó hoạt động thế nào
- Khi bạn gửi một đoạn hội thoại hoặc tài liệu dài, phần ít thay đổi (ví dụ hướng dẫn hệ thống, tài liệu nền, lịch sử chat cũ) được đánh dấu để lưu vào bộ nhớ đệm.
- Ở lượt gọi đầu tiên, AI chưa có gì trong bộ nhớ đệm nên phải xử lý toàn bộ nội dung như bình thường, đồng thời ghi lại phần đó vào cache.
- Ở những lượt gọi tiếp theo, nếu diễn ra trong một khoảng thời gian ngắn, thường chỉ vài phút, một số nơi cho kéo dài tới khoảng một giờ, AI đọc lại phần đã lưu thay vì xử lý lại từ đầu.
- Hệ thống chỉ "đọc kỹ" phần nội dung mới bạn vừa thêm (câu hỏi mới, tin nhắn mới), rồi ghép với phần đã có sẵn trong cache để tạo câu trả lời.
- Nếu bạn ngừng hỏi quá lâu, bộ nhớ đệm hết hạn và bị xóa. Lượt hỏi tiếp theo sau đó phải xử lý lại từ đầu, giống như một cuộc trò chuyện hoàn toàn mới.
Đây là lý do nhiều ứng dụng AI khuyên bạn nên hỏi tiếp trong cùng một cuộc trò chuyện thay vì mở cuộc trò chuyện mới liên tục. Nếu bạn ngắt quãng quá lâu rồi hỏi lại, AI mất luôn phần đã "nhớ tạm" và phải xử lý lại toàn bộ.
 Điều này có ý nghĩa gì với bạn
Nếu bạn chỉ là người dùng ChatGPT, Claude hay Gemini để trò chuyện hằng ngày, context caching giúp các câu trả lời sau trong cùng một đoạn chat thường ra nhanh hơn câu đầu tiên, nhất là khi bạn dán vào một tài liệu dài rồi hỏi nhiều câu về nó. Mẹo thực tế: giữ nguyên một cuộc trò chuyện khi bạn còn hỏi về cùng một chủ đề hoặc tài liệu, thay vì mở đoạn chat mới mỗi câu hỏi, để tận dụng được phần đã lưu.
Nếu bạn là người xây dựng sản phẩm bằng API của Claude, bật caching cho những phần cố định như hướng dẫn hệ thống, tài liệu nền hay các ví dụ mẫu có thể giảm chi phí tới khoảng chín mươi phần trăm cho phần nội dung đó, và giảm thời gian chờ phản hồi rất đáng kể. Đây cũng là lý do bảng giá của các nhà cung cấp AI luôn có một mức riêng cho "token đã cache", rẻ hơn nhiều so với token đầu vào thông thường. Bạn có thể đọc thêm cách các mức giá này được tính trong bài giá AI tính thế nào.
Một vài tình huống cụ thể hưởng lợi rõ rệt từ context caching:
- Một công cụ đọc hợp đồng dài rồi cho người dùng hỏi đáp nhiều câu về cùng hợp đồng đó.
- Một trợ lý viết code đọc cùng một đoạn mã nguồn lớn nhiều lần trong một phiên làm việc.
- Một AI agent lặp đi lặp lại việc gọi công cụ bên ngoài (tra web, chạy lệnh) trong khi vẫn giữ nguyên bối cảnh công việc ban đầu.
Trong cả ba trường hợp, phần nội dung nền (hợp đồng, mã nguồn, bối cảnh công việc) không đổi giữa các bước, nên việc lưu lại giúp tiết kiệm cả thời gian lẫn chi phí một cách rõ ràng.
 Hiểu lầm thường gặp
"Cache nghĩa là AI nhớ mãi mãi." Không đúng. Bộ nhớ đệm chỉ tồn tại tạm thời, thường vài phút đến khoảng một giờ tùy nhà cung cấp. Hết thời gian đó, dữ liệu bị xóa và lượt hỏi tiếp theo phải xử lý lại từ đầu.
"Context caching chính là trí nhớ (memory) của chatbot." Không phải. Trí nhớ dài hạn là cơ chế AI ghi nhớ thông tin giữa nhiều phiên trò chuyện khác nhau, có thể kéo dài nhiều ngày hoặc vĩnh viễn cho tới khi bạn xóa. Context caching chỉ tái sử dụng dữ liệu trong một khoảng thời gian rất ngắn, mục đích chính là tiết kiệm tốc độ và chi phí, không phải để AI "biết" về bạn lâu dài.
"Người dùng bình thường phải tự bật tính năng này." Không cần. Đây là một tùy chọn kỹ thuật mà đội ngũ xây dựng ứng dụng AI cấu hình khi gọi tới hệ thống AI. Nếu bạn chỉ dùng app như ChatGPT hay Claude, bạn không cần làm gì, lợi ích về tốc độ và chi phí sẽ tự động phản ánh vào trải nghiệm hoặc giá của ứng dụng.
 Câu hỏi thường gặp
Context caching có giống trí nhớ của chatbot không? Không. Trí nhớ chatbot ghi nhớ thông tin giữa các phiên trò chuyện khác nhau, còn context caching chỉ tái sử dụng nội dung trong một khoảng thời gian ngắn để tránh xử lý lại y hệt nhau.
Bộ nhớ đệm tồn tại bao lâu? Tùy nhà cung cấp, phổ biến nhất là vài phút, một số nơi có tùy chọn kéo dài khoảng một giờ với chi phí lưu cao hơn một chút.
Caching có làm giảm chất lượng câu trả lời không? Không. Nội dung được lưu lại vẫn y hệt nội dung gốc, AI chỉ tránh phải xử lý lại từ đầu chứ không bỏ bớt thông tin nào.
Tôi có cần bật caching khi dùng app AI bình thường không? Không cần. Đây là việc đội ngũ phát triển cấu hình khi gọi tới hệ thống AI qua API. Bạn chỉ cần tiếp tục hỏi trong cùng một cuộc trò chuyện là có thể đã hưởng lợi.
Vì sao câu trả lời đầu tiên đôi khi chậm hơn các câu sau? Vì lượt đầu AI chưa có gì trong bộ nhớ đệm nên phải xử lý toàn bộ nội dung. Những câu hỏi tiếp theo tận dụng được phần đã lưu nên thường nhanh hơn, miễn là bạn hỏi tiếp không ngắt quãng quá lâu. Khái niệm này cũng gắn liền với cách AI quản lý lượng nội dung nó có thể "nhìn thấy" cùng lúc, bạn có thể đọc thêm trong bài context window là gì.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 GPU Là Gì? Vì Sao AI Cần Chip Đồ Họa Mạnh Để Huấn Luyện Và Chạy