
AI训练与推理有什么区别?
 AI的训练和推理有什么不同?
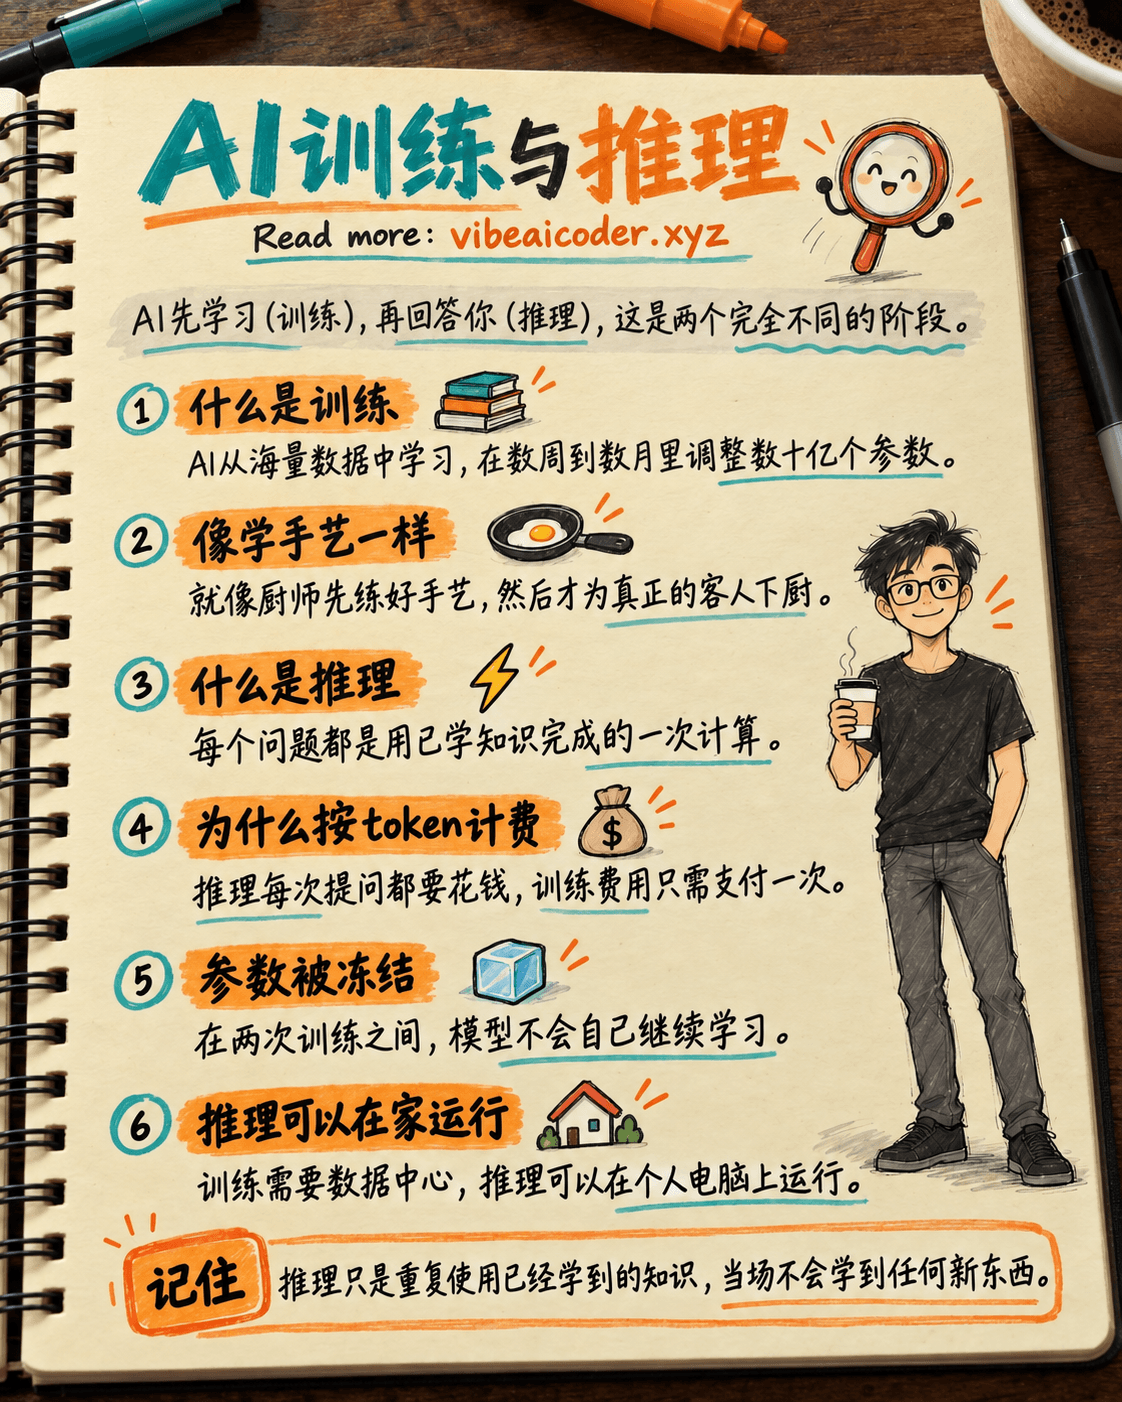
训练是AI从海量数据中学习如何回答问题的阶段,就像一个学徒在出师之前反复练习成千上万次手艺。推理则是这个已经训练好的AI,利用学到的知识当场回答你的新问题,不再学习任何新东西。理解这个区别能让你更容易看懂AI新闻,明白为什么有些AI应用回答得快,有些却比较慢,也能明白你的AI账单是怎么算出来的。
 用生活中的例子快速理解
想象一位正在学厨艺的厨师。多年里,他反复做同样的菜,不断试味,被师傅纠正,每次出错后都调整手法。这就是训练:耗费大量时间和精力,但只需要做一次。
出师之后,这位厨师开始为真正的客人掌勺。客人点菜,厨师立刻用已经练好的手艺下厨,不需要为每一位新客人重新学习。如果那天的菜做得不够好,厨师也不会当场"重新学习",只能用已经练就的手艺来应对。这就是推理:比训练快得多,但只能发挥之前学到的本领。
AI也是一样。训练是模型"上学"的阶段。推理则是你每次打开Claude或ChatGPT提问的那一刻,就像AI把学到的知识拿出来,专门为你的问题服务。如果你还不太了解AI的基本原理,可以先看看AI是什么这篇文章。
 它具体是怎么运作的
- 收集海量数据:书籍、网页、源代码、示范对话,全部汇集成训练数据集。
- 训练:模型做出一个预测(比如猜下一个词),把结果和正确答案对比,然后微调内部数十亿个叫做参数的数字。关于参数的更多内容可以看AI的参数是什么。这个步骤会重复数十亿次,在成千上万块专用GPU或TPU芯片上并行运行数周到数月。
- 冻结参数:训练结束后,模型学到的所有数字都会被"冻结"成一个固定的模型版本,在下一次训练之前,模型都不会再改变。
- 推理:当你输入问题时,模型会用那组已经冻结的参数计算出答案。这只是一次"前向"计算(没有纠错步骤,也不更新参数),所以比训练轻松得多。
- 每次提问都重复一次:你发送的每条消息都是一次全新、独立的推理,用的是同一个已经训练好的大脑,而不是每次都"重新复习"一遍。
正因为推理比训练轻量得多,它才能在手机或个人电脑上运行,而训练则需要整个数据中心。如果你好奇想在自己的电脑上运行AI模型,本地运行AI这篇文章讲了你的电脑需要多强,而且那依然只是运行推理,不是从零训练模型。
 这对你意味着什么
- 当你和Claude或ChatGPT聊天时,你用的只是推理阶段。 模型不会因为这次对话立刻变得更聪明,在同一个对话里学到更多。
- "训练下一代模型花费数亿美元"这样的新闻,和"每百万token只要几美元"并不矛盾。 训练成本是一笔巨大的一次性投入,覆盖模型的整个生命周期。推理成本很小,按你发送的每个问题计费,这也是为什么API套餐按输入和输出token收费。AI的价格是怎么算的这篇文章讲得更详细。
- 如果你想让AI永远"记住"你自己的信息,你需要一种叫做微调(fine-tuning)的再训练方式。 如果只是希望AI在一次对话或一次查询中知道这些信息,直接粘贴进提示词就够了,完全不需要任何训练步骤。
- 比较不同AI应用时,回答速度的差异主要来自推理运行在不同的硬件上,而不是某个应用"还在学习"而另一个"已经学完"。
 常见误解
- "每次我聊天,AI都在立刻学习。" 实际上,一次聊天通常只是推理,模型的参数当下并不会改变。如果某家服务商之后把对话数据用于下一次训练,那也是之后、按批次进行的,而且通常会有隐私设置让你自己打开或关闭。
- "推理永远又便宜又快。" 推理依然需要真实的算力,这也是为什么它按token计费。遇到长问题、附带多个文件,或者使用"深度推理"模式时,一次推理可能比简单回答慢得多、贵得多。
- "模型推理步骤越多,就说明它在被重新训练。" "推理"这个词在这里容易让人误会。推理(inference)是模型计算出答案的过程,不管是一步完成还是多步完成。"推理模型"(reasoning model)只是一种被专门训练成会在给出答案前写出更多思考步骤的模型,但这个过程依然属于推理,不是重新训练。
 常见问题
训练一个大型AI模型要多久? 视规模而定,目前领先的模型通常需要几周到几个月在成千上万块专用GPU或TPU芯片上持续训练,花费从数千万到数亿美元不等。
推理会让模型随着时间变得更聪明吗? 不会。推理只是用已经学到的知识来回答,不会改变模型内部的参数。模型只有在开发者训练并发布新版本时才会"变强"。
为什么AI有时候回答得比平时慢? 因为那一次推理需要更多计算,比如问题很长、附带了很多文件,或者你用的是深度推理模式。这些依然都是推理,只是比平常更"重"的一次推理。
我能在家自己训练一个像Claude这样的AI吗? 从零开始训练那种规模的模型,在个人电脑上并不现实。但你完全可以在自己的电脑上用更小的开源模型来运行推理,或者针对自己的需求对小模型做轻量级微调。
微调和从零训练是一回事吗? 不是。微调只是在一个已经训练好的模型基础上,用少得多的数据继续调整,让它在某个具体任务上表现更好,而不是从零开始重新学习一切。


 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制