AIの学習と推論は何が違うのか
 AIの学習(トレーニング)と推論(インファレンス)は何が違うのか
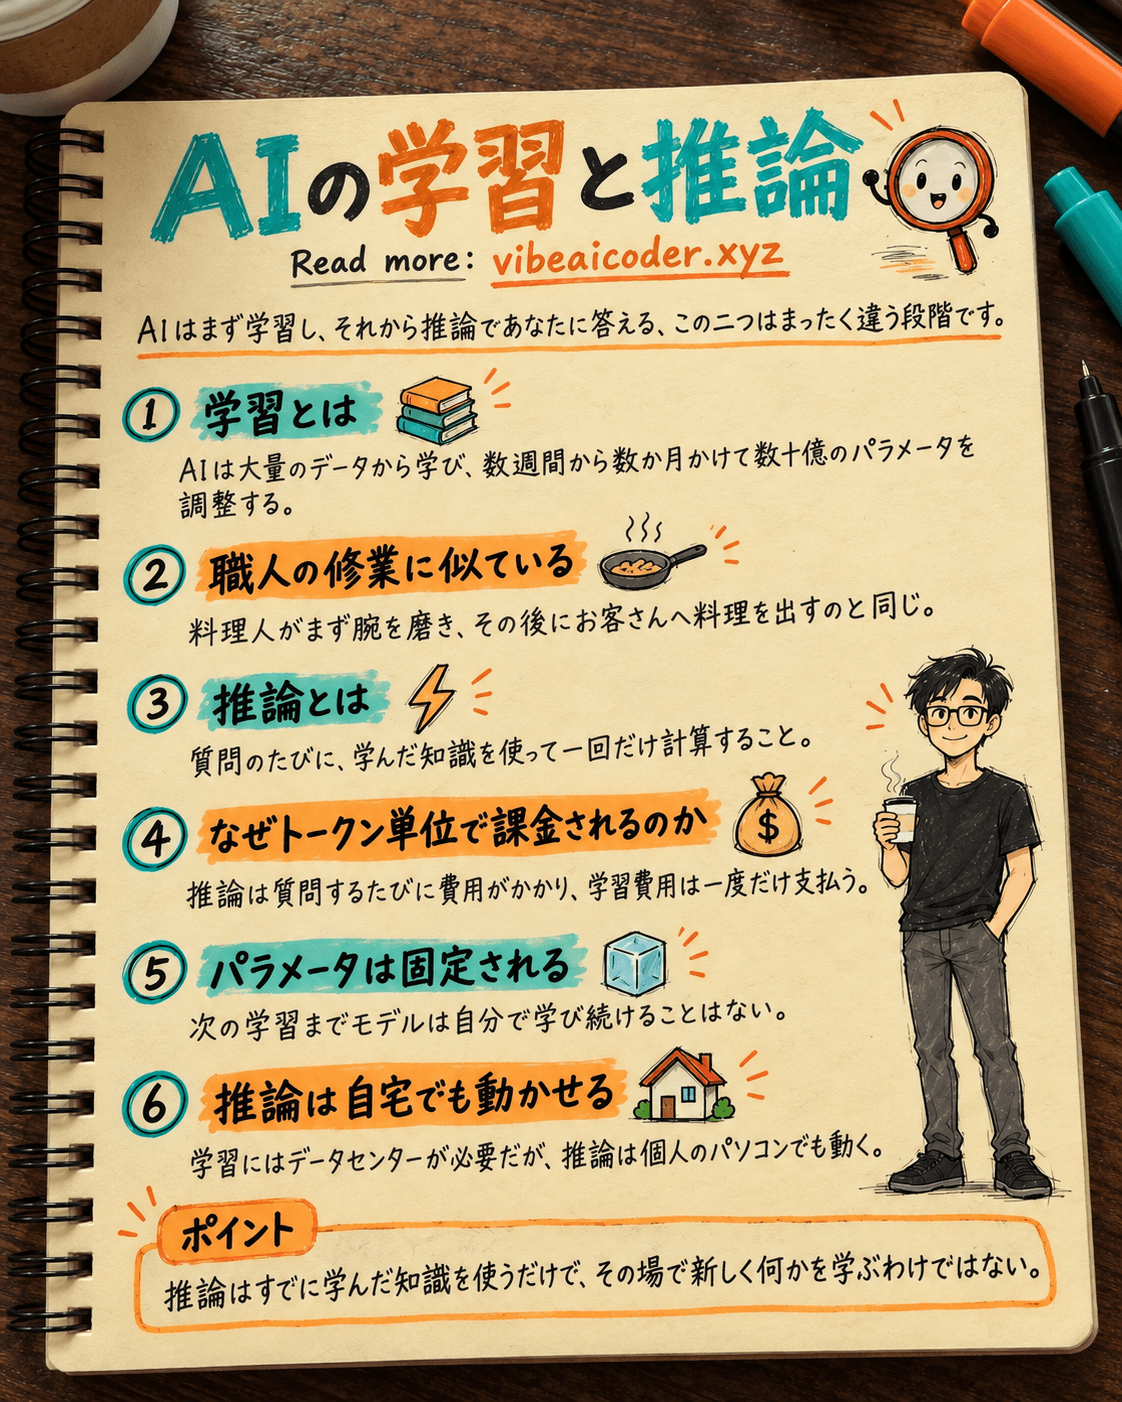
学習(トレーニング)は、AIが大量のデータから答え方を覚える段階で、職人が一人前になる前に何千回も同じ作業を練習するのに似ています。推論(インファレンス)は、すでに学習を終えたAIが、覚えた知識を使ってその場であなたの新しい質問に答えることで、その瞬間に新しく何かを学ぶわけではありません。この違いを理解すると、AIのニュースが読みやすくなり、AIアプリによって応答の速さが違う理由や、AIの料金がどう計算されているのかも分かるようになります。
 身近な例でさっと理解する
修業中の料理人を想像してみてください。何年もの間、同じ料理を何度も作り、味見をし、師匠に直され、失敗するたびに腕を調整していきます。これが学習です。膨大な時間と労力がかかりますが、一度やれば済みます。
一人前になった後、料理人は実際のお客さんに料理を出す立場になります。お客さんが注文すると、料理人はすでに身につけた腕前をその場ですぐに使って調理し、新しいお客さん一人ひとりのためにゼロから学び直すことはありません。もしその日の料理の出来が今ひとつでも、料理人はその場で「学び直す」ことはできず、すでに身につけた腕前だけを使うしかありません。これが推論です。学習よりずっと速いですが、事前に教わった範囲でしか力を発揮できません。
AIも同じです。学習はモデルが「学校に通う」段階です。推論は、あなたがClaudeやChatGPTを開いて質問するたびに起きていることで、AIが学んだ知識を取り出して、あなたの質問にぴったり応える作業だと言えます。AI全般の仕組みがまだよく分からない場合は、先にAIとは何かの記事を読んでみてください。
 実際どう動いているのか
- 膨大なデータを集める: 書籍、ウェブページ、ソースコード、会話のサンプルなどをまとめて学習用データセットにします。
- 学習: モデルは予測を行い(例えば次の単語を予測する)、正解と比較してから、パラメータと呼ばれる内部の数十億個の数値を少しずつ調整します。パラメータについてはAIのパラメータとは何かの記事で詳しく説明しています。この工程を数十億回繰り返し、数千個の専用GPUやTPUチップを並列で使いながら、数週間から数か月かけて行います。
- パラメータを固定する: 学習が終わると、学んだすべての数値は一つの固定されたモデルとして「凍結」されます。次の学習が行われるまで、モデルはそれ以上変化しません。
- 推論: あなたが質問を入力すると、モデルはその凍結されたパラメータを使って答えを計算します。これは一回だけの順方向計算で(修正のステップもパラメータ更新もなく)、学習に比べてはるかに軽い処理です。
- 質問のたびに繰り返す: あなたが送るメッセージ一つ一つが、新しく独立した推論であり、毎回「復習」するのではなく、同じ学習済みの頭脳を使っています。
推論は学習よりもずっと軽いため、スマートフォンや個人のパソコンでも動かすことができますが、学習にはデータセンターまるごとが必要です。自分のパソコンでAIモデルを動かしてみたい場合は、ローカルAIの動かし方の記事でどれくらいのパソコンの性能が必要か説明していますが、それもあくまで推論を動かしているだけで、モデルをゼロから学習しているわけではありません。
 これはあなたにとって何を意味するのか
- ClaudeやChatGPTとチャットしているとき、あなたが使っているのは推論の段階だけです。 モデルはその会話からすぐに学んで、同じセッション内で賢くなるわけではありません。
- 「次のモデルの学習に数億ドルかかった」というニュースと、「百万トークンあたり数ドル」という料金は矛盾しません。 学習コストは、モデルの寿命全体をカバーする一度きりの巨大な投資です。推論コストは小さく、送った質問ごとに課金されるため、APIの料金は入力と出力のトークン数で計算されます。詳しくはAIの料金はどう計算されるのかの記事を見てください。
- AIに自分の情報を永遠に「覚えて」ほしい場合は、ファインチューニングと呼ばれる再学習が必要です。 その情報を一回の会話や一回の質問だけで知っていればよいなら、プロンプトに貼り付けるだけでよく、学習の工程はまったく必要ありません。
- AIアプリ同士を比べたとき、応答速度の違いは主に推論が動くハードウェアの違いによるもので、片方が「まだ学習中」でもう片方が「学習済み」というわけではありません。
 よくある誤解
- 「チャットするたびに、AIはすぐに学習している。」 実際には、1回のチャットセッションは通常ただの推論であり、その時点でモデルのパラメータが変わることはありません。もし提供元が後で会話データを次の学習に使うとしても、それは後からまとめて行われるものであり、たいていはオンオフを選べるプライバシー設定が用意されています。
- 「推論は常に安くて速い。」 推論にも実際の計算コストがかかっており、だからこそトークン単位で課金されます。長い質問や、複数のファイル添付、あるいは「深い推論」モードを使う場合、一回の推論がシンプルな回答よりもずっと遅く、コストが高くなることがあります。
- 「何段階も推論するモデルは、再学習されている。」 ここで「推論」という言葉が誤解を招きます。推論(インファレンス)とは、モデルが答えを計算する処理のことで、1ステップでも何ステップでも関係ありません。「推論モデル」(リーズニングモデル)は、答えを出す前により多くの思考ステップを書き出すように特別に学習されたモデルというだけで、その処理自体はやはり推論に属し、再学習ではありません。
 よくある質問
大規模なAIモデルの学習にはどれくらい時間がかかりますか。 規模によりますが、現在の最先端モデルは通常、数千個の専用GPUやTPUチップを使って数週間から数か月継続的に学習し、費用は数千万ドルから数億ドルに及びます。
推論によってモデルは時間とともに賢くなりますか。 いいえ。推論はすでに学習した知識を使って答えるだけで、モデル内部のパラメータを変えることはありません。モデルが「より良く」なるのは、開発者が新しいバージョンを学習させてリリースしたときだけです。
AIがいつもより遅く答えることがあるのはなぜですか。 その推論に、より多くの計算が必要だからです。例えば質問が長い、添付ファイルが多い、深い推論モードを使っている、といった場合です。それでもすべて推論であり、普段より重い一回の推論にすぎません。
Claudeのような AI を自宅で自分で学習させることはできますか。 その規模のモデルをゼロから学習させることは、個人のパソコンでは現実的ではありません。ですが、より小さなオープンソースモデルを使って自分のパソコンで推論を動かしたり、小さなモデルを自分のニーズに合わせて軽くファインチューニングしたりすることは十分可能です。
ファインチューニングはゼロからの学習と同じですか。 いいえ。ファインチューニングは、すでに学習済みのモデルに対して、はるかに少ないデータで追加調整を行い、特定のタスクを得意にさせるものであり、ゼロからすべてを学び直すわけではありません。
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止