本地AI是什么?你的电脑需要多强
本地AI是什么?你的电脑需要多强
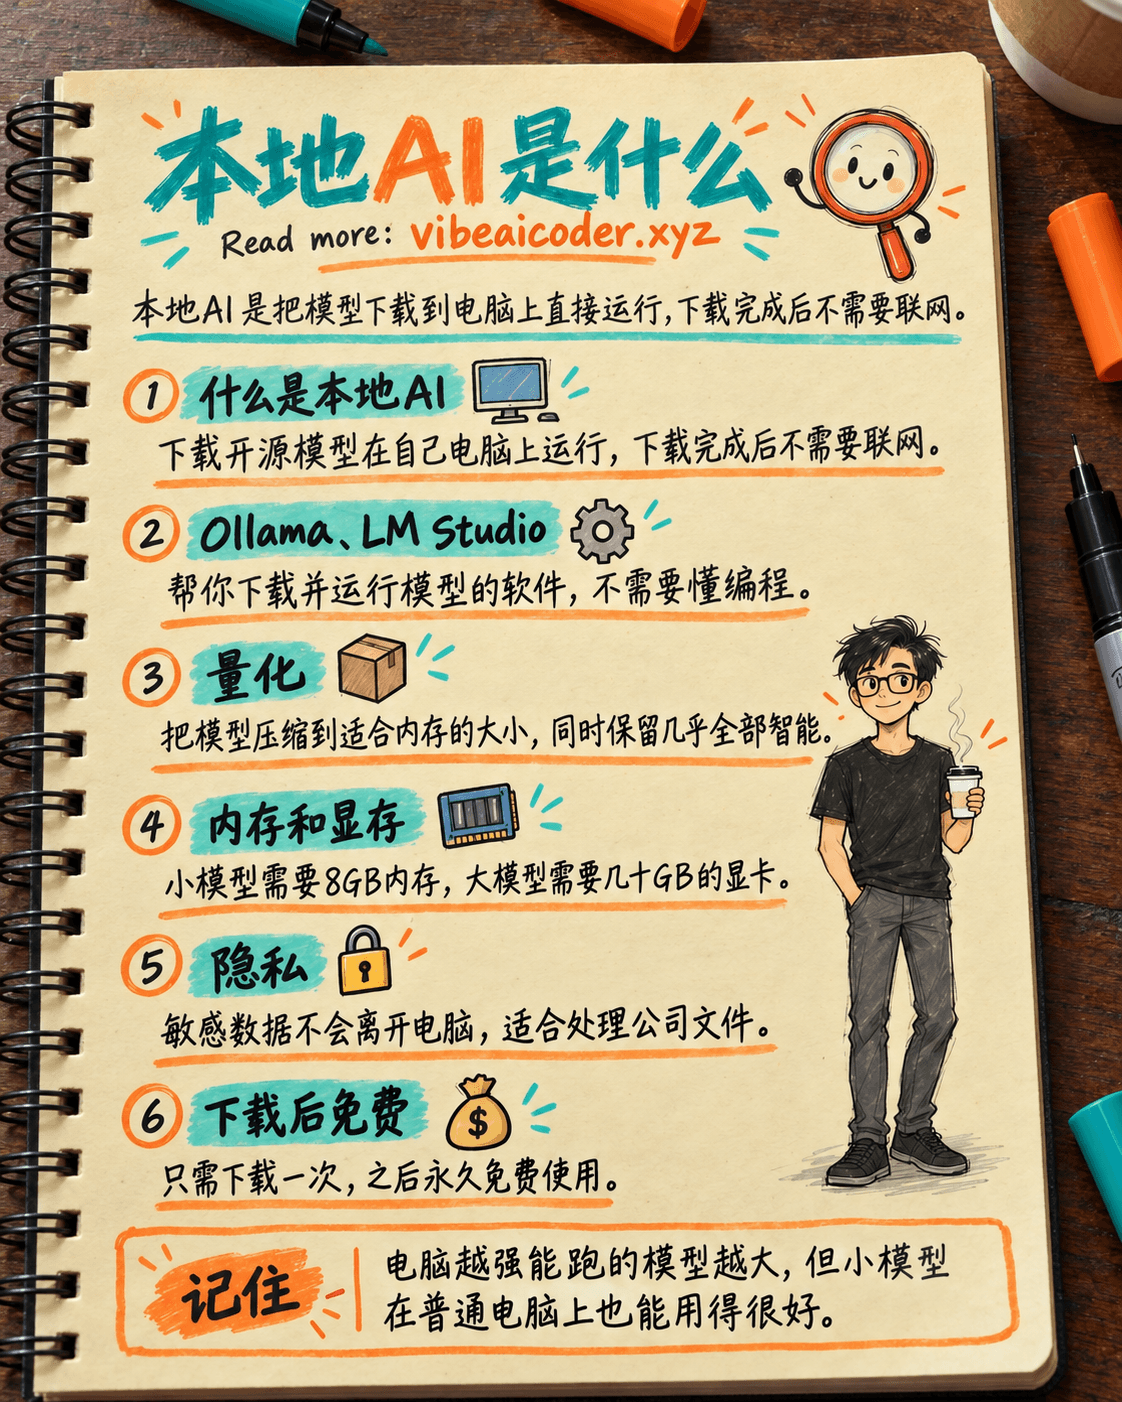
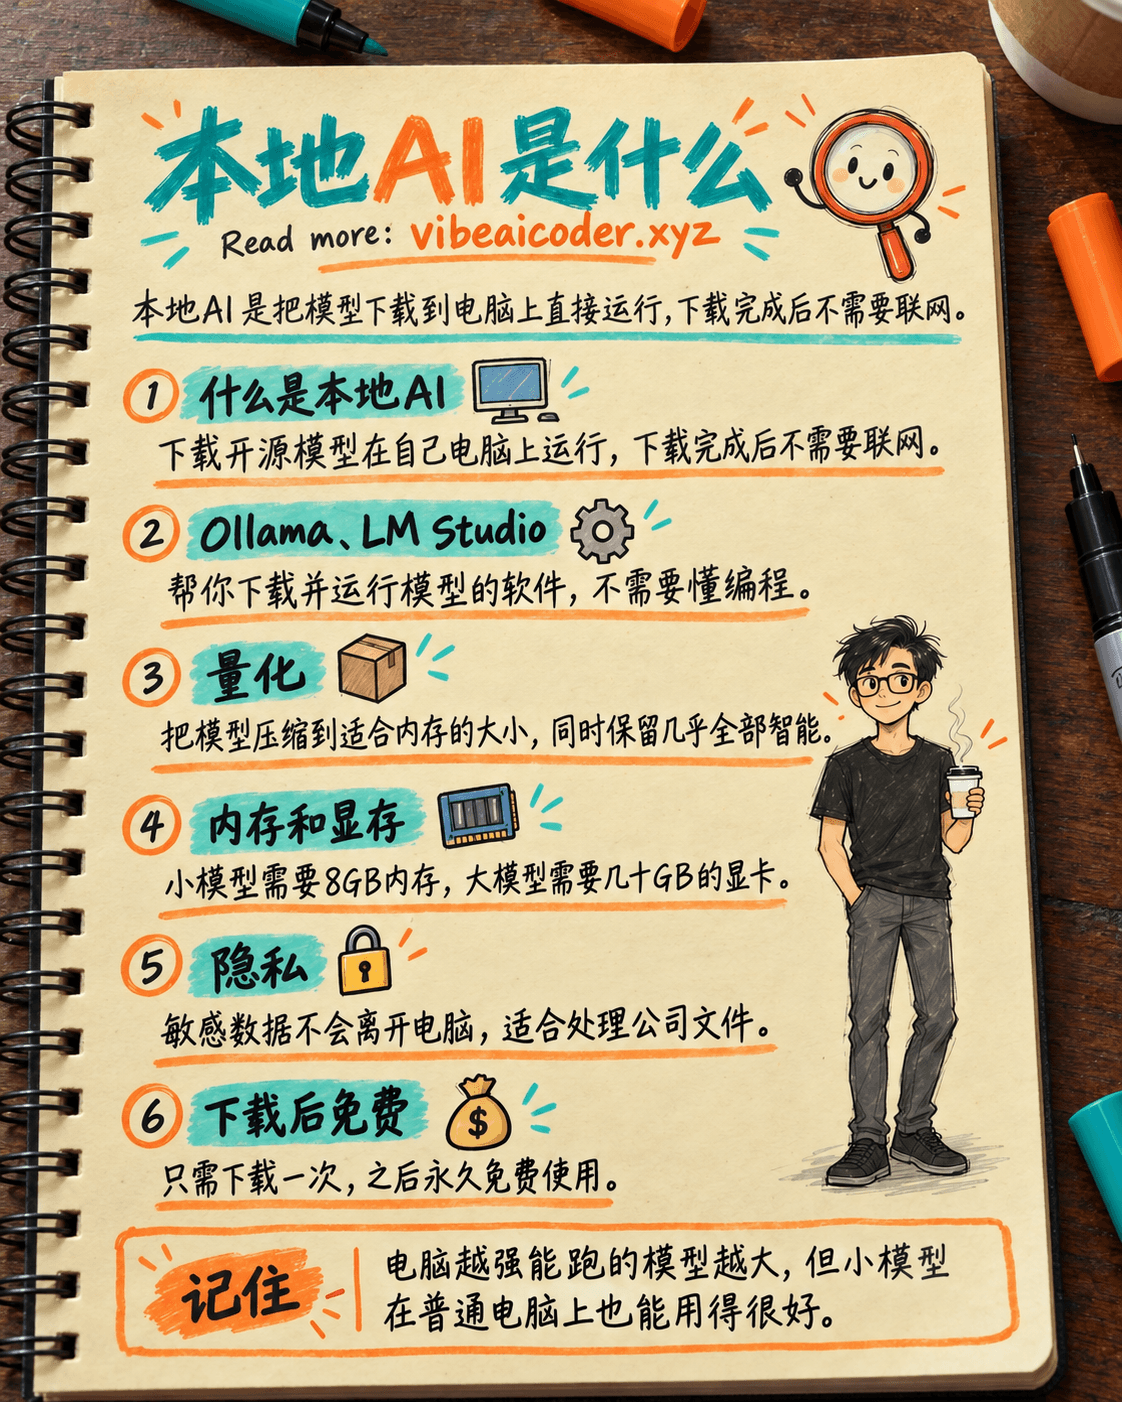
本地AI(local AI)是指把一个AI模型下载到自己的电脑上并直接运行,而不是把问题通过互联网发送到OpenAI或Anthropic的服务器。所有的"思考"都在你自己的硬盘和处理器上完成,模型下载完成后不再需要联网,也没有任何人能在远处看到你的问题。听起来有点技术性,但只要电脑性能足够,点几下鼠标,任何人都能在家里运行一个小型AI。
用生活中的例子快速理解
使用Claude或ChatGPT就像叫外卖:你下单(输入问题),远处的一家餐厅(AI公司的服务器)做好菜后送过来,味道总是不错,因为厨房设备好、厨师水平高,但你每个月或每次点单都要付钱,还得信任这家餐厅,把自己的信息交给他们。
本地AI则像在家做饭:你一次性买好食材(下载模型),然后用自己的厨房(电脑)想做多少次就做多少次,不用额外付钱,也没人看到你在做什么菜。但作为交换,饭菜好不好吃取决于你家厨房的水平(电脑硬件)和你选的菜谱(AI模型),家庭厨房通常比不上五星级餐厅。
它是怎么运作的
- 选择一个开源模型。 这些是公司公开发布、任何人都能下载使用的AI,比如Meta的Llama、阿里巴巴的Qwen或DeepSeek,这和只能通过专属App或API使用的Claude、GPT不同。
- 安装一个"启动器"软件,比如Ollama或LM Studio。它的作用就像一个音乐播放器,你只需要下载模型然后点击运行,不需要懂编程。
- 电脑会把模型压缩到适合内存的大小,这个过程叫做量化(quantization)。这样做能保留模型几乎全部的智能,同时让它的体积缩小好几倍,类似压缩一张照片或一首歌,文件变小了但看起来、听起来还是差不多。
- 模型被加载到电脑的内存中(RAM,如果有显卡的话还会用到显存VRAM),然后处理器进行计算,一个字一个字地生成答案,全部在你自己的电脑上完成。
- 模型下载完成后,整个过程就不再需要互联网了。 你的问题和答案都不会离开你的电脑。
这对你意味着什么
敏感数据的绝对隐私。 如果你的工作涉及公司文件、合同或者不想发到网上的客户信息,你可以用本地AI来提问,而不是直接把内容粘贴到浏览器里的ChatGPT或Claude。
安装完成后不再需要每月付费。 下载好模型之后,用多少次都不会再额外收费,只需要付电费,这对每天需要频繁问AI重复性问题的人来说非常划算。
但相应的,在个人电脑上运行的本地AI通常明显弱于Claude或最新的闭源模型,所以像写长代码、做深度分析或需要高准确度的复杂工作,还是更适合用云端AI服务。几个具体例子:
- 一位自由译者要翻译客户的机密文件,可以在16GB内存的笔记本电脑上通过Ollama运行一个大约70亿参数的模型,完全不用担心数据外泄。
- 一位学生想无限次提问而不受使用次数限制,可以在配备普通8GB显卡的电脑上用LM Studio安装一个小模型。
- 一位刚开始做内容创作的人想自由尝试AI、不受限制,也可以在没有独立显卡的办公电脑上单靠CPU运行一个非常小的模型,只是速度会慢一些。
常见误解
"在家运行AI意味着我的电脑必须像超级计算机一样强。" 对小模型来说并非如此。参数量在10亿到40亿之间的模型,只需要一台配备约8GB内存的普通办公电脑就能运行,速度也足够用来做摘要或简单对话。
"本地AI和Claude、ChatGPT完全一样,只是换了个地方运行而已。" 并非如此。个人电脑能运行的小型开源模型,通常明显弱于顶尖的闭源模型,尤其是在复杂推理、写长代码或在长对话中记住上下文方面。
"只要有能玩游戏的显卡,就能流畅运行大模型。" 不完全对。一张普通的8GB游戏显卡,只够运行大约70亿到140亿参数的模型。700亿参数的模型需要显存48GB以上的专业显卡,或者配备超大统一内存的Mac电脑,价格可能高达数万元人民币。
常见问题
没有独立显卡的电脑能运行本地AI吗? 可以。对于10亿到40亿参数的小模型,电脑完全可以只靠处理器和内存运行,只是比有显卡的机器慢一些。
Ollama和LM Studio有什么区别? 两者都是帮助你在电脑上下载并运行开源模型、且不需要懂编程的软件。Ollama更受喜欢敲命令的人欢迎,而LM Studio的图形界面更直观,对新手更友好。
在家运行AI真的完全免费吗? 软件和大多数开源模型都可以免费下载,你只需要支付电费以及可能需要的硬件升级费用,不需要像使用Claude或ChatGPT那样按月或按用量付费。
应该放弃Claude或ChatGPT,完全转用本地AI吗? 不需要二选一。很多人会把Claude用于需要高准确度的重要工作,同时把本地AI用于简单重复的任务,或者涉及不想上传到网络的私密数据的场景。
模型名称里的7B、13B、70B是什么意思? 这些数字代表参数量(以十亿为单位),也就是模型用来"思考"并生成答案的内部数值。参数越多的模型通常越聪明,但也需要更强的电脑,运行速度也会更慢。
如果你还想从基础了解AI到底是什么,或者想知道如何针对特定任务微调一个现有模型,这两篇文章都值得在你动手搭建本地AI之前先读一读。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制