 AI 简史:人类 6 次改变教机器的方法,从手写规则到会推理的 AI
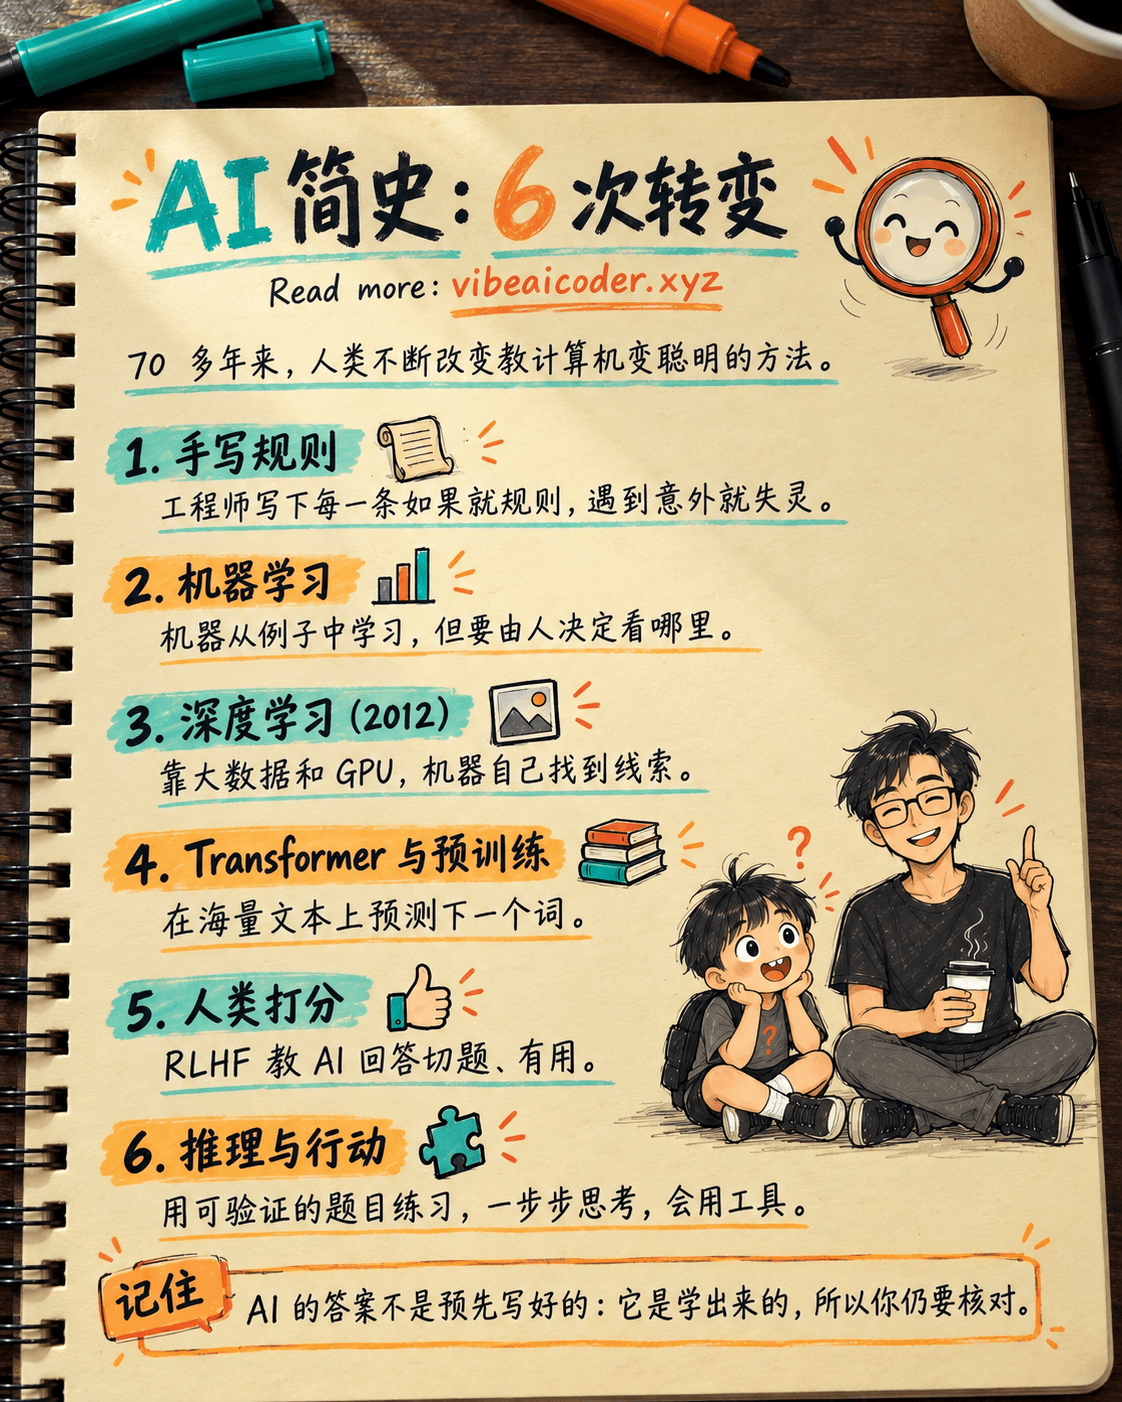
AI 的历史,是人类用 70 多年不断改变"如何教会计算机"的故事。最初,工程师亲手写下每一条规则。如今,机器先从数万亿个词中自己学习,再由人来打分,并通过练习学会一步一步思考。看懂这段历程,你就会明白 ChatGPT 和 Claude 为什么这么强,又为什么仍然会出错。
如果你刚接触 AI,可以先读一读 AI 是什么,新手也能看懂的解释。
用生活中的例子快速理解
想象你在六个不同时期教一个学徒煮汤面:
- 给他一本详细的规则手册:"水开了就调小火,咸了就加水。"一遇到手册里没写的情况,学徒就不知所措。
- 让他尝很多碗,但由你指出要注意什么:汤清不清、肉嫩不嫩。他自己总结哪碗好吃。
- 让他尝非常多碗,什么都不提示:他自己发现一碗好面的关键在哪里。
- 先让他读遍世界上所有的菜谱,然后才进厨房。
- 请主厨给每一碗打分:这碗客人喜欢,那碗还要改进。
- 给他有标准答案的练习题,叮嘱"动手前先一步步想清楚",再给他秤和温度计等工具。
这六种教法,几乎正好对应了构建 AI 模型的六个阶段。
 构建 AI 的方式是如何演变的
1. 手写规则(20 世纪 50 年代至 80 年代)
1950 年,艾伦·图灵提出了"机器能思考吗?"这个问题。1955 年,四位科学家(约翰·麦卡锡、马文·明斯基、纳撒尼尔·罗切斯特、克劳德·香农)为 1956 年在美国达特茅斯学院举办的夏季研讨会写了一份提案。人们普遍认为,**"artificial intelligence"(人工智能)**这个词就出自这份提案。
当时的做法是:工程师访谈专家,把知识写成成百上千条**"如果……就……"的规则,这叫做专家系统**。例如斯坦福大学在 70 年代开发的 MYCIN,用大约 600 条规则识别引起血液感染的细菌并推荐抗生素。
弱点在于:世界充满例外。规则越多越难修改,一遇到不寻常的情况就失灵。期望落空后,研究经费被削减,研究者把这段时期称为 "AI 寒冬"。
与此同时,另一个当时不太被看好的方向在成长:神经网络。1958 年,弗兰克·罗森布拉特造出了感知机(Perceptron),它从例子而不是规则中学习分类。1986 年,大卫·鲁梅尔哈特、杰弗里·辛顿和罗纳德·威廉姆斯推广了一种训练多层网络自我纠错的方法(反向传播:猜错了就往回追查是哪一部分导致错误,再加以调整)。想法很好,但当时的计算机太弱,数据也太少。
2. 从数据中学习,由人决定看哪里(20 世纪 90 年代至 21 世纪初)
人们不再写规则,而是给机器大量带有答案的例子,这就是机器学习。机器自己算出每个信号有多重要。
但人仍然要事先决定机器该看哪里。比如垃圾邮件过滤器:工程师让它统计"免费"这类词出现的次数、链接数量、大写字母多少。信号选得对,效果就好;选错了,效果就差。那个年代的垃圾邮件过滤和商品推荐大多是这样工作的。
3. 深度学习:机器自己找到该看哪里(2012 年起)
转折点出现在 2012 年。辛顿团队带着一个名为 AlexNet 的大型神经网络参加了 ImageNet 图像识别比赛(训练集有一百多万张标注图片)。AlexNet 的错误率只有 15.3%,而第二名是 26.2%。它是用两块游戏显卡(GPU)训练了五六天完成的。
新在哪里:没有人告诉 AlexNet"去看眼睛和鼻子"。前面的层自己学会识别线条和颜色,后面的层把它们组合成形状,再组合成物体。成功的公式是 大网络 + 大数据 + GPU。2016 年,DeepMind 的 AlphaGo 以 4 比 1 战胜围棋棋手李世石,靠的是深度学习加上与自己对弈数百万局。
坚持这条路的人得到了应有的认可:2018 年图灵奖授予辛顿、杨立昆和约书亚·本吉奥,2024 年诺贝尔物理学奖授予约翰·霍普菲尔德和杰弗里·辛顿。
4. Transformer 与海量文本预训练(2017 年至 2020 年)
2017 年,谷歌发表论文《Attention Is All You Need》,提出了 Transformer 架构。简单说:模型一次读完整个句子,每个词都会"关注"和它相关的词。这种方式非常适合在 GPU 上并行计算,因此可以用海量文本来训练。
再加上一个巧妙的方法:通过预测下一个词来进行预训练。网络上的文本本身就包含答案,不需要任何人标注。具体机制可以看 大语言模型 LLM 是什么。
随后人们发现:模型越大、数据越多、算力越强,模型就越好,而且提升幅度可以预测。GPT-2(2019)有 15 亿个参数,GPT-3(2020)达到 1750 亿个。参数就是模型内部在学习过程中不断调整的"旋钮"。
5. 用人类反馈教会模型"做人"(2022 年)
只会预测下一个词的模型往往答非所问、东拉西扯。2022 年,OpenAI 发布了 InstructGPT,训练分三步:
- 人工为各种请求写出示范回答,让模型模仿。
- 人工给模型的多个回答从好到差排序。
- 模型继续训练,努力在这种排序下得到高分。这叫 RLHF(基于人类反馈的强化学习)。
结果出人意料:评估人员更喜欢 13 亿参数的 InstructGPT,而不是 1750 亿参数的 GPT-3,尽管前者小了 100 多倍。同年年底,ChatGPT 问世。开发 Claude 的 Anthropic 公司还提出了 Constitutional AI(宪法式 AI):写下一套原则,让 AI 依据这些原则批评并修改自己的回答。想了解如何在现有模型上继续训练,可以看 Fine-tuning 是什么。
6. 教会推理与行动(2024 年至今)
2024 年 9 月,OpenAI 发布了 o1,一个被训练成先一步步思考再回答的模型。2025 年 1 月,DeepSeek 发布了 R1(后来发表在《自然》杂志上):他们让模型做数学题,答对就给奖励。没有人教它该怎么想,它却自己养成了检查和纠错的习惯。
这个阶段的关键是答案可以验证的练习题:有正确结果的数学题、能通过测试的代码。机器可以练习数百万次,而不需要人逐题打分。模型还被训练去使用工具、连续完成多个步骤,这正是 AI 智能体(AI agent) 的基础。
| 阶段 | 最难的部分由谁完成 | 典型例子 |
|---|---|---|
| 手写规则 | 工程师写每一条规则 | MYCIN |
| 机器学习 | 人选信号,机器算权重 | 垃圾邮件过滤 |
| 深度学习 | 机器从标注数据中自己找信号 | AlexNet、AlphaGo |
| Transformer + 预训练 | 机器从无标注文本中学习 | GPT-3 |
| 人类反馈 | 人给回答打分 | InstructGPT、ChatGPT |
| 推理 + 行动 | 机器用可验证的题目自我练习 | o1、DeepSeek R1 |
 这对你意味着什么
- AI 是从数据中学习的,不是在查字典。 它给出听起来最合理的回答,所以有时会非常自信地编造内容。数字、人名和引文要再核对一遍。延伸阅读:AI 幻觉是什么。
- 模型被训练成遵循指令,所以要求越清楚,结果越贴近。与其说"写一篇关于咖啡的文章",不如说"写一篇 300 字的文章介绍大叻的一家书店咖啡馆,语气亲切,结尾邀请读者来坐坐"。
- "长时间思考"模式来自第 6 阶段。 遇到难题、多步骤分析、修代码时打开它。简单问题用普通模式更快也更便宜。可以参考 推理模式贵 500 倍,该怎么用。
 常见误解
- "AI 是有了 ChatGPT 才出现的。" 错。AI 已经有 70 多年历史。ChatGPT 是深度学习、Transformer、预训练和人类反馈共同的成果。
- "人们给 AI 预先写好了每一个答案。" 错,那是 70 年代的做法。如今人类设计的是模型如何学习并挑选数据,每个回答都是模型自己生成的。
- "把模型做大就够了。" 不完全对。规模帮助很大,但小 100 倍的 InstructGPT 反而更受欢迎,近年的很多飞跃来自预训练之后的训练:人类反馈、推理练习和工具使用。
 常见问题
AI 是哪一年诞生的? "artificial intelligence"一词出现在 1955 年为 1956 年达特茅斯夏季研讨会写的提案中,这次研讨会通常被视为 AI 领域的起点。
深度学习的想法早就有了,为什么到 2012 年才爆发? 因为要等两样东西:大规模标注数据(比如 ImageNet)和足够快的 GPU。两者齐备后,AlexNet 以巨大优势获胜。
简单说,Transformer 是什么? 一种让模型一次读完整段文字、并让每个词关注相关词的架构。如今几乎所有大型聊天机器人,包括 ChatGPT、Claude、Gemini,都建立在它之上。
RLHF 和预训练有什么区别? 预训练通过在海量文本上预测下一个词,教给模型知识和语言能力。RLHF 则根据人类打分教模型如何表现:切题、有用、安全。
"推理"模型真的会思考吗? 它们被训练成在回答前写出中间步骤,这让它们在难题上更准确。但它们仍可能出错,重要的事情请自己核对结果。
 为什么打越南语比打英语消耗更多token?



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制