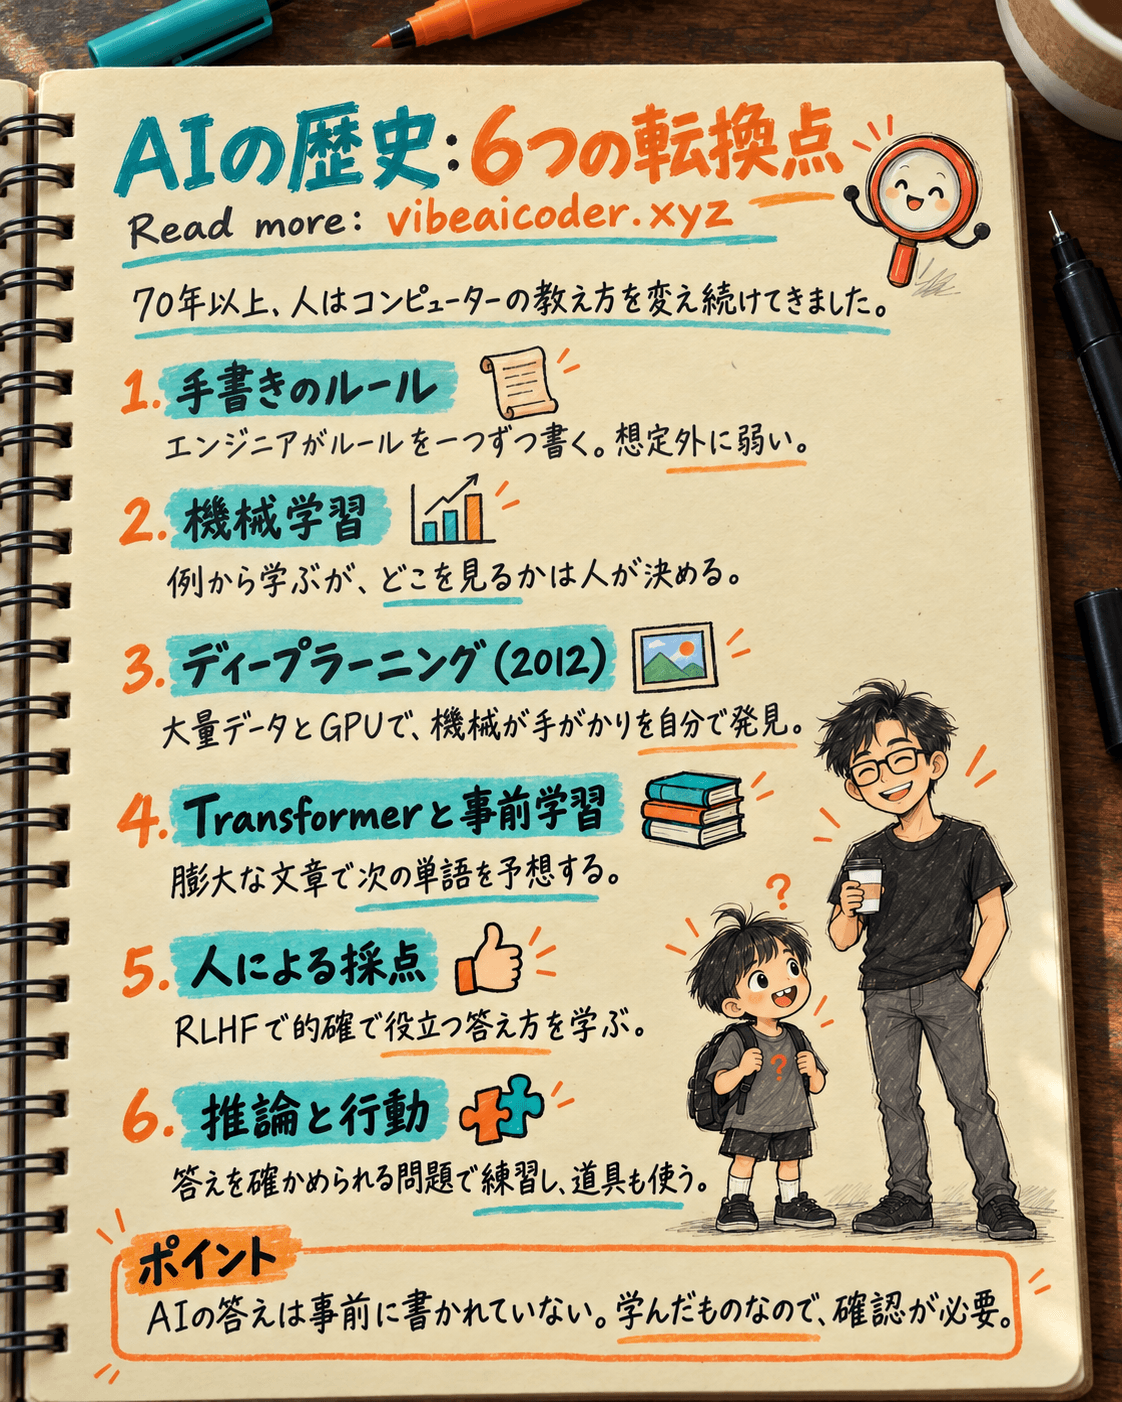
 AIの歴史:機械の教え方を変えた6つの転換点、手書きのルールから考えるAIまで
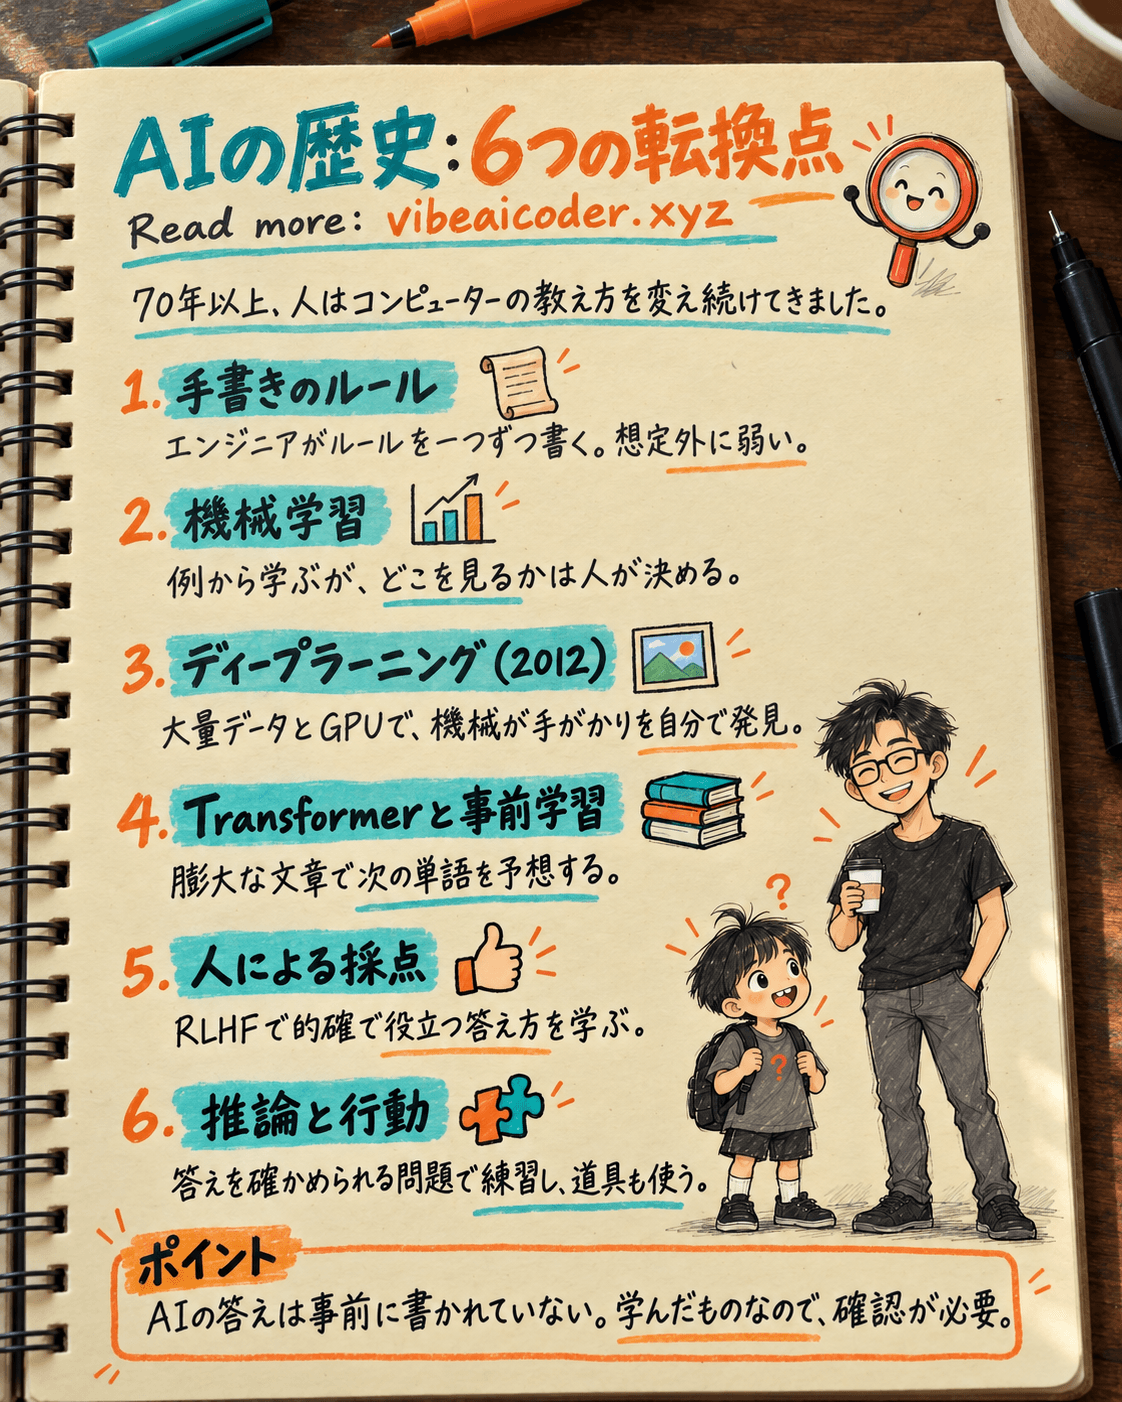
AIの歴史は、人間が70年以上かけてコンピューターの「教え方」を変え続けてきた物語です。最初はエンジニアがルールを一つずつ手で書いていました。今では、機械が何兆もの単語から自分で学び、その後に人の評価を受け、練習を重ねて一歩ずつ考えられるようになっています。この流れがわかると、ChatGPTやClaudeがなぜこれほど賢いのか、そしてなぜ今でも間違えるのかが見えてきます。
AIについてまだよく知らない方は、まず AIとは何か、初心者向けのやさしい解説 を読んでみてください。
身近な例でざっくり理解
見習いにラーメン作りを教えることを、6つの時代に分けて想像してみましょう。
- 細かいルール帳を渡す:「お湯が沸いたら火を弱める、しょっぱければ水を足す」。帳面にない状況になると、見習いは固まってしまいます。
- たくさんの丼を味見させるが、見るポイントはあなたが教える:スープの澄み具合、肉のやわらかさ。どれがおいしいかは見習いが自分で判断します。
- 大量の丼を味見させ、何も教えない:おいしい一杯の決め手を見習いが自分で見つけます。
- 世界中のレシピ本をすべて読ませてから、厨房に入れます。
- 料理長が一杯ずつ採点する:これはお客さんに好評、あれはもう一歩。
- 正解がはっきりした練習問題を出し、「作る前に一歩ずつ考えて」と伝え、はかりや温度計などの道具も持たせます。
この6つの教え方は、AIモデルづくりの6つの時代にほぼそのまま対応しています。
 AIのつくり方はどう進化してきたか
1. ルールを手で書く(1950年代から1980年代)
1950年、アラン・チューリングは「機械は考えることができるか」と問いかけました。1955年、4人の科学者(ジョン・マッカーシー、マービン・ミンスキー、ナサニエル・ロチェスター、クロード・シャノン)が、1956年にアメリカのダートマス大学で開く夏の研究会の提案書を書きました。**「artificial intelligence(人工知能)」**という言葉は、この提案書から生まれたとされています。
当時のやり方は、エンジニアが専門家に聞き取りをし、その知識を何百、何千もの**「もし…なら…」というルールにすることでした。これをエキスパートシステム**と呼びます。たとえば1970年代にスタンフォード大学で作られたMYCINは、約600のルールで血液感染症の原因菌を特定し、抗生物質を提案しました。
弱点は、世の中が例外だらけだということです。ルールが増えるほど直すのが難しくなり、想定外のことが起きると壊れます。期待が外れると研究資金が削られ、研究者たちはこの時期を**「AIの冬」**と呼びました。
同じ頃、あまり注目されていなかった別の道が育っていました。ニューラルネットワークです。1958年、フランク・ローゼンブラットはルールではなく例から分類を学ぶパーセプトロンを作りました。1986年には、デビッド・ラメルハート、ジェフリー・ヒントン、ロナルド・ウィリアムズが、多層のネットワークに自分の誤りを直させる学習方法を広めました(誤差逆伝播法:予想が外れたら、どの部分が原因かを逆にたどって調整する方法)。良いアイデアでしたが、当時はコンピューターが非力で、データも足りませんでした。
2. データから学ぶ、見る場所は人が決める(1990年代から2000年代)
ルールを書く代わりに、答えのわかっている例を大量に機械に与えるようになりました。これが機械学習です。それぞれの手がかりがどれだけ重要かは、機械が自分で計算します。
ただし、機械がどこを見るべきかは、まだ人が先に決める必要がありました。たとえば迷惑メールフィルターでは、エンジニアが「無料」という言葉の回数、リンクの数、大文字の多さなどを数えるよう指示しました。手がかりの選び方が良ければうまくいき、悪ければうまくいきません。当時の迷惑メール対策や商品のおすすめの多くは、この方式で動いていました。
3. ディープラーニング:見る場所を機械が自分で見つける(2012年から)
転機は2012年に訪れました。ヒントンのチームが AlexNet という大きなニューラルネットワークで、画像認識コンテストImageNet(学習用のラベル付き画像は100万枚以上)に参加したのです。AlexNetの誤り率は15.3%で、2位は26.2%でした。学習には、ゲーム用のグラフィックボード(GPU)2枚で5〜6日かかりました。
新しかったのは、誰もAlexNetに「目や鼻を見なさい」と教えなかったことです。前のほうの層が線や色を自分で学び、後ろの層がそれを形に、さらに物体へと組み立てていきました。成功の方程式は 大きなネットワーク + 大量のデータ + GPU です。2016年には、DeepMindのAlphaGoが、ディープラーニングと何百万局もの自己対局を組み合わせて、囲碁の李世乭(イ・セドル)氏に4勝1敗で勝ちました。
この道を信じ続けた人たちは正当に評価されました。2018年のチューリング賞はヒントン、ヤン・ルカン、ヨシュア・ベンジオに、2024年のノーベル物理学賞はジョン・ホップフィールドとジェフリー・ヒントンに贈られています。
4. Transformerと大量テキストでの事前学習(2017年から2020年)
2017年、Googleは論文「Attention Is All You Need」で Transformer を発表しました。簡単に言うと、モデルが文全体を一度に読み、それぞれの単語が関係のある単語に「注意を向ける」仕組みです。GPUでの並列計算にとても向いているため、膨大な量の文章で学習できるようになりました。
そこに一つの賢い工夫が加わりました。次の単語を予想することによる事前学習です。ネット上の文章にはもともと答えが含まれているので、誰かがラベルを付ける必要がありません。仕組みは 大規模言語モデルLLMとは で詳しく解説しています。
さらに研究者たちは、モデルを大きくし、データと計算量を増やすほど性能が上がり、しかもその伸びが予測できることに気づきました。GPT-2(2019年)は15億パラメータ、GPT-3(2020年)は1750億パラメータです。パラメータとは、学習しながら少しずつ調整されるモデル内部の「つまみ」のことです。
5. 人のフィードバックで振る舞いを教える(2022年)
次の単語を予想するだけのモデルは、話がそれたり、頼んだことからずれたりしがちです。2022年、OpenAIはInstructGPTを発表しました。学習は3段階です。
- 人がさまざまな依頼への模範回答を書き、モデルがそれをまねる。
- 人がモデルの回答を良い順に並べる。
- モデルがその順位で高い点を取れるようにさらに学習する。これを RLHF(人間のフィードバックによる強化学習)と呼びます。
結果は驚くべきものでした。評価者は、1750億パラメータのGPT-3よりも、100分の1以下の13億パラメータのInstructGPTの回答を好んだのです。その年の終わりにChatGPTが登場しました。Claudeを開発するAnthropicは、Constitutional AIという方法も打ち出しました。原則を文章で書き出し、AIがその原則に沿って自分の回答を批判し、直すというものです。既存のモデルを追加で学習させる方法については ファインチューニングとは をご覧ください。
6. 推論と行動を教える(2024年から現在)
2024年9月、OpenAIは答える前に一歩ずつ考えるよう訓練されたモデルo1を発表しました。2025年1月にはDeepSeekがR1を公開しました(後に科学誌Natureにも掲載)。数学の問題を解かせ、正解したら報酬を与えるという方法です。考え方は誰も教えていないのに、モデルは自分で答えを見直し、誤りを直す習慣を身につけました。
この時代の鍵は、答えを確かめられる練習問題です。正解のある数学の問題や、テストに通るかどうかがわかるコードなどです。人が一問ずつ採点しなくても、機械は何百万回も練習できます。さらにモデルは道具を使い、いくつもの手順を続けて実行するよう訓練されています。これが AIエージェント の土台です。
| 時代 | いちばん難しい部分を担うのは | 代表例 |
|---|---|---|
| 手書きのルール | エンジニアがすべてのルールを書く | MYCIN |
| 機械学習 | 人が手がかりを選び、機械が重みを計算 | 迷惑メールフィルター |
| ディープラーニング | 機械がラベル付きデータから手がかりを発見 | AlexNet、AlphaGo |
| Transformer + 事前学習 | 機械がラベルなしの文章から学ぶ | GPT-3 |
| 人のフィードバック | 人が回答を採点 | InstructGPT、ChatGPT |
| 推論 + 行動 | 機械が確かめられる問題で自主練習 | o1、DeepSeek R1 |
 あなたにとっての意味
- AIはデータから学んでいて、辞書を引いているわけではありません。 もっともらしい答えを出すので、自信満々に作り話をすることがあります。数字、人名、引用は確認しましょう。関連記事:AIのハルシネーションとは。
- モデルは指示に従うよう訓練されているので、依頼が明確なほど結果も的確になります。「コーヒーについて書いて」ではなく、「ダラットにあるブックカフェを300字で紹介して。親しみやすい口調で、最後に来店を誘う一文を入れて」のように頼みましょう。
- じっくり考えるモードは第6の時代の産物です。 難しい問題、何段階もの分析、コードの修正ではオンにしましょう。簡単な質問なら通常モードのほうが速く、安く済みます。使い分けは 推論モードは500倍高くつく を参考にしてください。
 よくある誤解
- 「AIはChatGPTから始まった」 違います。AIには70年以上の歴史があります。ChatGPTはディープラーニング、Transformer、事前学習、人のフィードバックを組み合わせた成果です。
- 「人がAIに答えを一つずつプログラムしている」 違います。それは1970年代のやり方です。今の人間はモデルの学び方を設計し、データを選びます。答えは毎回モデル自身が生み出しています。
- 「モデルを大きくすれば十分」 そうとも限りません。大きさは大いに役立ちますが、100分の1の大きさのInstructGPTのほうが好まれましたし、最近の飛躍の多くは事前学習の後の訓練、つまり人のフィードバック、推論の練習、道具の使い方から生まれています。
 よくある質問
AIはいつ誕生したのですか? 「artificial intelligence」という言葉は、1956年のダートマス夏季研究会のために1955年に書かれた提案書に登場しました。この研究会がAI分野の始まりとされることが多いです。
ディープラーニングの考え方は昔からあったのに、なぜ2012年に一気に広まったのですか? 2つの条件がそろうのを待つ必要があったからです。大量のラベル付きデータ(ImageNetなど)と、計算を速くこなせるGPUです。両方がそろったとき、AlexNetが大差で勝ちました。
Transformerとは、ひとことで言うと何ですか? 文章全体を一度に読み、各単語が関係する単語に注目できるようにする仕組みです。ChatGPT、Claude、Geminiなど、今の主要なチャットボットのほとんどがこれを土台にしています。
RLHFと事前学習の違いは何ですか? 事前学習は、膨大な文章で次の単語を予想することで、知識と言葉づかいを教えます。RLHFは人の採点をもとに、的確で役に立ち安全に答えるという振る舞いを教えます。
「推論」モデルは本当に考えているのですか? 答える前に途中の手順を書き出すよう訓練されていて、そのおかげで難しい問題での正答率が上がります。それでも間違えることはあるので、大事な場面では結果を自分で確かめてください。
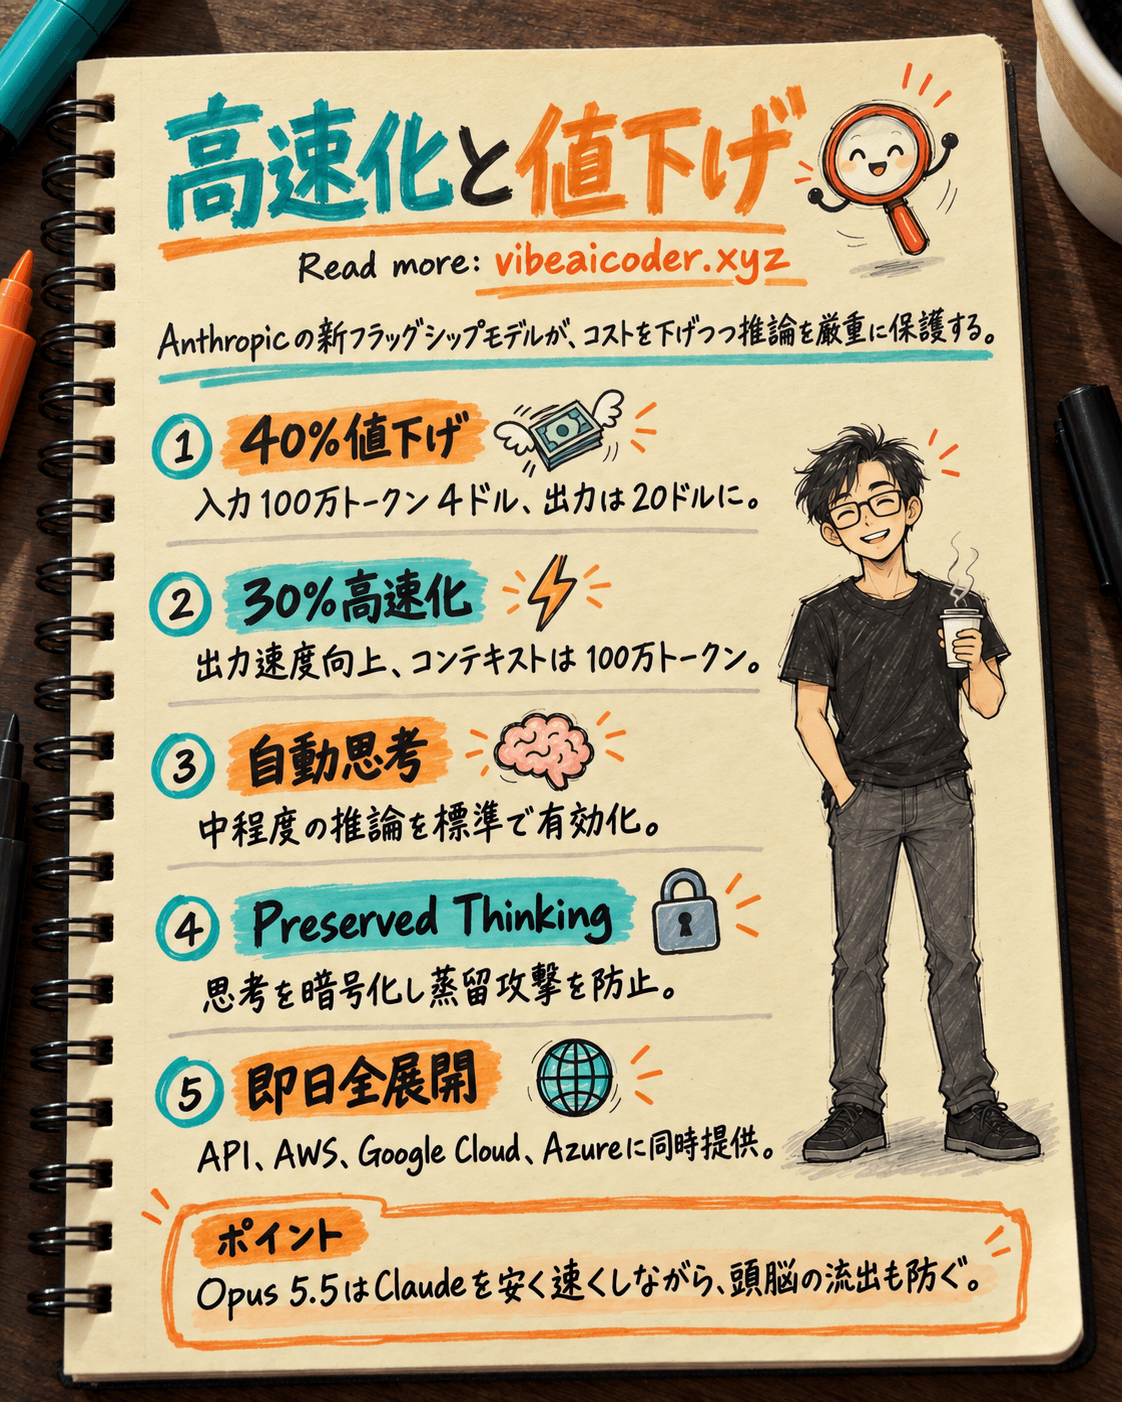
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止