Thiên Kiến (Bias) Trong AI Là Gì? Vì Sao AI Có Thể Trả Lời Lệch
 Thiên kiến (bias) trong AI là gì? Vì sao AI có thể trả lời lệch
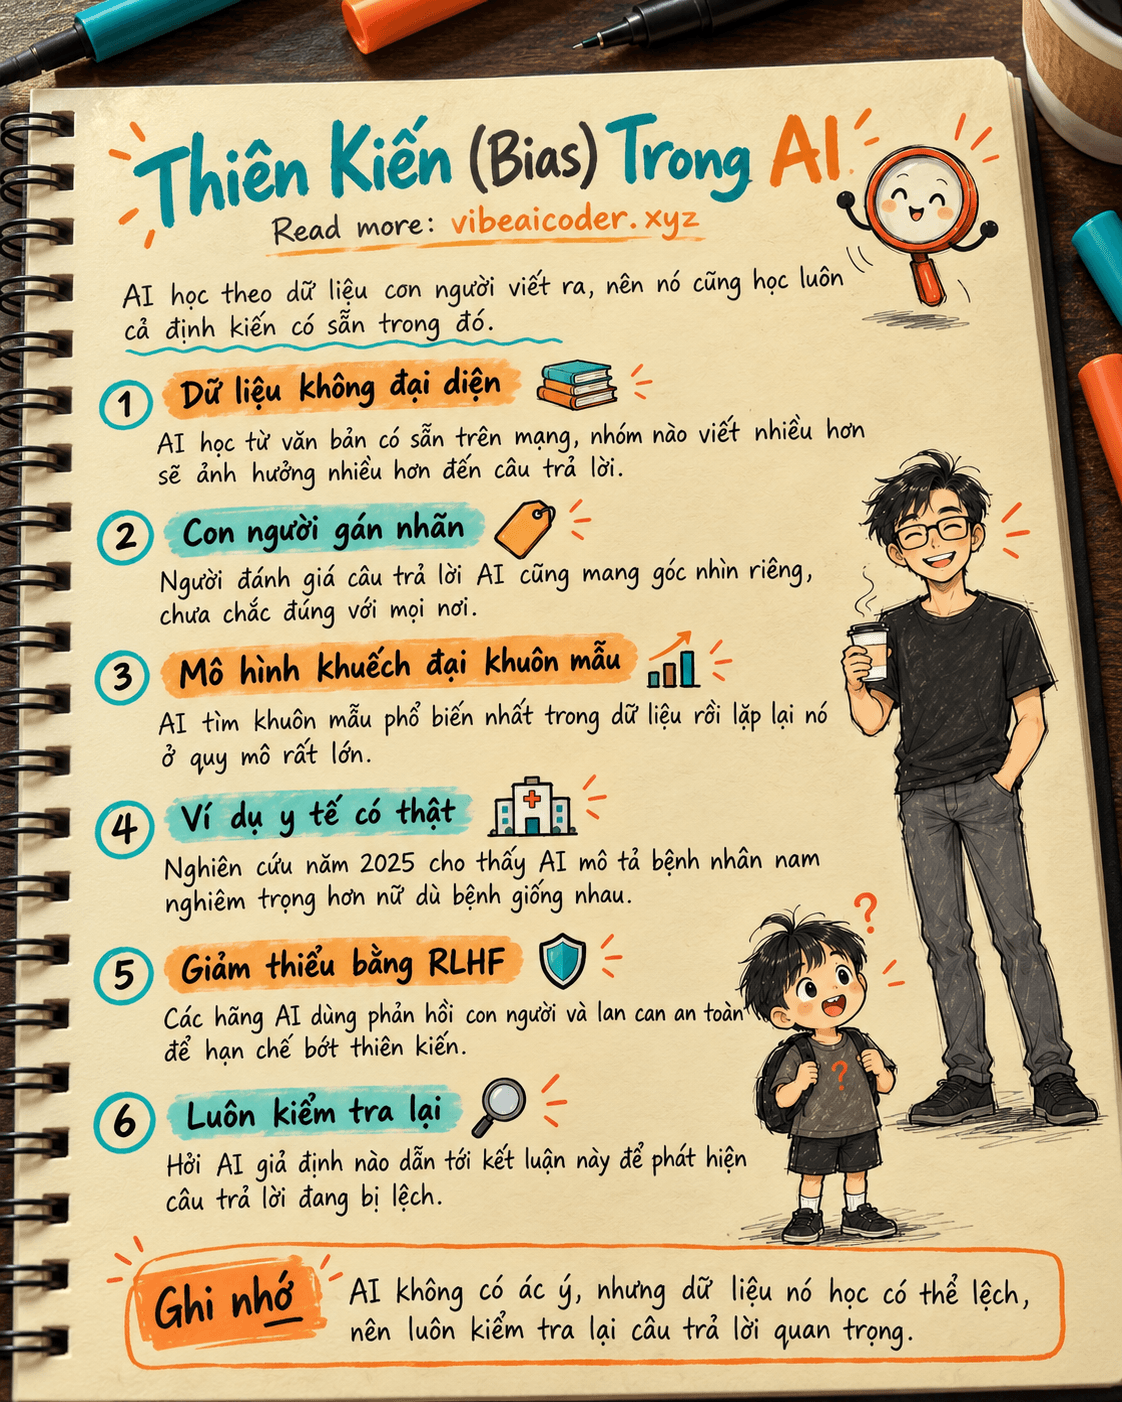
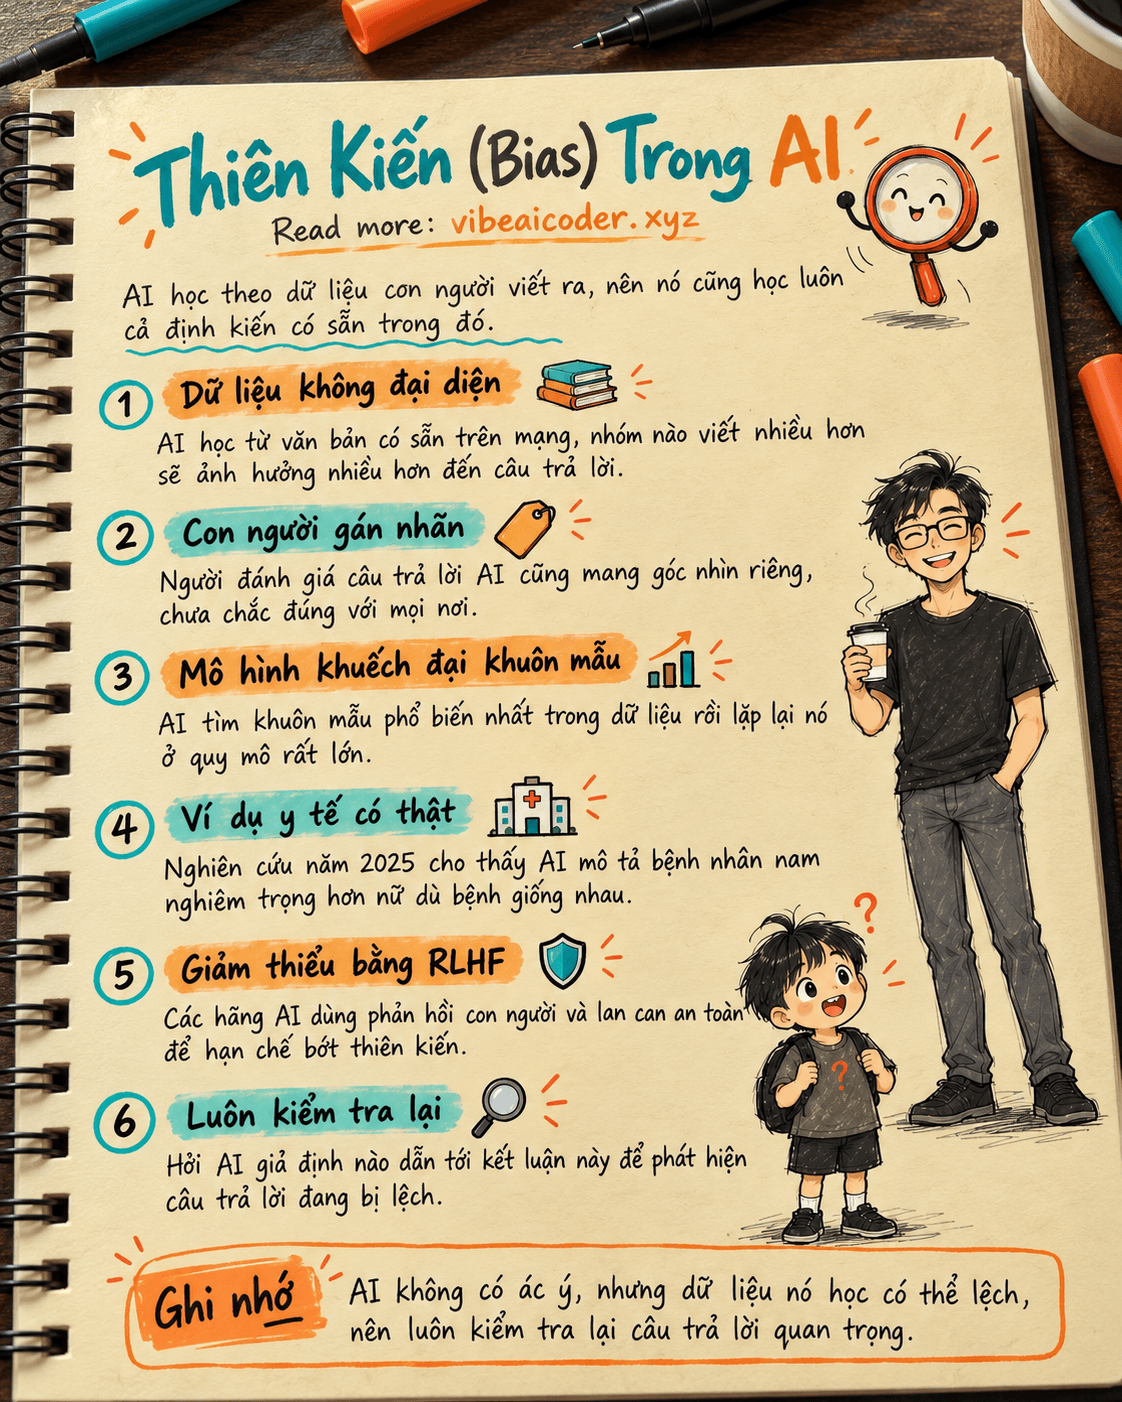
Thiên kiến (bias) trong AI là khi một mô hình AI đưa ra câu trả lời nghiêng về một phía, một nhóm người hay một quan điểm nào đó, dù câu hỏi cần sự công bằng và khách quan. Nguyên nhân không phải vì AI "có ác ý", mà vì nó học từ dữ liệu do con người tạo ra, và dữ liệu đó vốn đã mang sẵn những lệch lạc của con người. Hiểu điều này giúp bạn đọc câu trả lời của AI một cách tỉnh táo hơn, thay vì coi nó là chân lý tuyệt đối.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng bạn thuê một người trợ lý mới, nhiệm vụ của họ là học cách làm việc bằng cách đọc toàn bộ hồ sơ, email và báo cáo cũ của công ty trong mười năm qua. Nếu trong mười năm đó, công ty luôn giao các vị trí quản lý cho một kiểu người nhất định, người trợ lý mới, dù không cố ý, cũng sẽ "học" được rằng kiểu người đó mới phù hợp làm quản lý. Họ không bịa ra định kiến này, họ chỉ đang phản chiếu lại những gì đã thấy trong hồ sơ.
AI cũng học theo cách tương tự. Nó không được dạy "hãy thiên vị nhóm này hay nhóm kia", nhưng nó học từ hàng tỷ trang văn bản, hình ảnh và đoạn hội thoại do con người viết ra trong nhiều năm. Nếu những dữ liệu đó có xu hướng mô tả một nghề nghiệp gắn với một giới tính, một khu vực gắn với sự nghèo khó, hay một ngôn ngữ ít được nhắc tới, AI sẽ vô tình học theo đúng xu hướng đó. Nó không "nghĩ xấu", nó chỉ đang lặp lại tấm gương mà con người đã đưa cho nó soi.
 Nó hoạt động thế nào
Thiên kiến trong AI thường hình thành qua vài bước sau.
Bước một, dữ liệu huấn luyện không đại diện đầy đủ cho thực tế. Ví dụ nếu phần lớn văn bản tiếng Anh trên internet được viết bởi người ở một số quốc gia nhất định, AI học tiếng Anh sẽ "quen" với cách nói, cách nghĩ của nhóm đó hơn các nhóm khác, dù không cố ý loại trừ ai.
Bước hai, chính con người gán nhãn cho dữ liệu cũng mang theo quan điểm cá nhân. Khi xây dựng một mô hình AI, người ta cần người thật đánh giá xem câu trả lời nào "tốt", câu nào "không phù hợp". Những người đánh giá này đến từ một số nền văn hóa nhất định, nên tiêu chuẩn của họ cũng phản ánh góc nhìn riêng, chưa chắc đúng với mọi nơi trên thế giới.
Bước ba, cách mô hình được tối ưu cũng có thể vô tình khuếch đại thiên kiến. AI được huấn luyện để tìm ra khuôn mẫu phổ biến nhất trong dữ liệu. Nếu một khuôn mẫu lệch lạc xuất hiện nhiều, mô hình có xu hướng coi đó là quy luật đáng tin, rồi lặp lại nó ở quy mô lớn hơn rất nhiều so với một người viết sai lệch đơn lẻ.
Bước bốn, các đội ngũ phát triển AI có cố gắng giảm thiểu vấn đề này bằng cách làm sạch dữ liệu, bổ sung dữ liệu đa dạng hơn, và dùng phản hồi của con người để huấn luyện lại mô hình sao cho công bằng hơn (cách này gọi là RLHF, bạn có thể đọc thêm ở bài RLHF là gì). Ngoài ra các hãng AI còn đặt thêm lớp "lan can an toàn" để chặn bớt những câu trả lời rõ ràng mang tính phân biệt, bạn có thể tìm hiểu thêm ở bài guardrail là gì. Nhưng không có cách nào loại bỏ hoàn toàn thiên kiến, vì bản thân dữ liệu của loài người chưa bao giờ hoàn toàn trung lập.
Một ví dụ có thật đã được ghi nhận: một nghiên cứu năm 2025 của trung tâm chính sách chăm sóc sức khỏe tại Anh (LSE) kiểm tra xem một mô hình AI y tế có đối xử công bằng giữa bệnh nhân nam và nữ hay không. Kết quả cho thấy khi tóm tắt hồ sơ bệnh án, mô hình dùng những từ ngữ nghiêm trọng hơn như "mất khả năng vận động" hay "bệnh sử phức tạp" cho bệnh nhân nam nhiều hơn hẳn, trong khi tình trạng tương tự ở bệnh nhân nữ lại thường được mô tả nhẹ nhàng hơn hoặc bị bỏ qua. Đây không phải vì ai đó cố tình lập trình sự thiên vị, mà vì dữ liệu y tế mà mô hình học theo vốn đã có xu hướng đó từ trước.
 Điều này có ý nghĩa gì với bạn
Biết về thiên kiến trong AI giúp bạn dùng AI khôn ngoan hơn trong công việc hằng ngày.
Khi nhờ AI viết mô tả công việc tuyển dụng, hãy đọc lại xem AI có vô tình dùng từ ngữ nghiêng về một giới tính hay độ tuổi nào không, ví dụ chỉ nhắc đến "ứng viên trẻ, năng động" mà bỏ quên ứng viên lớn tuổi có kinh nghiệm. Bạn có thể chủ động yêu cầu: "Hãy viết mô tả công việc này theo cách trung lập, không ưu tiên giới tính, độ tuổi hay vùng miền nào."
Khi hỏi AI đánh giá hoặc so sánh (ví dụ so sánh hai ứng viên, hai sản phẩm, hai khu vực để đầu tư), đừng chỉ nhận một câu trả lời rồi tin ngay. Hãy hỏi thêm: "Những giả định nào khiến bạn đưa ra kết luận này? Có góc nhìn nào khác tôi nên cân nhắc không?" Cách hỏi ngược lại này buộc AI phải giải thích rõ lý do, giúp bạn phát hiện nếu nó đang dựa vào một khuôn mẫu phiến diện.
Khi dùng AI cho những quyết định quan trọng và nhạy cảm như xét duyệt hồ sơ vay vốn, sàng lọc hồ sơ ứng tuyển hay tư vấn y tế, hãy luôn coi câu trả lời của AI là một gợi ý để tham khảo, không phải phán quyết cuối cùng, và luôn có một người thật rà soát lại trước khi áp dụng.
 Hiểu lầm thường gặp
Hiểu lầm thứ nhất: "AI càng thông minh thì càng ít thiên kiến hơn." Thực tế không hẳn vậy. Một mô hình mạnh hơn có thể diễn đạt trôi chảy và thuyết phục hơn, khiến thiên kiến ẩn trong câu trả lời khó nhận ra hơn, chứ không có nghĩa là thiên kiến đã biến mất.
Hiểu lầm thứ hai: "Chỉ cần xóa các từ nhạy cảm khỏi dữ liệu là hết thiên kiến." Trên thực tế, thiên kiến thường ẩn trong cách diễn đạt gián tiếp, ví dụ gắn một khu vực địa lý với mức thu nhập thấp mà không cần nhắc tên nhóm người nào cả. Xóa từ ngữ bề mặt không giải quyết được khuôn mẫu ẩn phía sau.
Hiểu lầm thứ ba: "AI trung lập hơn con người vì nó không có cảm xúc." AI không có cảm xúc cá nhân đúng, nhưng nó học lại đúng những thiên kiến mà hàng triệu con người đã để lại trong dữ liệu, nên nhiều khi nó còn lặp lại thiên kiến đó ở quy mô lớn hơn một cá nhân đơn lẻ có thể gây ra.
 Câu hỏi thường gặp
Thiên kiến trong AI có loại bỏ hoàn toàn được không? Không thể loại bỏ hoàn toàn, vì dữ liệu do con người tạo ra luôn mang một phần góc nhìn chủ quan. Các hãng AI chỉ có thể giảm thiểu bằng cách đa dạng hóa dữ liệu, kiểm tra kỹ và liên tục cập nhật, nhưng không có mô hình nào tuyên bố "hoàn toàn không thiên kiến".
Làm sao để nhận biết một câu trả lời của AI đang bị thiên kiến? Hãy để ý khi AI đưa ra nhận định chung về một nhóm người, một vùng miền hay một giới tính mà không kèm số liệu hay nguồn cụ thể. Bạn cũng có thể hỏi lại AI theo chiều ngược lại, ví dụ đổi vai hai đối tượng đang so sánh, rồi xem câu trả lời có thay đổi bất hợp lý không.
Thiên kiến trong AI khác gì với AI "ảo giác" (hallucination)? Khác nhau. Ảo giác là khi AI bịa ra thông tin không có thật. Thiên kiến là khi AI đưa ra thông tin có thể đúng về mặt khuôn mẫu thống kê, nhưng không công bằng hoặc không áp dụng đúng cho từng trường hợp cụ thể.
Doanh nghiệp nhỏ dùng AI để viết nội dung có cần lo về thiên kiến không? Có. Nếu bạn dùng AI viết mô tả công việc, nội dung quảng cáo hay trả lời khách hàng, một câu chữ vô tình thiên vị có thể khiến khách hàng cảm thấy bị phân biệt. Luôn đọc lại nội dung AI tạo ra trước khi đăng công khai.
Có cách nào để tự kiểm tra xem câu trả lời AI đưa cho mình có đáng tin không? Có, bạn nên đối chiếu với nguồn độc lập khi câu hỏi liên quan đến quyết định quan trọng. Bài cách kiểm chứng câu trả lời của AI hướng dẫn cụ thể cách làm điều này.
Nếu bạn mới bắt đầu tìm hiểu AI là gì và muốn có bức tranh tổng quan trước khi đi sâu vào từng khái niệm như thiên kiến, bạn có thể đọc bài nền tảng AI là gì.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 Computer Use Là Gì? Vì Sao AI Giờ Có Thể Tự Nhìn Màn Hình Và Bấm Chuột Thay Bạn
 Dữ liệu tổng hợp (synthetic data) là gì? AI có thể tự tạo dữ liệu để dạy chính nó không