Guardrail là gì? Vì sao chatbot AI đôi khi từ chối trả lời bạn
 Guardrail là gì? Vì sao chatbot AI đôi khi từ chối trả lời bạn
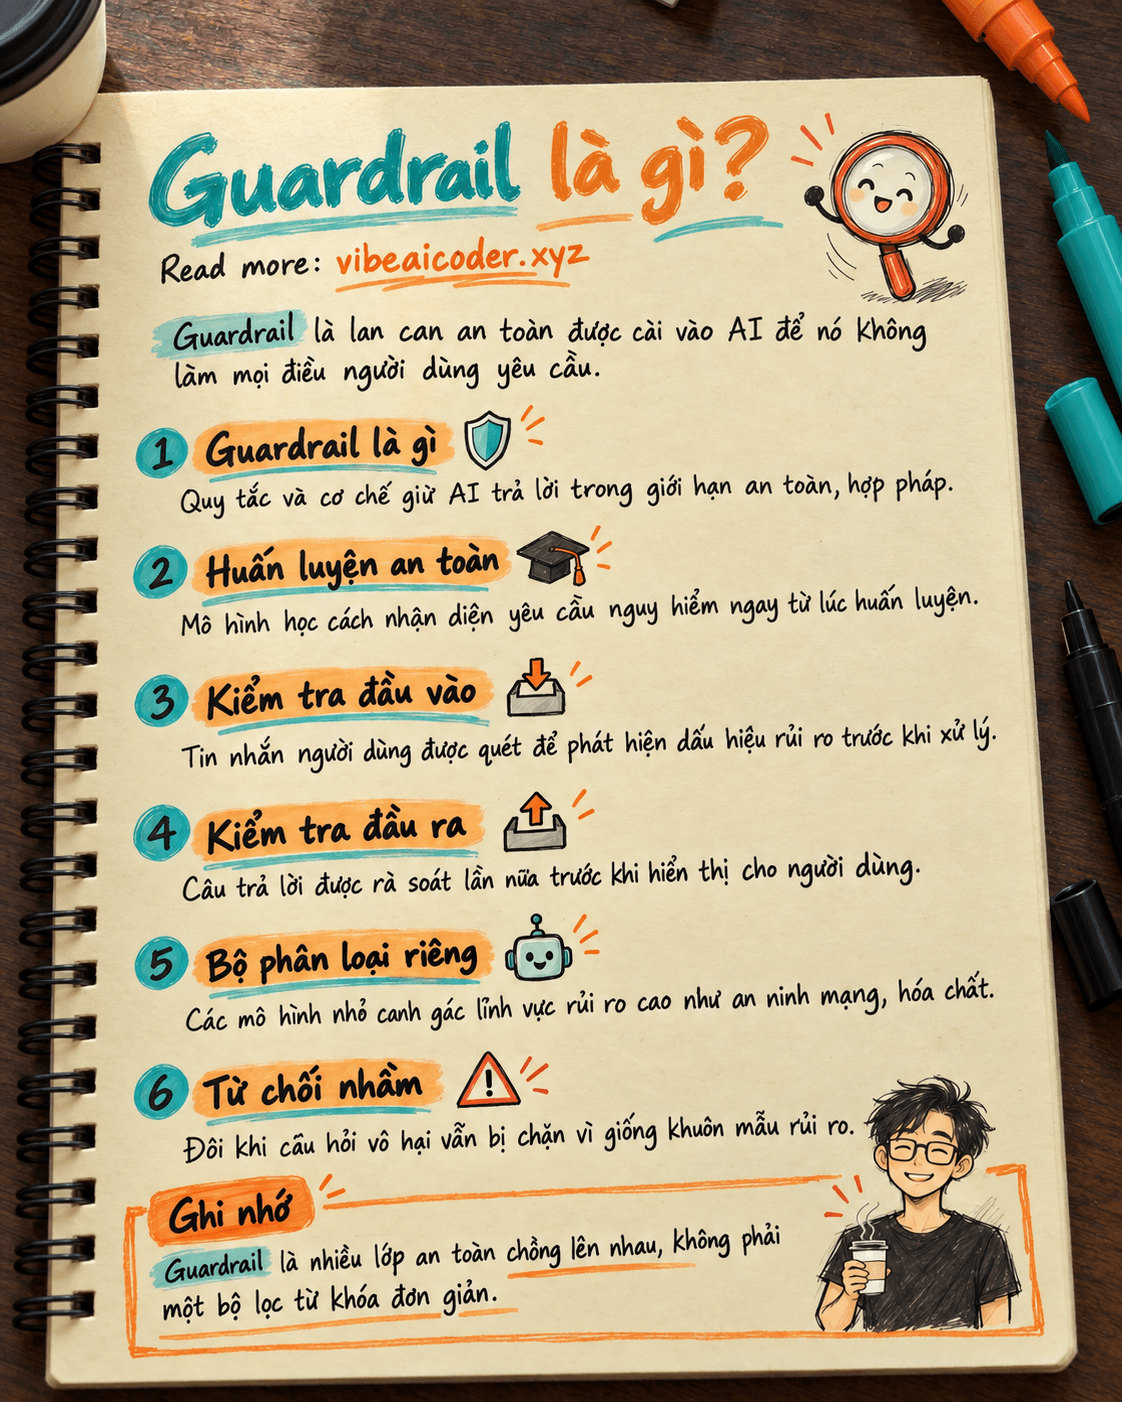
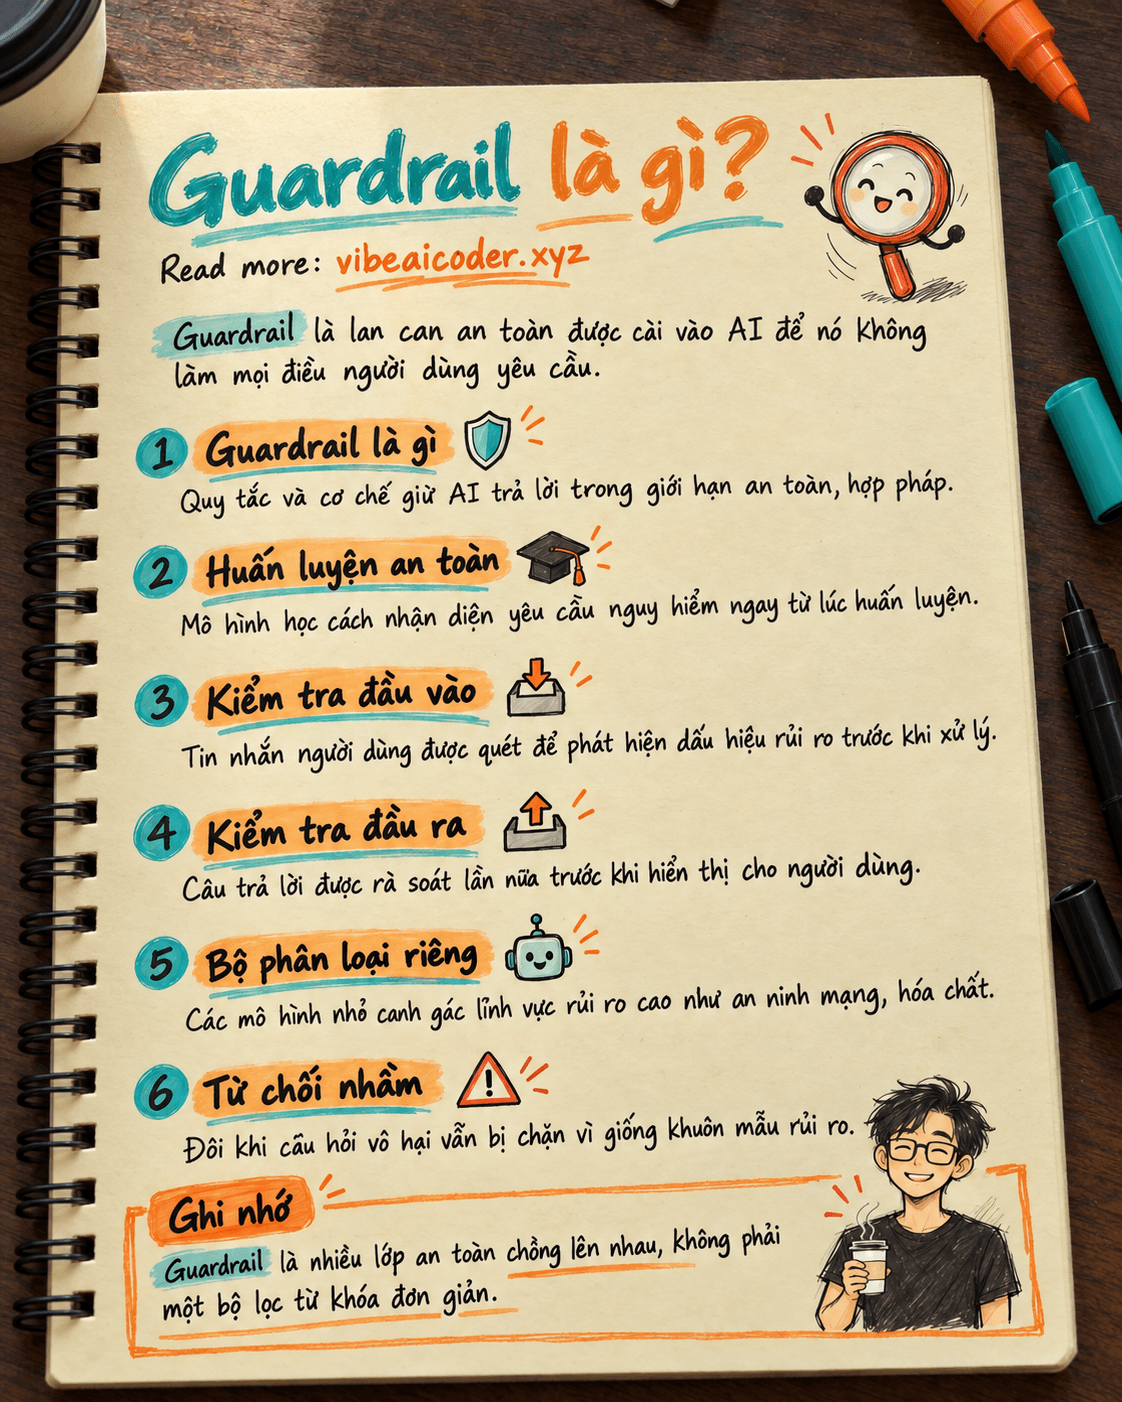
Guardrail (tạm dịch: lan can bảo vệ) là tập hợp các quy tắc và cơ chế được cài vào AI để giữ cho nó trả lời trong giới hạn an toàn và hợp pháp, thay vì làm bất cứ điều gì người dùng yêu cầu. Nhờ guardrail, một chatbot như ChatGPT hay Claude sẽ từ chối hoặc né tránh những câu hỏi có thể dẫn tới nội dung nguy hiểm, lừa đảo, vi phạm quyền riêng tư, dù câu hỏi đó được viết khéo đến đâu.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng một nhân viên tư vấn mới vào làm ở ngân hàng. Trước khi được gặp khách hàng, nhân viên này được huấn luyện kỹ: không được tiết lộ thông tin tài khoản người khác, không được tư vấn những sản phẩm trái quy định, gặp câu hỏi nhạy cảm thì phải chuyển cho quản lý. Những quy tắc đó không nằm trong đầu khách hàng, mà nằm trong quy trình làm việc của nhân viên.
Guardrail của AI cũng vậy. Nó là "bộ quy tắc nội bộ" được cài vào mô hình và vào cả hệ thống xung quanh mô hình, để dù người dùng hỏi theo cách nào, AI vẫn giữ đúng giới hạn đã được huấn luyện và kiểm tra từ trước.
 Nó hoạt động thế nào
Guardrail không phải một công tắc duy nhất, mà là nhiều lớp kiểm tra chồng lên nhau:
- Huấn luyện an toàn ngay từ gốc. Trong lúc huấn luyện, mô hình được cho xem rất nhiều ví dụ về yêu cầu nên từ chối (ví dụ hướng dẫn làm vũ khí, lừa đảo) và học cách nhận diện kiểu yêu cầu đó, dù câu chữ có thay đổi.
- Kiểm tra đầu vào (input guardrail). Trước khi mô hình xử lý, tin nhắn của người dùng được quét qua để phát hiện các dấu hiệu rủi ro: từ khóa nhạy cảm, cách diễn đạt giống kiểu lách luật.
- Kiểm tra đầu ra (output guardrail). Câu trả lời mô hình định đưa ra cũng được rà soát lần nữa trước khi hiển thị cho người dùng, để chặn những nội dung lọt lưới ở bước huấn luyện.
- Bộ phân loại chuyên biệt (classifier). Nhiều hãng AI, trong đó có Anthropic, dùng thêm các mô hình nhỏ chuyên "canh gác" một số lĩnh vực rủi ro cao như an ninh mạng, hóa chất, sinh học, nội dung lạm dụng.
- Giới hạn ở tầng hệ thống. Ngoài nội dung, guardrail còn kiểm soát cả hành vi: giới hạn số lần gọi API, chặn truy cập dữ liệu không được phép, ghi log để phát hiện lạm dụng.
Vì các lớp kiểm tra này dựa trên xác suất và khuôn mẫu ngôn ngữ chứ không đọc được "ý định thật" trong đầu người hỏi, thỉnh thoảng một câu hỏi học thuật hoặc công việc hoàn toàn bình thường vẫn bị từ chối oan, gọi là "từ chối nhầm" (false refusal).
 Điều này có ý nghĩa gì với bạn
Hiểu guardrail giúp bạn dùng AI hiệu quả hơn thay vì bực mình khi bị từ chối:
- Khi AI từ chối, thử diễn đạt lại rõ mục đích hợp pháp. Ví dụ thay vì hỏi "cách bẻ khóa phần mềm X", hãy nói rõ "mình là lập trình viên, cần hiểu lỗ hổng bảo mật Y để vá cho hệ thống của công ty mình". Nêu bối cảnh thật thường giúp AI phân biệt được yêu cầu học thuật với yêu cầu có hại.
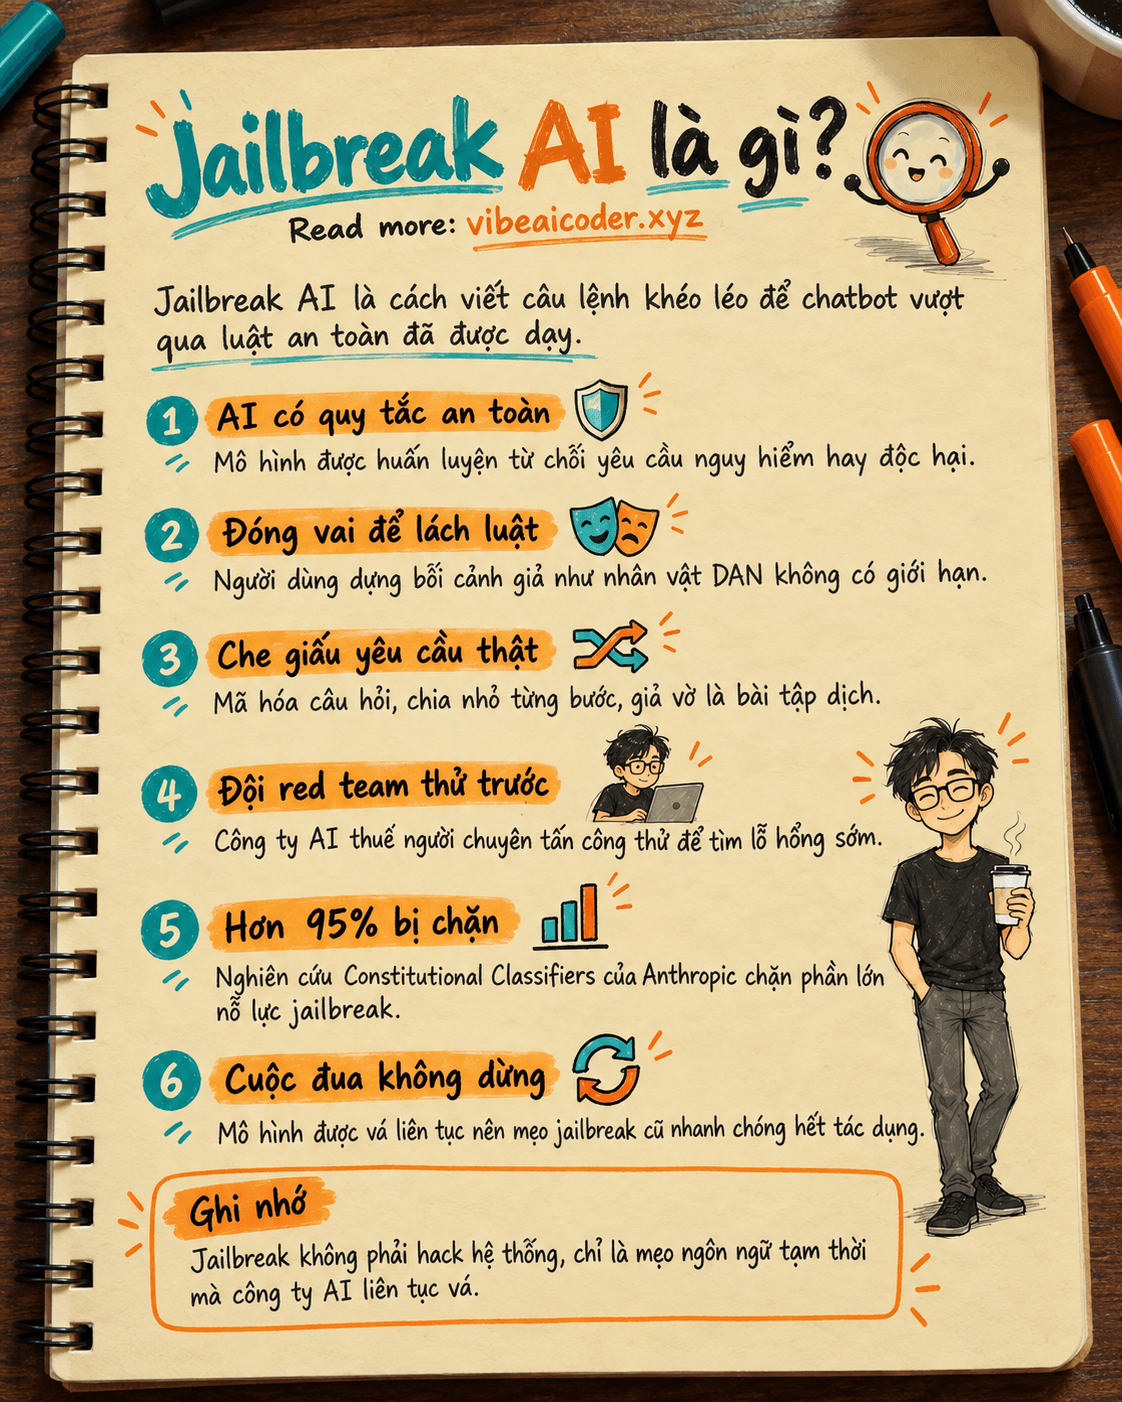
- Đừng cố "lách" guardrail bằng mẹo (jailbreak). Nếu AI từ chối một yêu cầu thật sự nhạy cảm, việc tìm cách lách qua không chỉ vi phạm điều khoản sử dụng, tài khoản có thể bị cảnh báo hoặc khóa, mà câu trả lời nhận được cũng không đáng tin vì nó đi vòng qua lớp kiểm duyệt.
- Khi xây AI agent cho công việc riêng, tự thiết kế thêm guardrail của mình. Ví dụ nếu bạn làm chatbot chăm sóc khách hàng, nên giới hạn nó chỉ trả lời trong phạm vi sản phẩm của công ty, không tự ý hứa hẹn chính sách hoàn tiền hay tiết lộ thông tin nội bộ.
 Hiểu lầm thường gặp
- "AI từ chối nghĩa là chủ đề đó hoàn toàn cấm." Không hẳn. Rất nhiều lần AI từ chối chỉ vì cách đặt câu hỏi giống với mẫu câu rủi ro, chứ bản thân chủ đề (ví dụ hóa học, an ninh mạng) vẫn có thể hỏi theo hướng học thuật, rõ ràng mục đích.
- "Guardrail chỉ là lọc từ khóa đơn giản." Thực tế các hệ thống hiện đại kết hợp nhiều lớp: huấn luyện giá trị cốt lõi cho mô hình, bộ phân loại AI riêng, và kiểm tra ở tầng hệ thống, không chỉ chặn vài từ cấm.
- "Vượt qua được guardrail một lần nghĩa là an toàn để dùng." Một câu trả lời lọt qua kiểm duyệt không đồng nghĩa với việc nó chính xác hoặc an toàn để làm theo. Guardrail giảm rủi ro chứ không đảm bảo mọi nội dung lọt qua đều đáng tin.
 Câu hỏi thường gặp
Guardrail có giống kiểm duyệt nội dung (content moderation) không? Có liên quan nhưng không hoàn toàn giống. Kiểm duyệt nội dung thường chỉ lọc output sau khi đã sinh ra, còn guardrail bao trùm nhiều lớp hơn, từ lúc huấn luyện mô hình đến khi kiểm tra cả đầu vào lẫn đầu ra.
Vì sao đôi khi hỏi lại y hệt mà AI lại trả lời khác nhau? Vì các bộ phân loại dựa trên xác suất, không phải quy tắc cứng nhắc tuyệt đối. Cách diễn đạt câu hỏi, ngữ cảnh cuộc trò chuyện trước đó, và cả yếu tố ngẫu nhiên trong mô hình có thể khiến kết quả khác nhau một chút giữa các lần hỏi.
Có thể tắt guardrail khi dùng API không? Không thể tắt hoàn toàn các lớp an toàn cốt lõi đã huấn luyện vào mô hình. Một số nền tảng cho phép doanh nghiệp tùy chỉnh thêm quy tắc riêng cho sản phẩm của họ, nhưng vẫn nằm trong khuôn khổ chính sách sử dụng của hãng AI.
Guardrail có làm AI kém hữu ích hơn không? Có đánh đổi. Guardrail càng chặt thì càng ít rủi ro nhưng cũng dễ từ chối nhầm các câu hỏi vô hại. Các hãng AI liên tục tinh chỉnh để giảm từ chối nhầm mà vẫn giữ được mức an toàn cần thiết.
Làm agent tự động (AI agent) có cần guardrail riêng không? Có, và còn quan trọng hơn chatbot thông thường. Một AI agent là gì có thể tự gọi công cụ, chạy lệnh, truy cập dữ liệu, nên cần thêm guardrail ở tầng hệ thống để giới hạn những hành động nó được phép thực hiện, không chỉ giới hạn nội dung nó được phép nói.
Guardrail chính là lý do một hệ thống prompt (system prompt) của mỗi ứng dụng AI luôn kèm theo các quy tắc an toàn, và cũng là thứ mà kỹ thuật prompt injection cố gắng vượt qua bằng cách đánh lừa AI đọc nhầm lệnh. Nếu bạn từng thắc mắc vì sao có người tìm cách jailbreak AI để chatbot làm điều nó vốn từ chối, giờ bạn đã hiểu: đó chính là nỗ lực phá vỡ các lớp guardrail vừa nói ở trên.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ