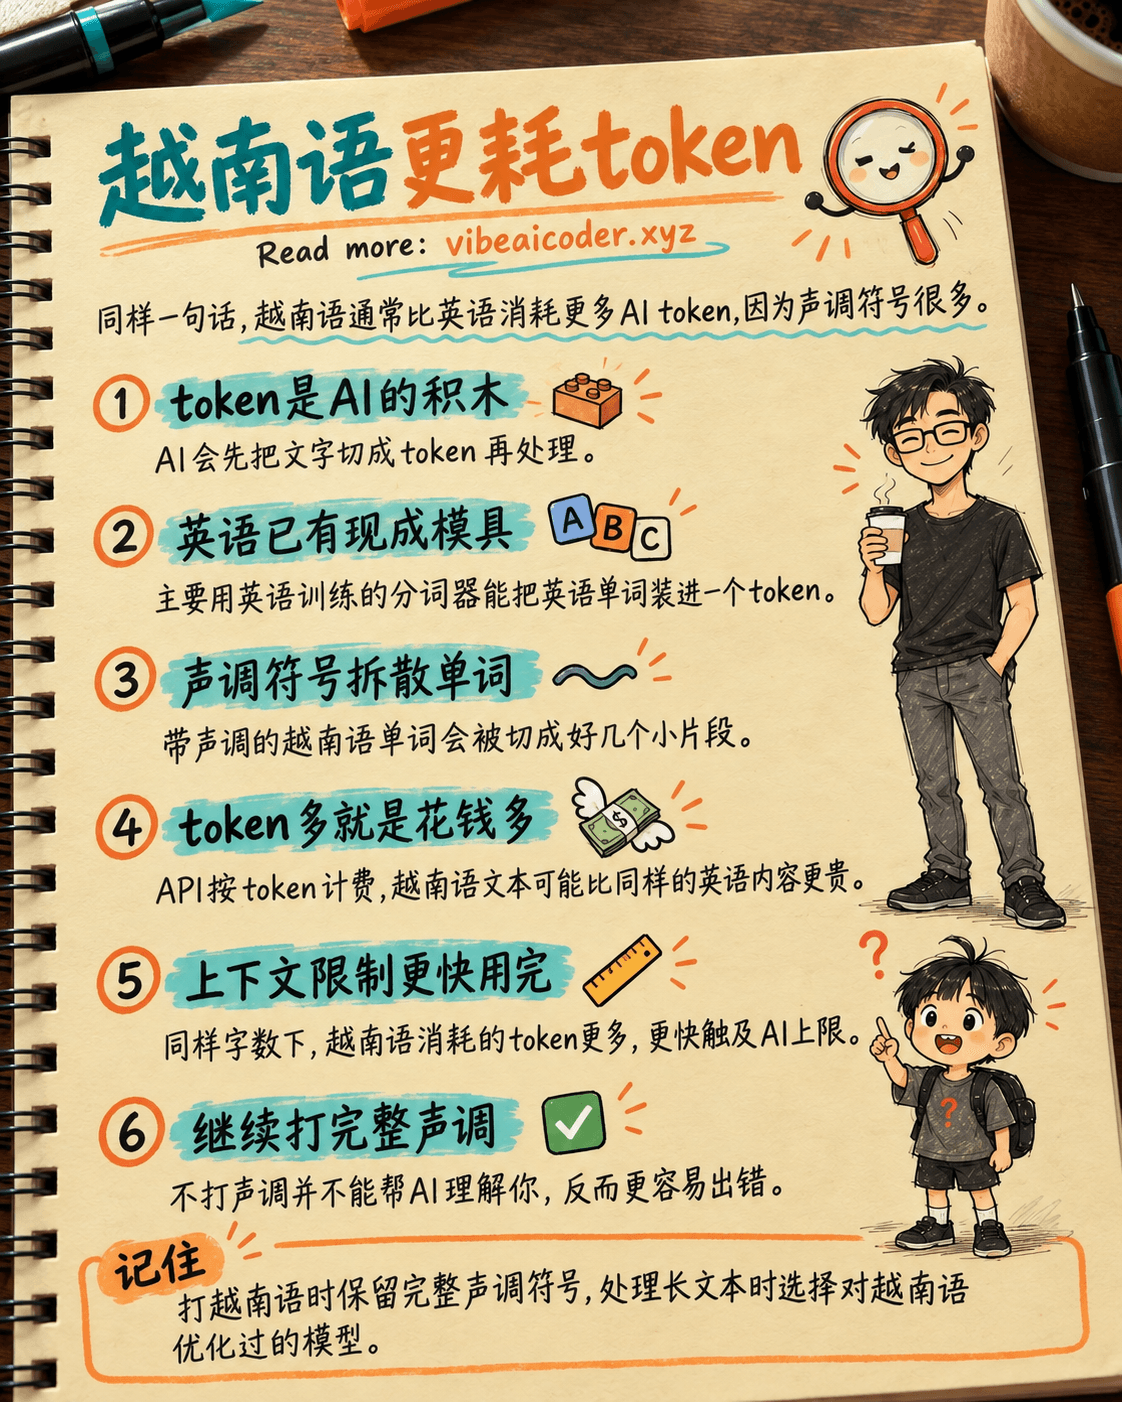
 为什么打越南语比打英语消耗更多token?
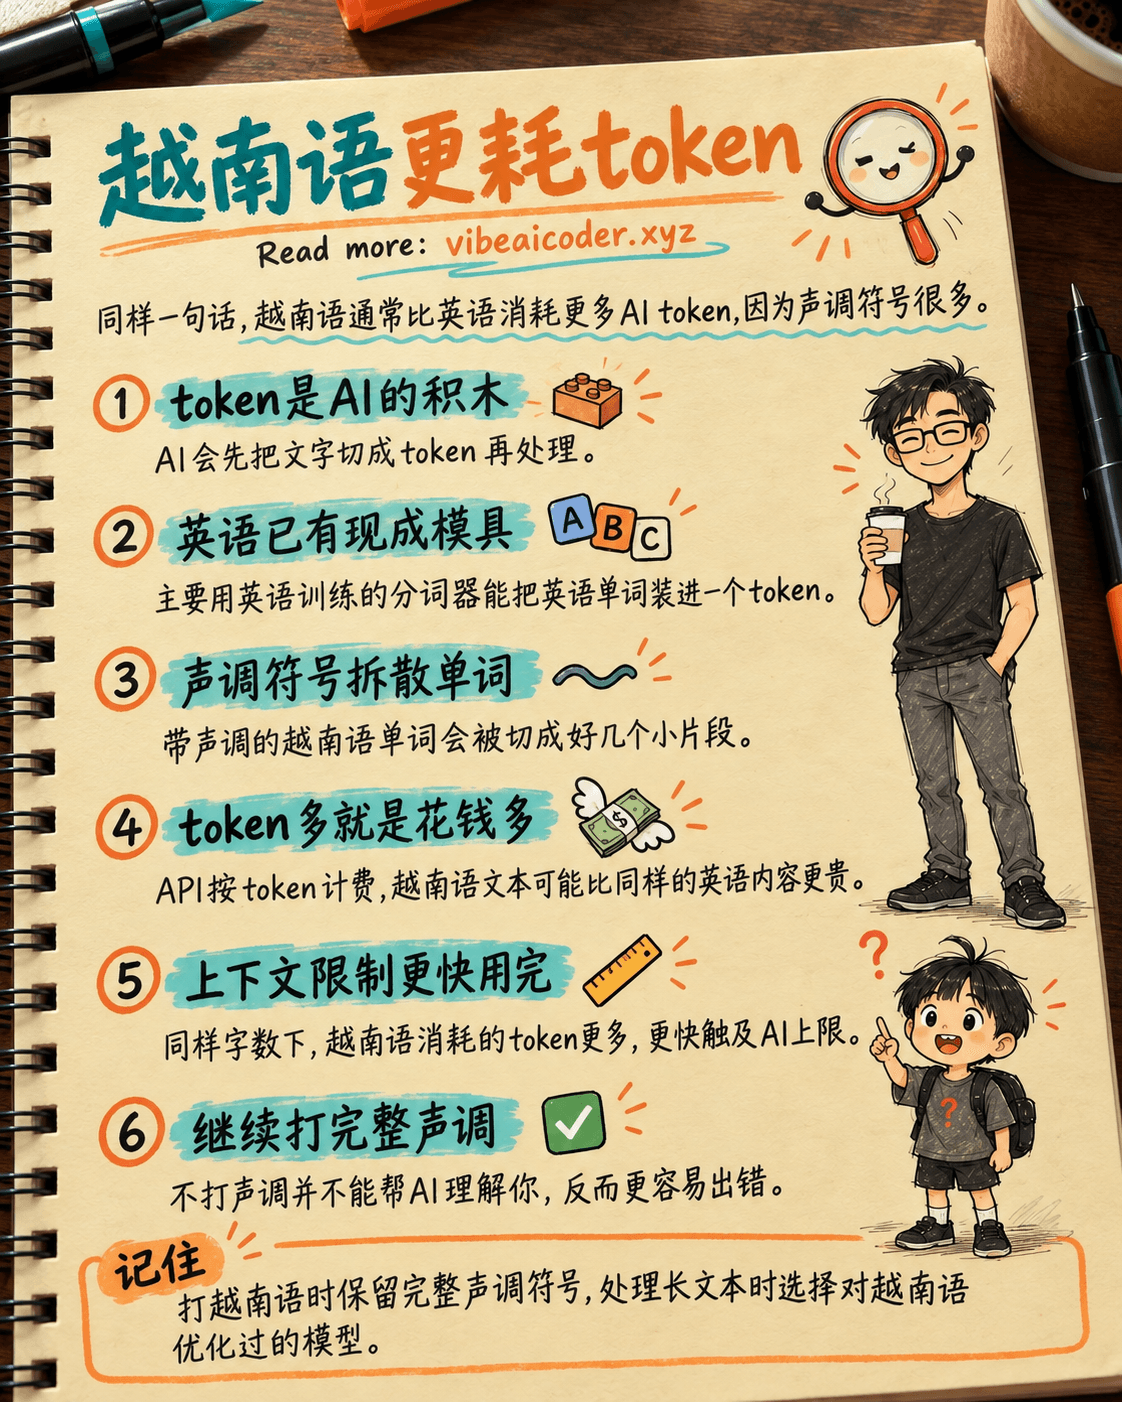
同样一句话,越南语通常会被AI切分成更多的token,有时甚至是英语的两三倍。主要原因是越南语的声调符号和元音变音符号很多,而大多数AI使用的分词器(tokenizer)主要是用英语数据训练出来的,无法把越南语单词识别成熟悉的整块,只能把它们切得更碎。了解这一点,你就会明白为什么用越南语使用AI有时候更贵、更容易撞到长度上限、回答也更容易被截断。
 用生活例子快速理解
把token想象成AI用来搭句子的乐高积木。这套积木是一家专为英语调校的工厂生产的,早就准备好了正好对应英语常见词块的积木,比如"the""ing""tion"。你给AI一个英语单词时,它通常只需要拼上一两块现成的积木就够了。
但越南语有很多这家工厂从没开过模具的形状。像"được"这个词带有锐音符和钩号,"nghiêng"则把三个元音叠在一起还带声调。因为没有现成的积木能正好对上,AI只能把这个词拆成很小的碎片,有时甚至拆到单个字母或字节,再用很多小碎片拼回一个完整的词。碎片越多,消耗的token就越多,就像用碎砖头而不是整块砖头来砌墙。
 它到底是怎么运作的
- AI读的不是字母,而是token。 在回答任何问题之前,每一个生成式AI模型都会先把你的文字切分成token,也就是被当作一个单位处理的字符片段。这一步发生在模型"思考"之前。
- token词表是从训练数据中学出来的。 各大AI公司用一种叫BPE(字节对编码)的算法训练分词器。这个算法会扫描海量文本,把反复出现的字符序列合并成一个独立的token。由于大部分训练数据是英语(部分模型还有大量中文),常见的英语片段很早就被合并成整词token。
- 越南语的带调变体太多,根本合并不完。 越南语是一种有声调的孤立语:光是"ma"这个音节,根据声调不同就有六个意思不同的词,"ma, má, mà, mả, mã, mạ"。每一种元音加声调的组合,在Unicode里都是不同的字符序列。要让分词器为所有组合都准备好足够的"积木",就需要一个专门为越南语打造的巨大词表,但大多数主流模型并没有留出这么多空间。
- 结果就是越南语单词被切得七零八落。 根据近期的测量,与英语相比,GPT-2或RoBERTa风格的分词器处理同样一段越南语文字时,所需token数可能是英语的四倍以上,而更现代的多语言分词器根据模型不同,也仍然要多花大约1.4到接近2倍的token。这种差距有时被戏称为小语种使用者要缴的"token税"。
- 专门为越南语训练的模型表现好得多。 像PhoBERT那样专门为越南语打造的分词器,token数量能接近英语水平,因为它们从一开始就学习了越南语真实的音节和声调结构,而不是硬把越南语塞进为其他语言设计的词表里。
 这对你意味着什么
- 用越南语写作时,同样的内容用AI可能比英语更贵。 因为API套餐是按token计费的,一段200个越南语单词的文字,换算成token可能相当于一段400到600个单词的英语文字。如果你正在搭建一个用AI大量处理越南语文本的服务,比如客服聊天机器人或文档摘要工具,预算成本时请按越南语的实际token消耗来算,不要套用英语的公式。
- 用越南语时,上下文窗口会更快被占满。 假设一个AI模型的上限是32000个token,同样篇幅的越南语文档会比英语文档更快触顶。如果你粘贴一段长文时AI提示"超出限制",要记得部分原因可能是越南语本来就更"吃"token,而不是你的文档真的太长。
- 一个实用小技巧: 如果你需要AI一次性处理很长的越南语文本,比如粘贴整份合同来做摘要,可以试试那些宣传对越南语或亚洲语言做过优化的模型。它们通常对声调符号用了更高效的分词器,能让你在同样的token限制内塞进更多内容。
 常见误解
- "一个token就是一个词。" 不对。token可能是一个完整的词,也可能是词的一部分,甚至只是几个字符。对越南语来说,一个带声调的单词常常被拆成两三个token,而不是一个。
- "所有AI在越南语上浪费的token都一样多。" 也不对。差距取决于每家公司的分词器:有的模型只比英语多花大约1.4倍的token,有的老模型却要多花四倍。用更多越南语数据训练、分词器设计更合理的模型,浪费的token通常更少。
- "打字不带声调能省token。" 从技术上说这部分是对的,因为不带声调的文字更接近英语字母,但你不应该这样做:AI会更难准确理解你的意思,因为很多不带声调的词会互相混淆。vibeaicoder.xyz的每一篇文章都建议打越南语时保留完整的声调符号,这样AI才能理解正确并给出正确的回答。
 常见问题
越南语比英语多消耗多少倍的token? 没有一个适用于所有AI的固定数字。根据模型和分词器不同,相比句子长度相近的英语文字,差距大约在1.4倍到4倍以上之间。
为什么不是每家AI公司都解决了这个问题? 因为给一种语言重新打造分词器,几乎需要把整个模型从头重新训练一遍,非常耗时又耗费成本,所以各家公司通常只能在每次发布新模型版本时逐步改善。
这会影响回答的智能程度吗? 不会直接影响。更多的token主要影响的是成本,以及你一次能发送或接收的文字长度上限,只要模型训练时用了足够高质量的越南语数据,并不会让它理解越南语的能力变差。
怎么知道一段越南语文字会消耗多少token? 一些AI公司的官网提供针对自家模型的在线token计数工具,你可以把一段越南语和对应的英语文字都粘贴进去,直接做对比。
为了省钱,应该避免用越南语使用AI吗? 对普通用户来说没有必要。这个差异对正在搭建大量通过API处理越南语文本的服务的人更重要;如果你只是日常聊天或让AI帮忙写东西,照常打带完整声调的越南语就好,这样才能让AI最准确地理解你。
想更深入了解AI是怎么按token计费的,可以阅读AI的套餐、API和输入输出token是怎么计价的。如果你还不清楚AI是怎么靠token"预测下一个字"的,什么是大语言模型(LLM)这篇文章会先帮你打好基础。一个模型能不能处理好越南语,也和它的训练数据有关,你可以在AI的开源与闭源模型这篇里做进一步比较。如果你想学会怎么写出AI能准确理解的越南语提示词,可以看看什么是提示词、如何写出有效的提示词这篇指南。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制