 Vì sao gõ tiếng Việt tốn nhiều token hơn tiếng Anh?
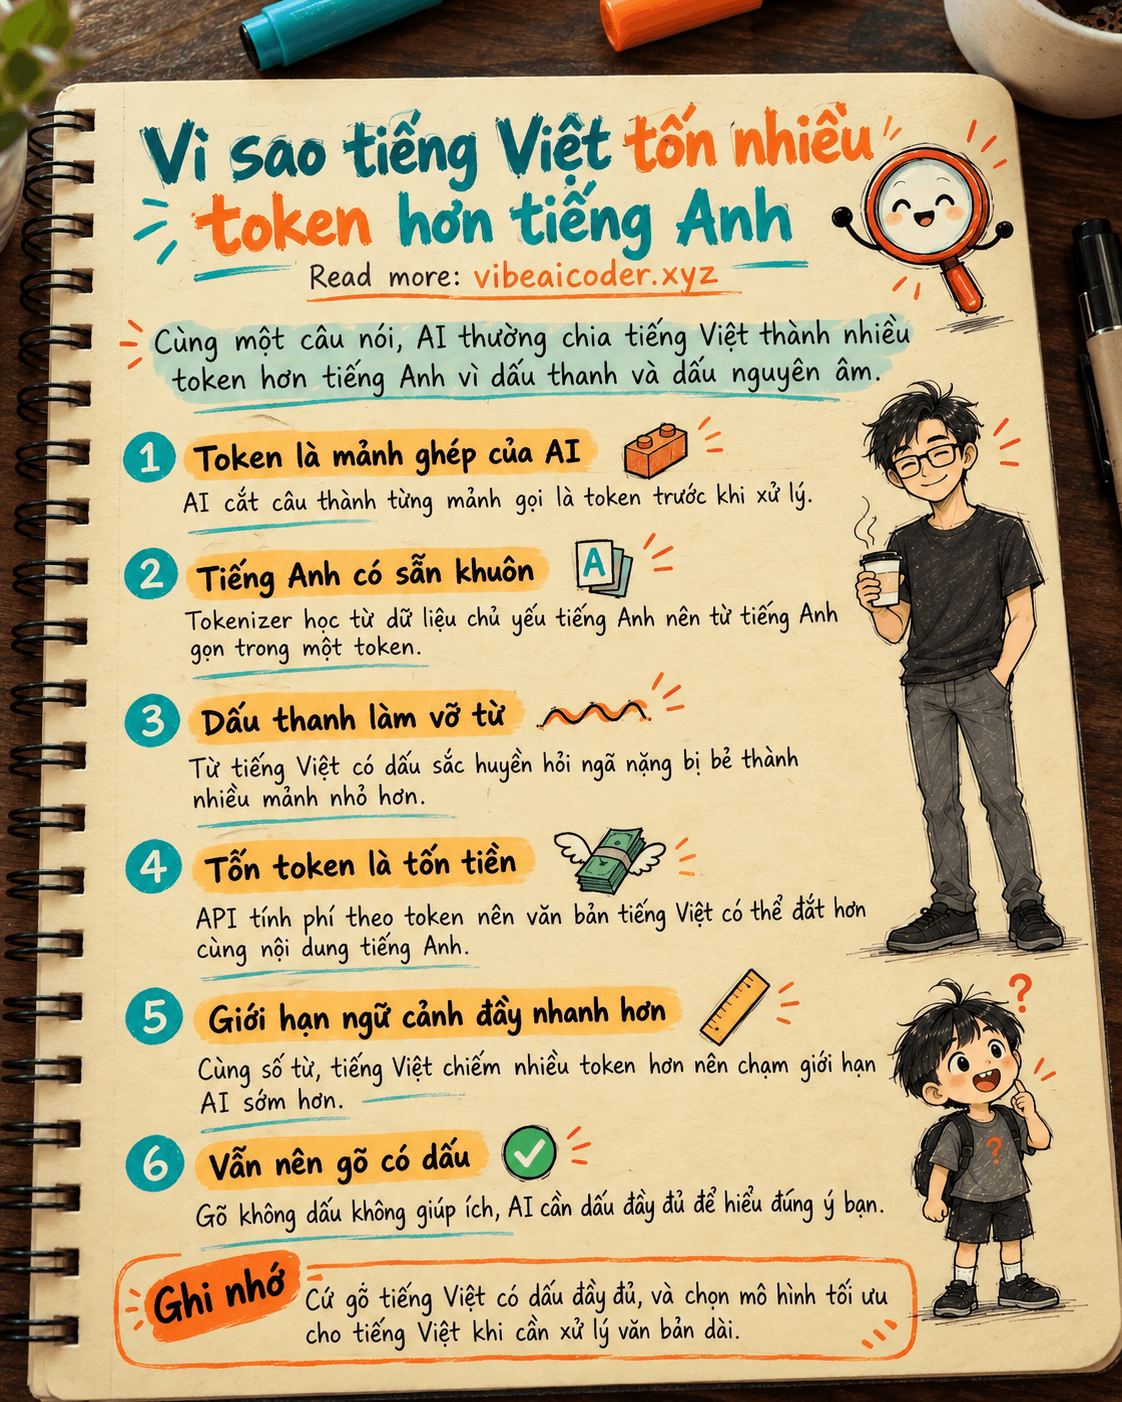
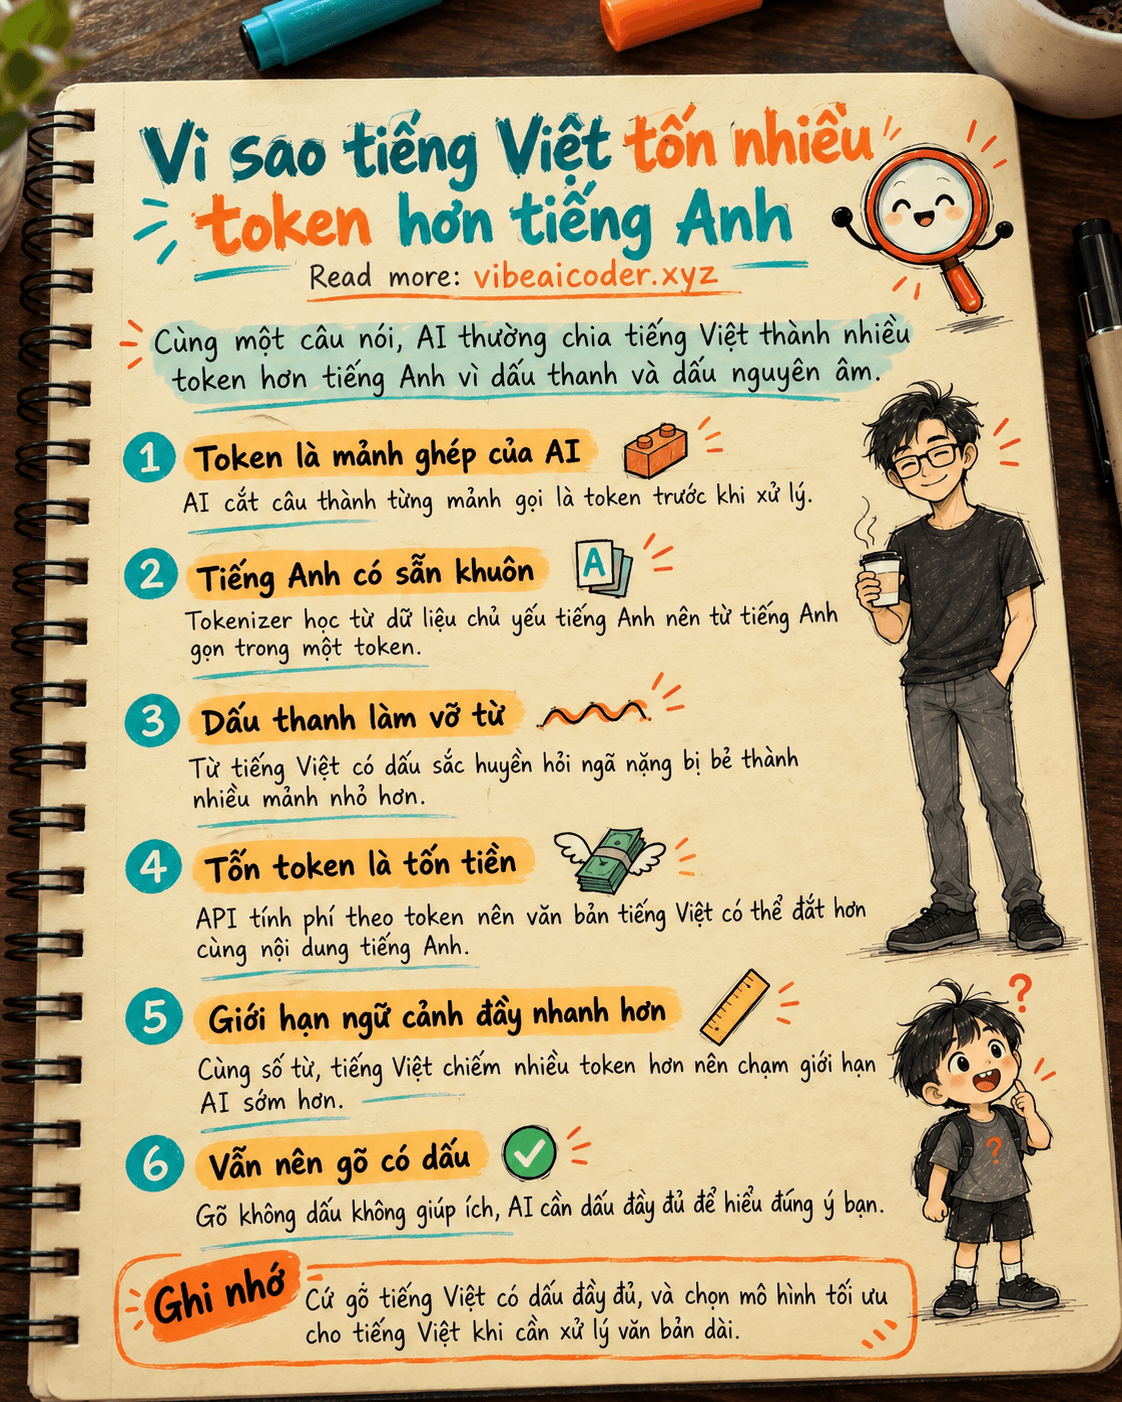
Cùng một câu nói, tiếng Việt thường bị AI "chia nhỏ" thành nhiều token hơn tiếng Anh, có khi gấp hai, ba lần. Nguyên nhân chính là dấu thanh và dấu nguyên âm của tiếng Việt khiến bộ tách từ (tokenizer) của hầu hết các AI, vốn được huấn luyện chủ yếu trên tiếng Anh, không nhận ra chữ tiếng Việt là một khối quen thuộc nên phải cắt vụn ra. Hiểu điều này giúp bạn biết vì sao dùng AI bằng tiếng Việt đôi khi đắt hơn, chậm hơn và dễ bị cắt cụt câu trả lời hơn tiếng Anh.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng token giống như những viên gạch Lego mà AI dùng để xếp thành câu. Bộ gạch Lego đó được một nhà máy ở Mỹ sản xuất, đo ni đóng giày cho tiếng Anh: họ có sẵn những viên gạch to vừa đúng hình các từ tiếng Anh thông dụng như "the", "ing", "tion". Khi bạn đưa một từ tiếng Anh vào, AI chỉ cần ghép một hoặc hai viên gạch có sẵn là xong.
Nhưng tiếng Việt lại có nhiều "hình dạng" mà nhà máy đó chưa từng làm khuôn: một từ như "được" mang dấu sắc và dấu móc, "nghiêng" có tới ba nguyên âm ghép dấu. Vì không có viên gạch nào vừa khớp, AI buộc phải bẻ từ đó ra thành những mảnh rất nhỏ, có khi từng chữ cái hoặc từng byte một, rồi ghép lại nhiều viên gạch nhỏ mới ra được một từ. Càng nhiều mảnh ghép, càng tốn nhiều token, giống như xây một bức tường bằng gạch vụn thay vì gạch nguyên khối.
 Nó hoạt động thế nào
- AI không đọc chữ cái, nó đọc token. Trước khi trả lời, mọi AI tạo sinh đều cắt câu của bạn thành các token, tức các cụm ký tự được xem là một đơn vị. Đây là bước bắt buộc, xảy ra trước cả khi AI "suy nghĩ".
- Bộ từ điển token (vocabulary) được học từ dữ liệu huấn luyện. Các hãng AI lớn huấn luyện tokenizer bằng một thuật toán gọi là BPE (ghép cặp byte xuất hiện nhiều lần). Thuật toán này nhìn vào hàng tỉ trang văn bản, thấy cụm ký tự nào lặp lại nhiều thì gộp thành một token riêng. Vì phần lớn dữ liệu huấn luyện là tiếng Anh (và tiếng Trung với một số mô hình), các cụm ký tự tiếng Anh thông dụng được gộp thành token nguyên từ rất sớm.
- Tiếng Việt có quá nhiều biến thể dấu để gộp hết. Tiếng Việt là ngôn ngữ đơn lập có thanh điệu: chỉ riêng chữ "ma" đã có sáu từ khác nghĩa là "ma, má, mà, mả, mã, mạ" tùy dấu. Mỗi tổ hợp nguyên âm cộng dấu lại là một chuỗi ký tự Unicode khác nhau. Để tokenizer có đủ "viên gạch" cho tất cả tổ hợp đó, nó cần một bộ từ điển khổng lồ dành riêng cho tiếng Việt, nhưng hầu hết mô hình phổ biến không dành đủ chỗ cho việc đó.
- Kết quả: từ tiếng Việt bị bẻ nhỏ. Theo các nghiên cứu đo lường gần đây, so với tiếng Anh, tokenizer kiểu GPT-2 hoặc RoBERTa có thể cần tới hơn bốn lần số token cho cùng một đoạn tiếng Việt, còn những tokenizer đa ngôn ngữ hiện đại hơn vẫn tốn thêm khoảng 1,4 đến gần 2 lần tùy mô hình. Mức độ "lỗ" này gọi vui là "thuế token" mà người dùng ngôn ngữ ít phổ biến phải trả.
- Mô hình được huấn luyện riêng cho tiếng Việt thì đỡ hơn hẳn. Những tokenizer xây riêng cho tiếng Việt, ví dụ như kiểu PhoBERT, đạt số token gần ngang bằng tiếng Anh vì chúng học đúng cấu trúc âm tiết và dấu của tiếng Việt ngay từ đầu, thay vì cố nhét tiếng Việt vào một bộ từ điển vốn dựng cho ngôn ngữ khác.
 Điều này có ý nghĩa gì với bạn
- Viết tiếng Việt với AI có thể tốn tiền hơn tiếng Anh cho cùng một nội dung. Vì các gói API tính phí theo token, một đoạn văn tiếng Việt dài 200 từ có thể quy đổi thành số token tương đương một đoạn tiếng Anh 400 đến 600 từ. Nếu bạn đang xây dịch vụ dùng AI xử lý văn bản tiếng Việt số lượng lớn (chatbot chăm sóc khách hàng, tóm tắt tài liệu), hãy tính dự trù chi phí theo token tiếng Việt thực tế, không áp công thức của tiếng Anh.
- Cửa sổ ngữ cảnh "đầy" nhanh hơn khi bạn dùng tiếng Việt. Nếu AI có giới hạn ví dụ 32.000 token, một tài liệu tiếng Việt sẽ chiếm giới hạn đó nhanh hơn tài liệu tiếng Anh cùng độ dài câu chữ. Khi dán một văn bản dài vào, nếu AI báo lỗi "quá giới hạn", hãy nhớ nguyên nhân có thể một phần do tiếng Việt vốn "nặng token" hơn, không phải tài liệu của bạn thực sự quá dài.
- Một mẹo thực tế: nếu bạn cần AI xử lý văn bản tiếng Việt thật dài trong một lần (ví dụ dán cả hợp đồng để tóm tắt), hãy thử chọn mô hình được quảng cáo có tối ưu tốt cho tiếng Việt hoặc ngôn ngữ châu Á, vì chúng thường dùng tokenizer hiệu quả hơn cho dấu thanh, giúp bạn nhét được nhiều nội dung hơn trong cùng giới hạn token.
 Hiểu lầm thường gặp
- "Token là một từ." Sai. Token có thể là một từ nguyên, một mảnh của từ, hoặc chỉ vài ký tự. Với tiếng Việt, một từ có dấu thường bị cắt thành hai, ba token thay vì một.
- "Mọi AI đều tốn token tiếng Việt như nhau." Không đúng. Mức chênh lệch phụ thuộc vào tokenizer của từng hãng: có mô hình chỉ tốn thêm khoảng 1,4 lần so với tiếng Anh, có mô hình cũ tốn gấp bốn lần. Mô hình nào huấn luyện với nhiều dữ liệu tiếng Việt và tokenizer được thiết kế tốt hơn thường đỡ "hao" token hơn.
- "Gõ không dấu sẽ tiết kiệm token." Về mặt kỹ thuật có thể đúng một phần vì chữ không dấu gần với bảng chữ cái tiếng Anh hơn, nhưng bạn không nên làm vậy: AI sẽ khó hiểu chính xác ý bạn hơn (nhiều từ không dấu trùng nhau), và mọi bài trên vibeaicoder.xyz luôn khuyên gõ tiếng Việt có dấu đầy đủ để AI hiểu đúng và trả lời đúng.
 Câu hỏi thường gặp
Tiếng Việt tốn token gấp bao nhiêu lần tiếng Anh? Không có một con số cố định cho mọi AI. Tùy mô hình và tokenizer, mức chênh lệch dao động từ khoảng 1,4 lần đến hơn 4 lần so với một đoạn tiếng Anh có cùng độ dài câu chữ.
Vì sao không phải AI nào cũng cải thiện việc này? Vì xây lại tokenizer cho một ngôn ngữ cần huấn luyện lại gần như toàn bộ mô hình từ đầu, rất tốn thời gian và chi phí, nên các hãng thường chỉ cải thiện dần qua từng phiên bản mô hình mới.
Điều này có ảnh hưởng đến độ thông minh của câu trả lời không? Không trực tiếp. Số token nhiều hơn chủ yếu ảnh hưởng đến chi phí và giới hạn độ dài bạn có thể gửi hoặc nhận trong một lần, không làm AI "kém hiểu" tiếng Việt hơn nếu nó đã được huấn luyện đủ dữ liệu tiếng Việt chất lượng.
Làm sao biết một đoạn tiếng Việt tốn bao nhiêu token? Một số trang web của các hãng AI có công cụ đếm token trực tuyến cho mô hình của họ; bạn có thể dán thử đoạn tiếng Việt và đoạn tiếng Anh tương đương để so sánh trực tiếp.
Có nên tránh dùng tiếng Việt khi làm việc với AI để tiết kiệm chi phí không? Không cần thiết với người dùng thông thường. Khác biệt này quan trọng hơn với người xây dịch vụ xử lý lượng lớn văn bản tiếng Việt qua API; còn khi bạn chỉ trò chuyện hoặc nhờ AI viết, soạn thảo hằng ngày, hãy cứ gõ tiếng Việt có dấu bình thường để được hiểu đúng nhất.
Muốn hiểu sâu hơn cách AI tính phí theo token, bạn có thể đọc thêm giá AI tính thế nào qua gói tháng, API và token vào ra. Nếu chưa rõ cơ chế AI "đoán chữ tiếp theo" dựa trên token như thế nào, bài mô hình ngôn ngữ lớn (LLM) là gì sẽ giúp bạn có nền tảng trước. Việc một mô hình xử lý tiếng Việt tốt hay không cũng liên quan đến dữ liệu huấn luyện của nó, bạn có thể so sánh thêm ở bài mã nguồn mở và mã nguồn đóng trong AI. Và nếu bạn đang học cách viết prompt tiếng Việt sao cho AI hiểu đúng ý, hãy xem hướng dẫn prompt là gì, cách viết prompt hiệu quả.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 Dữ liệu tổng hợp (synthetic data) là gì? AI có thể tự tạo dữ liệu để dạy chính nó không