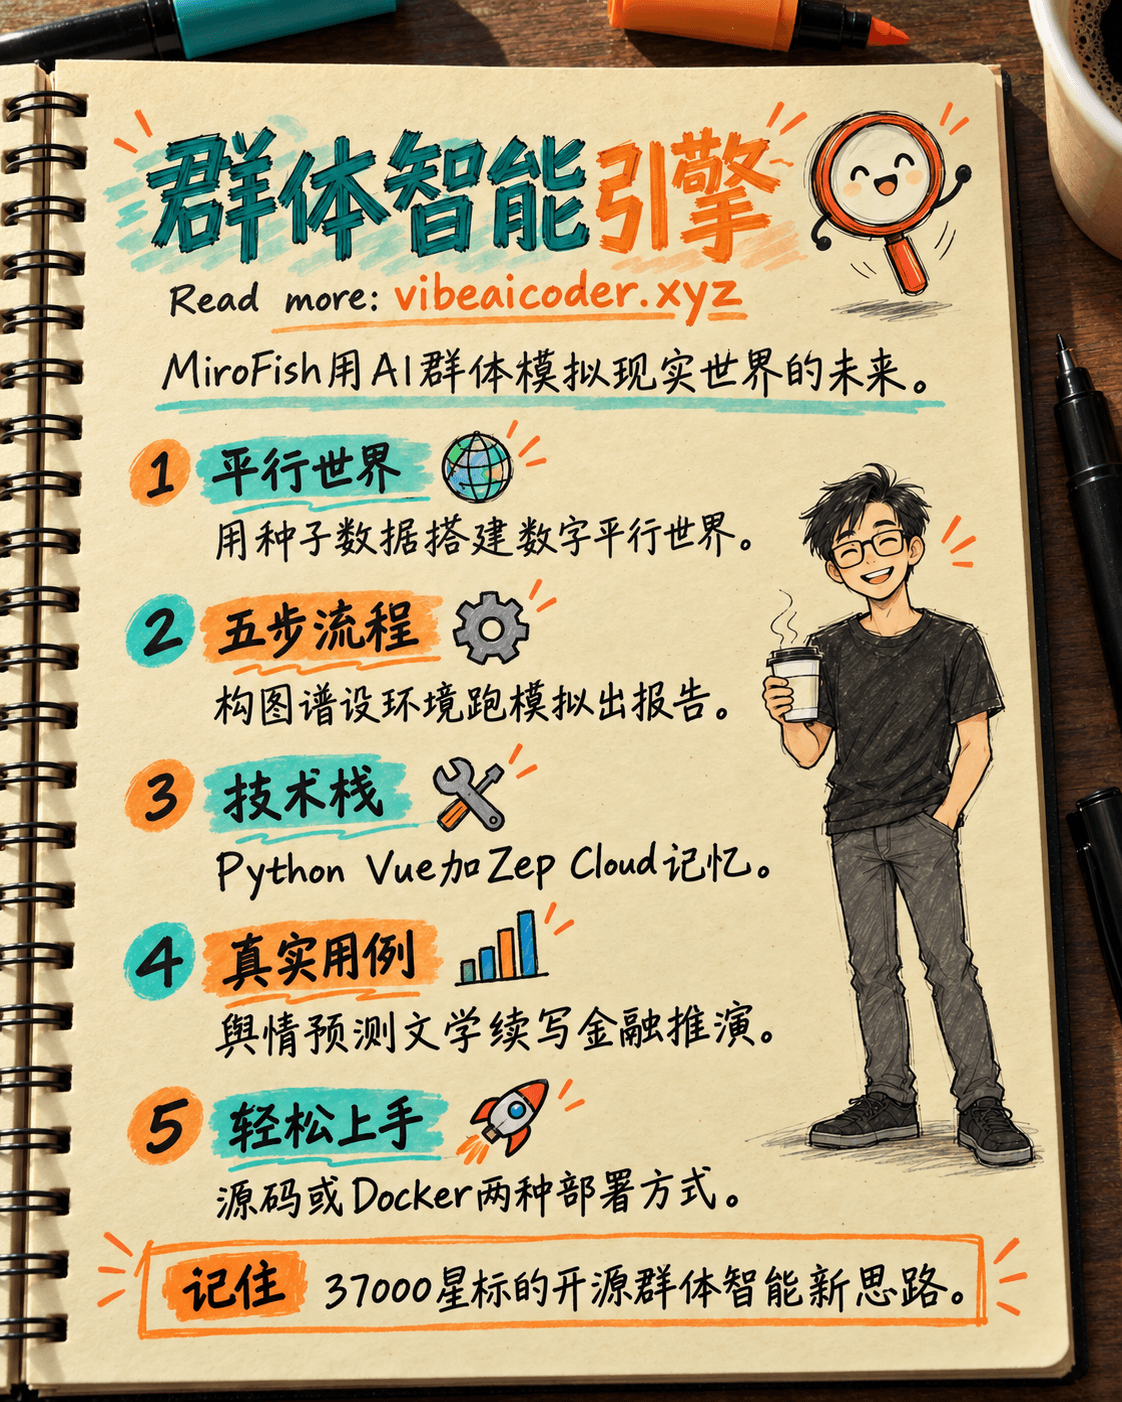
MiroFish:开源群体智能引擎,GitHub 37000+星标
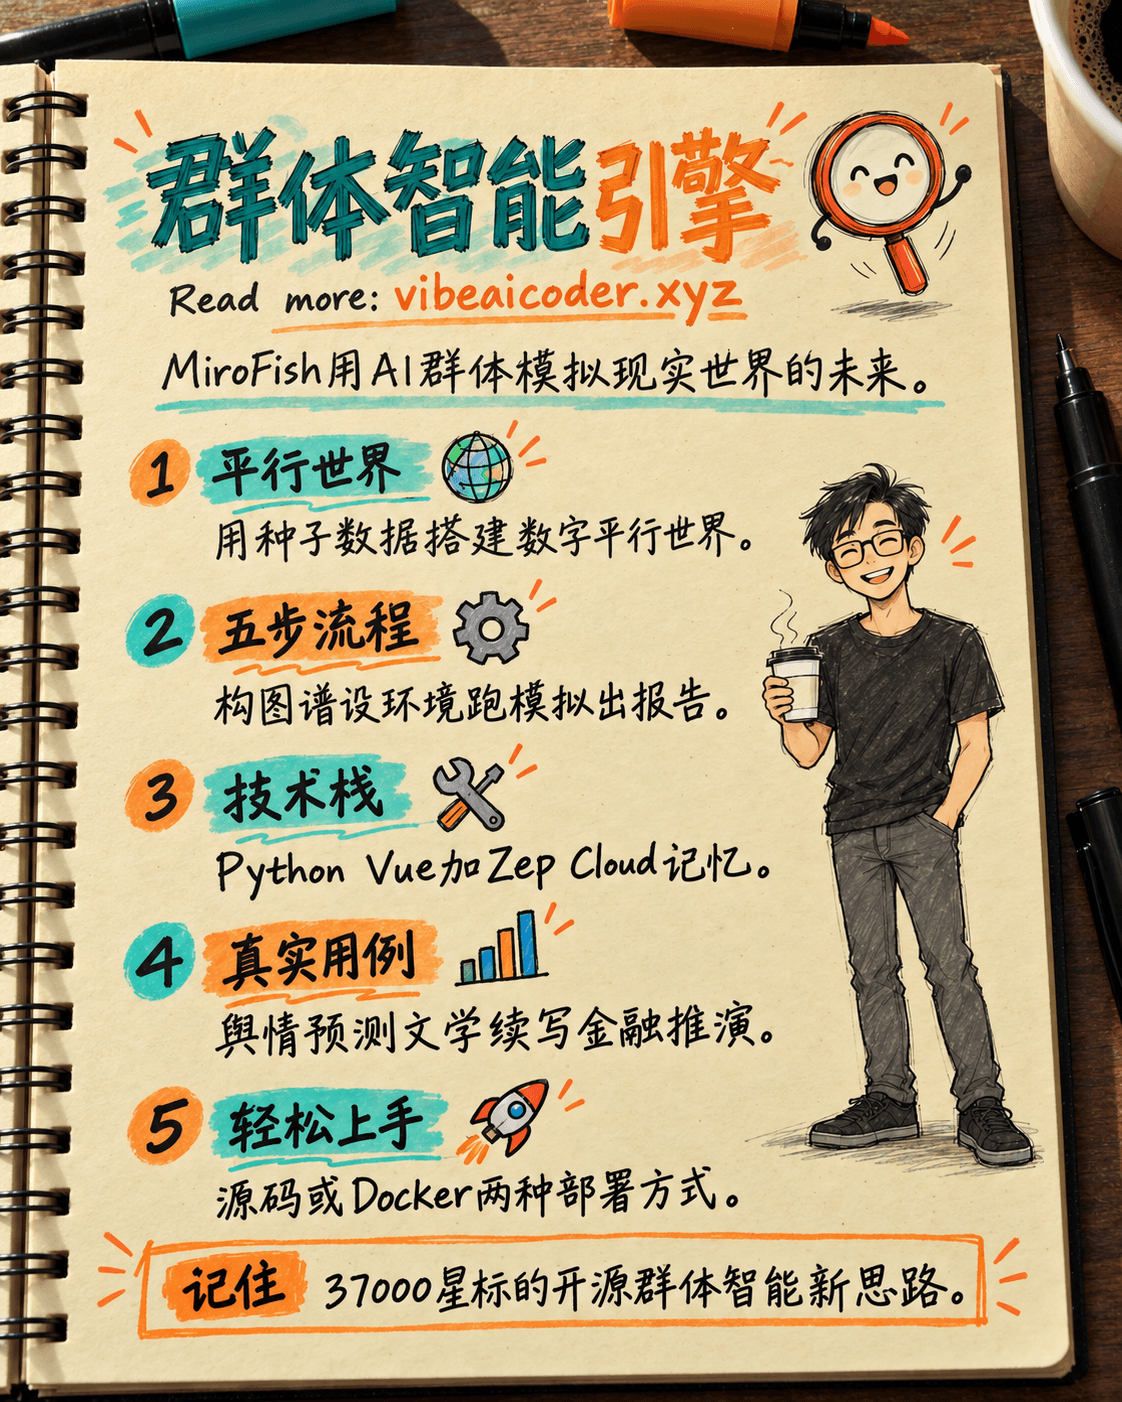
GitHub 上有一个很受关注的开源项目,名叫 MiroFish,官方定义是一款多用途的群体智能引擎(Swarm Intelligence Engine),专门用来模拟和预测现实世界中可能发生的情景。这个项目已经拿下超过 37000 个星标,说明它在数据分析和趋势预测方面的潜力得到了很多开发者的认可。
项目地址: https://github.com/666ghj/MiroFish
下面从几个角度详细拆解一下 MiroFish 到底是怎么回事。
 设计理念:造一个"平行数字世界"
MiroFish 不是一个普通的聊天机器人,它的核心思路是构建一个平行数字世界(Parallel Digital World)。
系统会从"种子"数据,比如新闻、财报或者虚构故事里提取信息,然后用这些信息搭出一个模拟环境。在这个环境里,成千上万个拥有独立性格、长期记忆和行为逻辑的**Agent(智能体)**会彼此互动。
设计这套机制的目的,是让使用者能以"上帝视角(God View)"去观察事件如何演变,再根据这些智能体之间自发产生的互动,推演出未来可能的走向。
 运行流程:五个步骤跑完一次模拟
MiroFish 的完整工作流分成五步:
- 构建知识图谱(Graph Construction):提取真实世界的信息,搭建一套 GraphRAG(基于知识图谱的检索增强生成)系统,为虚拟世界打好知识底座。
- 设置环境:确定各个实体、它们之间的关系,并为每个 Agent 生成专属的"人设"(Persona)。
- 运行模拟(Simulation):在多个平台上同时跑交互模拟,Agent 会自动处理信息,并实时更新自己的记忆。
- 生成报告:一个专门的 ReportAgent 会汇总整场模拟的结果,写出详细报告。
- 深度互动:用户可以直接和模拟世界里的任意一个 Agent 对话,了解它行为背后的动机。
 技术栈:用什么搭起来的
项目建立在几套比较主流的技术之上:
- 编程语言:后端用 Python,前端用 Vue。
- 记忆管理:依靠 Zep Cloud 维持 Agent 的长期记忆,避免模拟时间一长就"忘事"、丢失上下文。
- 大模型支持:兼容所有支持 OpenAI SDK 的 LLM,官方推荐用 Qwen-plus 或其他推理能力较强的模型。
- 模拟引擎:底层由 OASIS 驱动,这是 CAMEL-AI 团队的一项贡献。
 实际用例:已经跑通的几种场景
MiroFish 已经在多个真实场景里验证过能力:
- 舆情传播预测:模拟一次突发公共事件的舆论扩散路径(例如武汉大学相关事件的模拟案例)。
- 文学创作:输入《红楼梦》前 80 回的内容,根据人物性格去推测已经遗失的后续章节可能的走向。
- 金融与政策推演:预测市场面对新的财经信号或政策草案时可能出现的反应。
 怎么自己跑起来
想亲自试一试 MiroFish,官方给了两条路:
- 源码部署:需要 Node.js 18 以上和 Python 3.11 以上,用
uv这个包管理工具来提升后端安装效率。 - Docker 部署:不用手动配置每个组件,是启动模拟环境最快的方式。
有一点要提前知道:因为要同时模拟成千上万个 Agent 持续互动,这个项目对 API 资源(也就是大模型的 Token)消耗不小。建议先从小规模模拟开始,控制在 40 轮以内,这样比较好控制成本。
MiroFish 代表了用 AI 理解**群体智能(Collective Intelligence)**的一种新思路,也让人看到数字社会里群体行为自发涌现的可能性。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制