MiroFishとは:群知能エンジンの仕組みとGitHub37000スター超えの理由
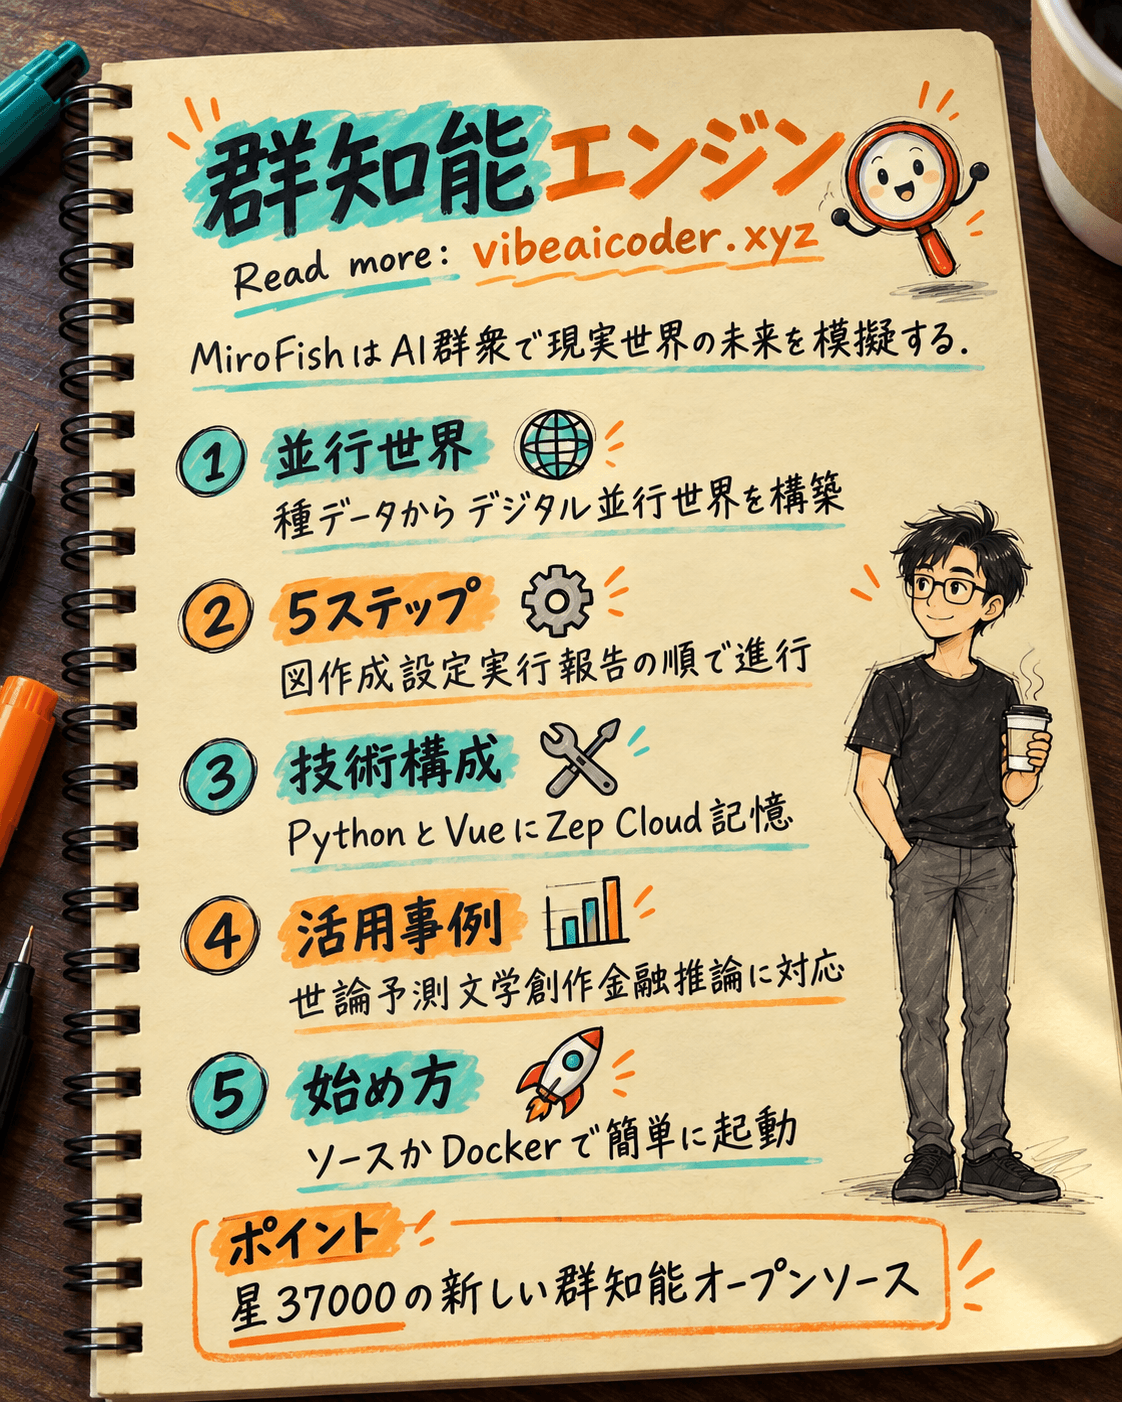
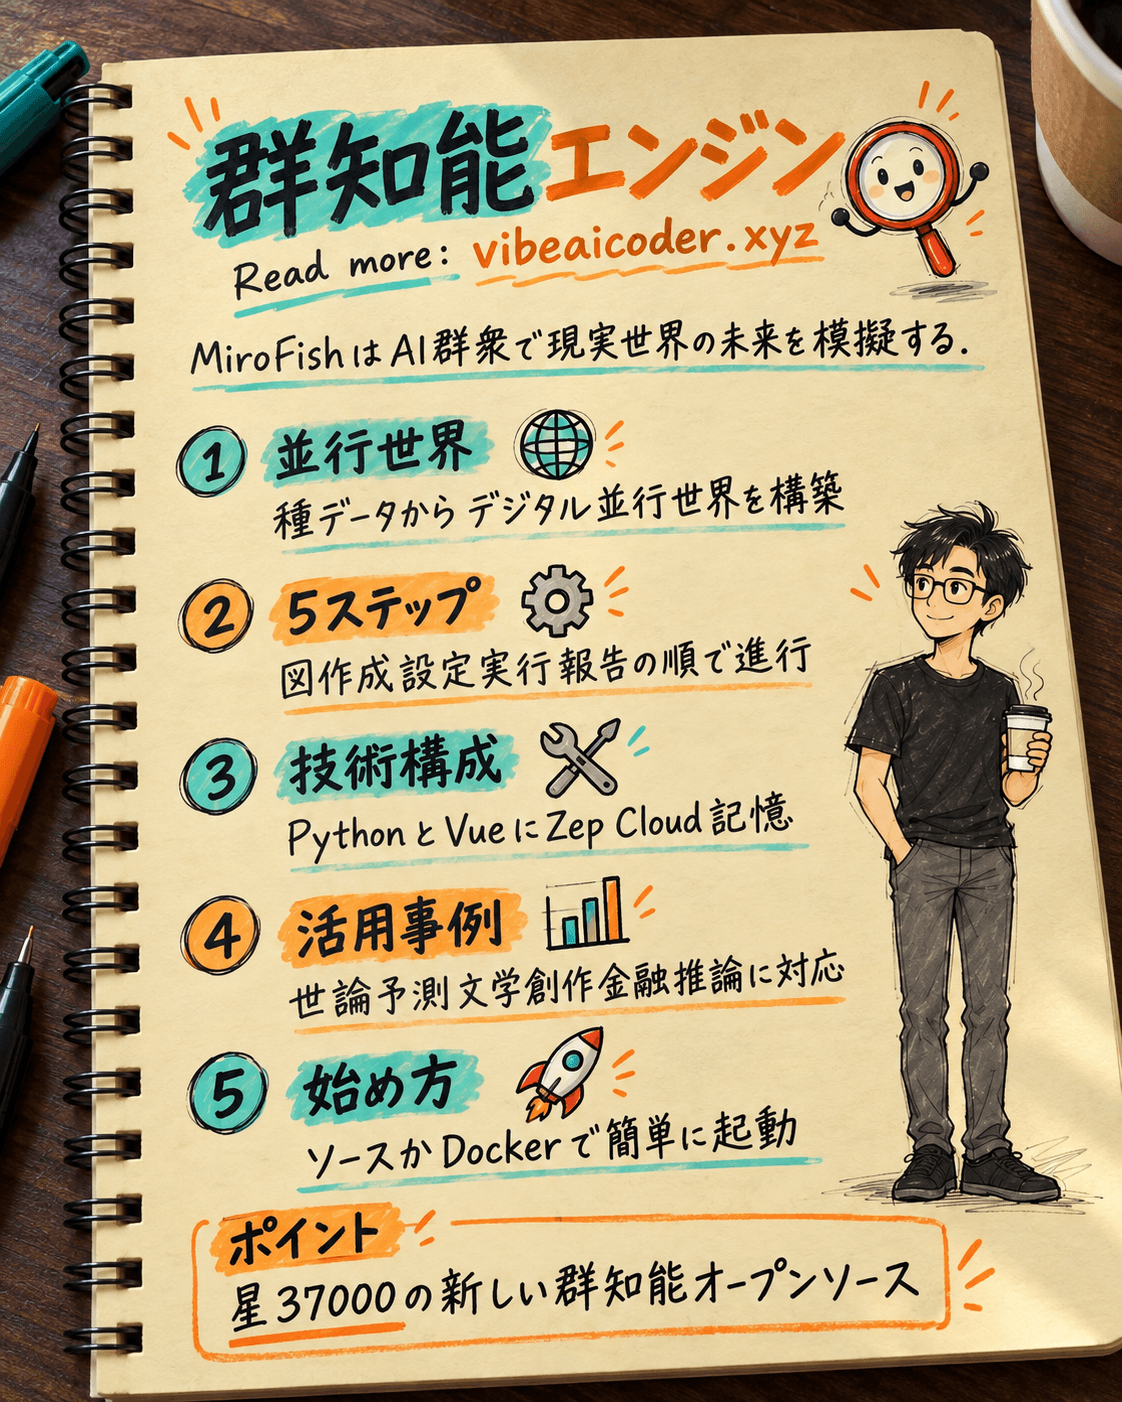
GitHub で注目を集めているオープンソースプロジェクトに MiroFish がある。公式には汎用的な**群知能エンジン(Swarm Intelligence Engine)**と位置づけられており、現実世界で起こりうるシナリオをシミュレーションし予測するためのツールだ。すでに37000以上のスターを獲得しており、データ分析やトレンド予測の分野で高い期待を集めていることがうかがえる。
プロジェクトのリンク: https://github.com/666ghj/MiroFish
ここでは MiroFish の仕組みをいくつかの観点から詳しく見ていく。
 設計思想:もう一つの「並行デジタル世界」を作る
MiroFish は単なるチャットボットではない。中心にあるのは**並行デジタル世界(Parallel Digital World)**を作り出すという発想だ。
ニュース、財務報告、あるいは架空の物語といった「種」となるデータから情報を抽出し、それをもとにシミュレーション環境を構築する。その環境の中では、独自の性格、長期記憶、行動ロジックを持つ数千体もの**エージェント(Agent)**が互いにやり取りを行う。
このメカニズムの狙いは、ユーザーが「神の視点(God View)」から出来事の展開を観察できるようにし、エージェント同士の自発的な相互作用から未来の予測を導き出すことにある。
 ワークフロー:5つのステップで動くシミュレーション
MiroFish は次の5つのステップで動作する。
- 知識グラフの構築(Graph Construction): 現実の情報を抽出し、ナレッジグラフに基づく検索拡張生成の仕組みである GraphRAG を構築して、仮想世界の知識基盤を作る。
- 環境のセットアップ: エンティティとその関係性を定義し、各エージェントに「ペルソナ(Persona)」を割り当てる。
- シミュレーションの実行: 複数のプラットフォームをまたいだ相互作用シミュレーションを実行し、エージェントは情報をリアルタイムで処理しながら記憶を更新していく。
- レポート生成: 専用の ReportAgent がシミュレーション結果をまとめ、詳細なレポートを作成する。
- 深い対話: ユーザーはシミュレーション世界の中の任意のエージェントと直接対話し、その行動の背景にある動機を理解できる。
 技術スタック:何で作られているか
プロジェクトは現代的な技術の上に構築されている。
- プログラミング言語: バックエンドは Python、フロントエンドは Vue。
- メモリ管理: Zep Cloud を使ってエージェントの長期記憶を維持し、シミュレーションが長時間続いても文脈を見失わないようにしている。
- 言語モデル(LLM): OpenAI SDK 互換のあらゆる LLM に対応しており、推論性能の高い Qwen-plus などのモデルが推奨されている。
- シミュレーションエンジン: CAMEL-AI チームによる成果物である OASIS が基盤になっている。
 実際の活用例
MiroFish はすでにいくつかの現実的なシナリオで能力を実証している。
- 世論拡散の予測: ある突発的な出来事に対する世論の広がり方をシミュレーションする(武漢大学に関連する事例など)。
- 文学作品の創作: 「紅楼夢」の前半80回分のデータを読み込ませ、登場人物の性格をもとに失われた後半部分の展開を予測する。
- 金融・政策の推論: 新しい財務シグナルや政策案に対して市場がどう反応するかを予測する。
 自分で試してみるには
MiroFish を実際に動かしてみたい場合、公式が用意している方法は2つある。
- ソースコードからのデプロイ: Node.js 18以上と Python 3.11以上が必要。パッケージマネージャー
uvを使うことでバックエンドのインストール効率を高められる。 - Docker を使う方法: 各コンポーネントを個別に設定する必要がなく、シミュレーション環境を最も早く立ち上げられる。
注意点として、数千体のエージェントが絶え間なく相互作用し続けるため、API リソース(LLM のトークン)の消費量はかなり多い。コストを管理するために、まずは40ラウンド以下の小規模なシミュレーションから始めるのがおすすめだ。
MiroFish は、AI を使って**集合知(Collective Intelligence)**を理解し、デジタル社会における群知能的な振る舞いの出現を観察するための新しいアプローチを示している。
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止