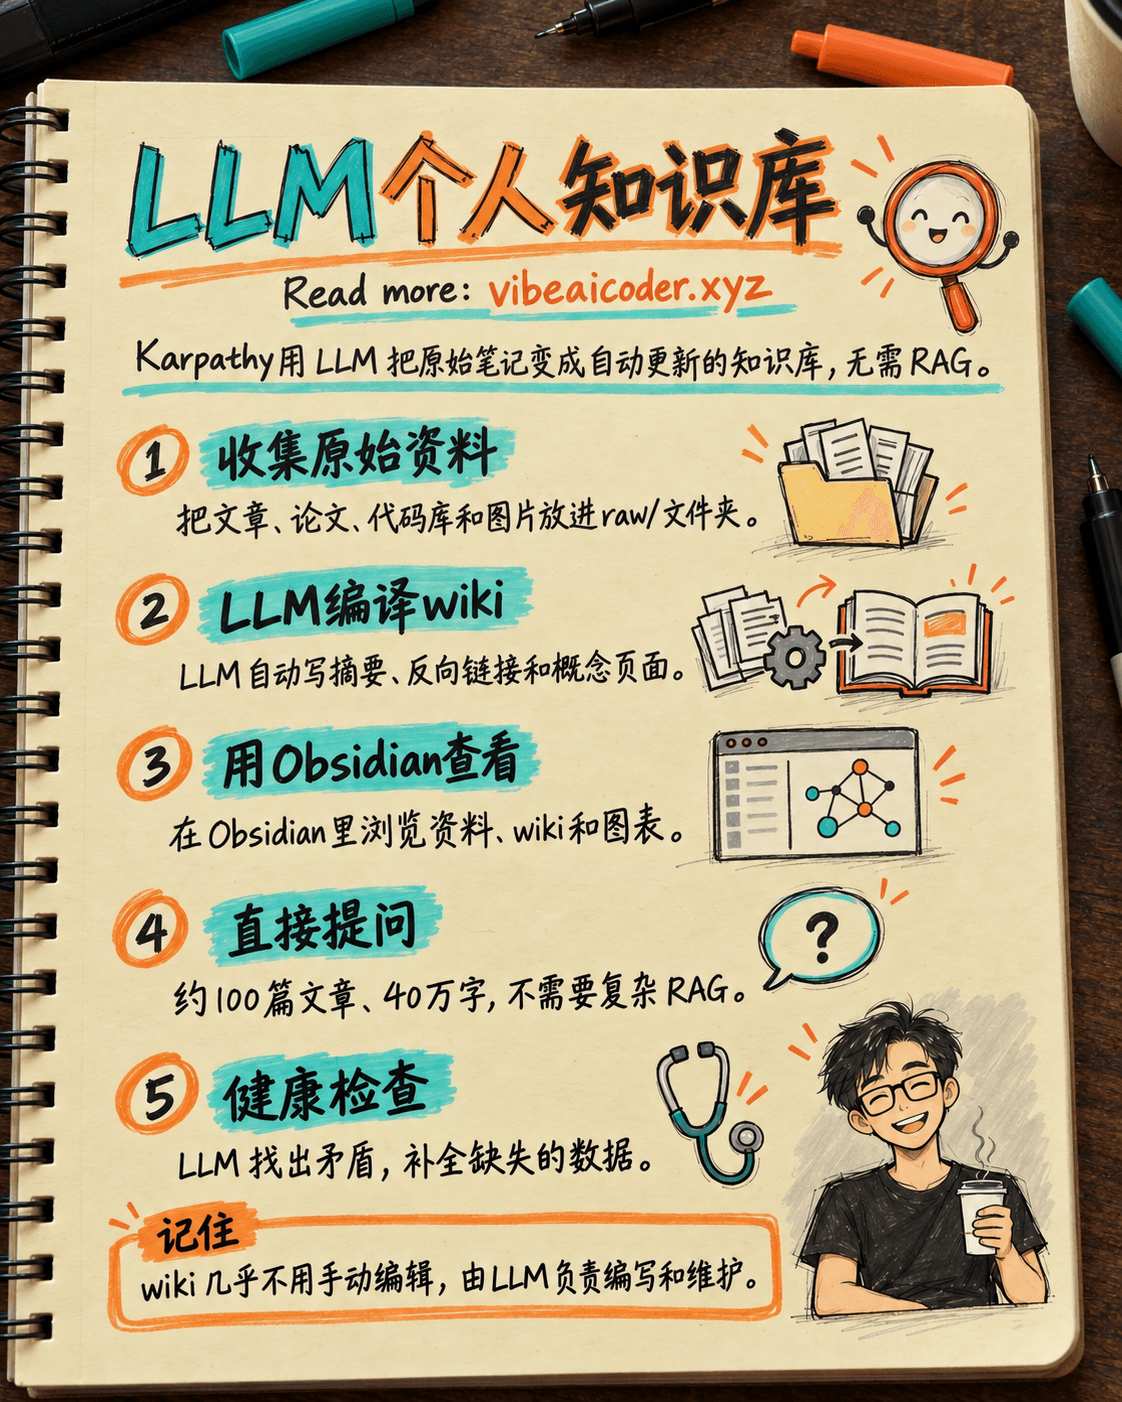
Andrej Karpathy分享:用LLM搭建个人知识库,不需要RAG
Andrej Karpathy,特斯拉前AI总监、OpenAI联合创始人,最近分享了一套非常有意思的工作流程:用LLM搭建个人研究知识库(knowledge base)。他不只是用AI写代码,而是把大部分"token吞吐量"转向处理和组织知识。
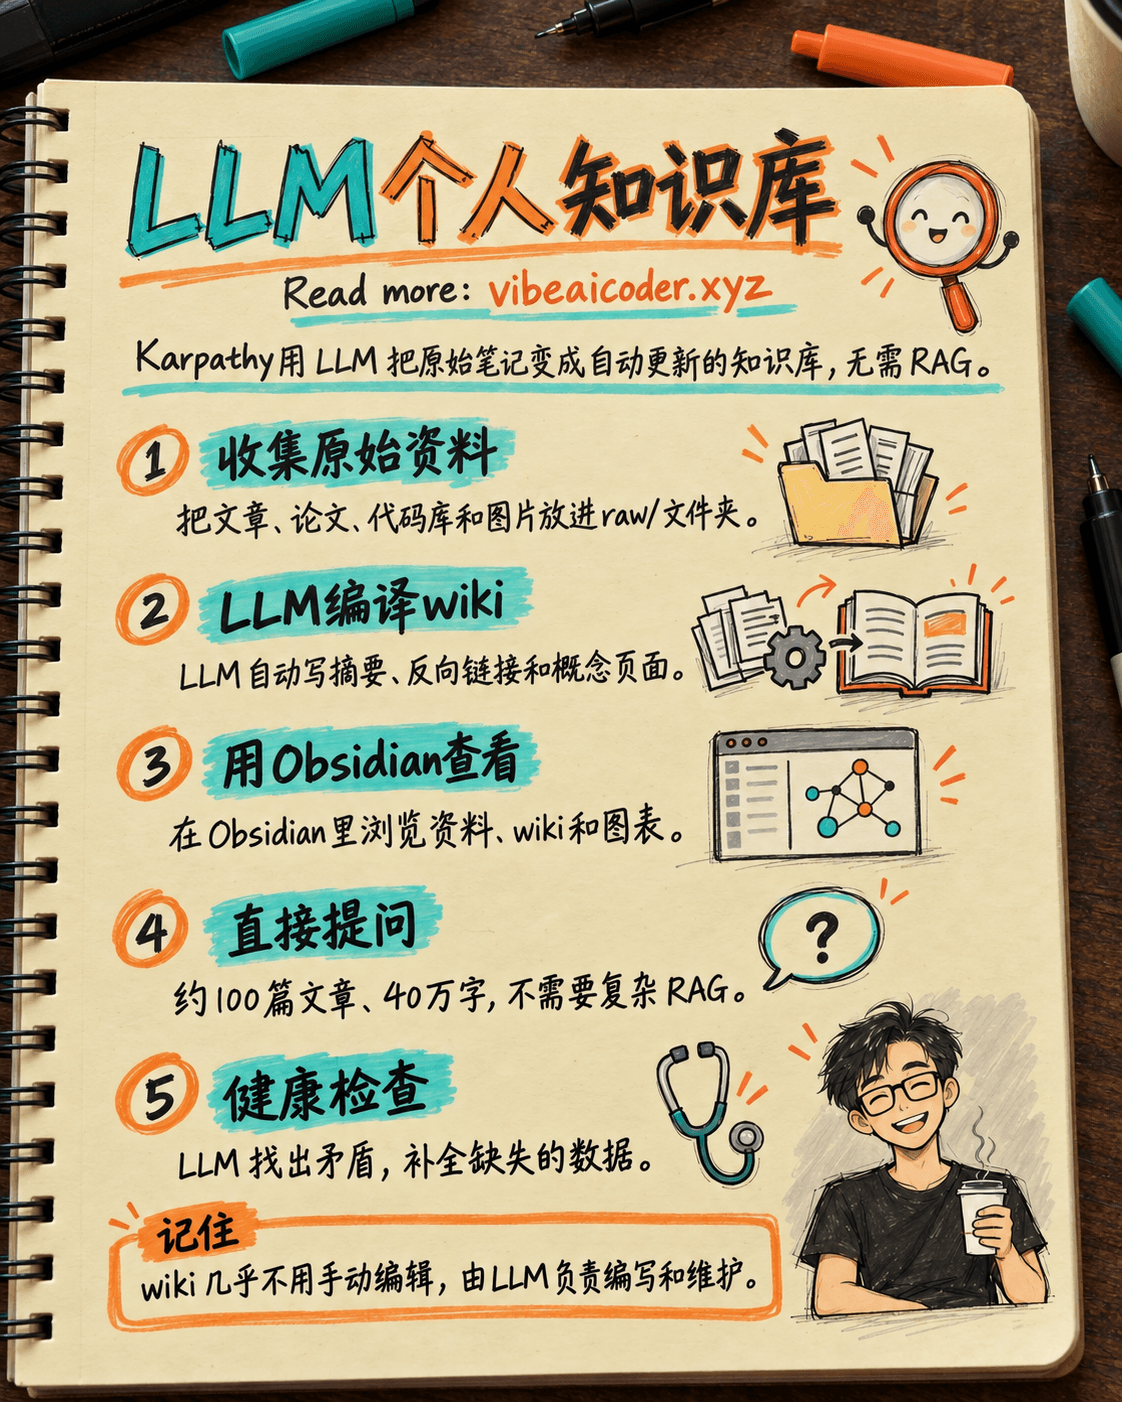
 收集原始数据
第一步是把所有原始资料都丢进一个raw/文件夹里。包括新闻文章、研究论文、GitHub仓库、数据集、图片等等。Karpathy用Obsidian Web Clipper把网页文章转成.md文件,还设置了快捷键把相关图片下载到本地,方便LLM引用。
关键点在于:完全不需要事先整理或格式化。全部扔进raw/,剩下的交给LLM处理。
 LLM把原始数据"编译"成wiki
这是最精彩的一步。LLM读完全部raw数据后,会自动把它们"编译"成一个wiki,本质上是一组有目录结构的.md文件。这个wiki包括:
→ 对raw/里每份资料的摘要 → 各篇文章之间的反向链接(backlinks) → 按概念(concepts)对数据分类 → 为每个概念撰写解释性文章 → 所有文章之间的交叉链接
你几乎不会直接去编辑这个wiki,那是LLM的"地盘"。
 用Obsidian作为查看界面
Karpathy把Obsidian当作一个"前端IDE",用来查看原始数据、编译好的wiki,以及各种可视化内容。Obsidian的markdown渲染效果很好,支持反向链接、关系图谱(graph view),还有很多实用插件。比如Marp插件可以直接在Obsidian里渲染幻灯片。
 直接在wiki上问答
当wiki积累到一定规模后(例如Karpathy自己的研究wiki大约有100篇文章和400,000字),你就可以向LLM agent提出各种复杂问题。LLM会自己搜索、阅读相关文章,再综合给出答案。
令人意外的是:完全不需要复杂的RAG。LLM会自己维护索引文件和每份资料的简短摘要。在这种规模下(约100篇文章),LLM处理相关数据相当轻松。
 输出结果并写回wiki
Karpathy不满足于终端里的纯文本回答,而是要求LLM把结果渲染成:
→ Markdown文件 → 幻灯片(Marp格式) → matplotlib图表 → 以及其他各种可视化格式
这些内容都可以在Obsidian里直接查看。有意思的是,这些结果通常会被"归档"回wiki,用来丰富后续的查询。每一次新发现和新问题都会不断"积累"进知识库里。
🧹 用LLM做数据"体检"
Karpathy还会用LLM对wiki做健康检查:
→ 找出文章之间相互矛盾的数据 → 补充缺失的数据(借助网络搜索) → 发现值得写成新文章的有趣联系 → 清理数据、提升整体一致性
LLM在建议进一步研究方向、提出更多问题方面表现得相当出色。
 自建配套工具
Karpathy还自己写了一些工具来处理数据。比如他"vibe coded"了一个小型搜索引擎给wiki用,既可以通过网页界面直接使用,也作为一个工具提供给LLM,通过CLI调用来处理更大规模的查询。
下一步的方向是:合成数据生成(synthetic data generation)+ 微调(fine-tuning),让LLM把这些知识真正"记"进权重里,而不只是依赖上下文窗口。
 流程小结
多来源的原始数据 → LLM编译成.md格式的wiki → LLM通过CLI持续维护wiki,用于问答和不断改进 → 一切都能在Obsidian里查看。你几乎从不需要亲自编写或修改wiki,这些都是LLM的工作。
Karpathy的看法是:"这里有空间做出一个很棒的产品,而不只是一堆杂乱的脚本。"这或许就是个人知识管理的未来方向。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制