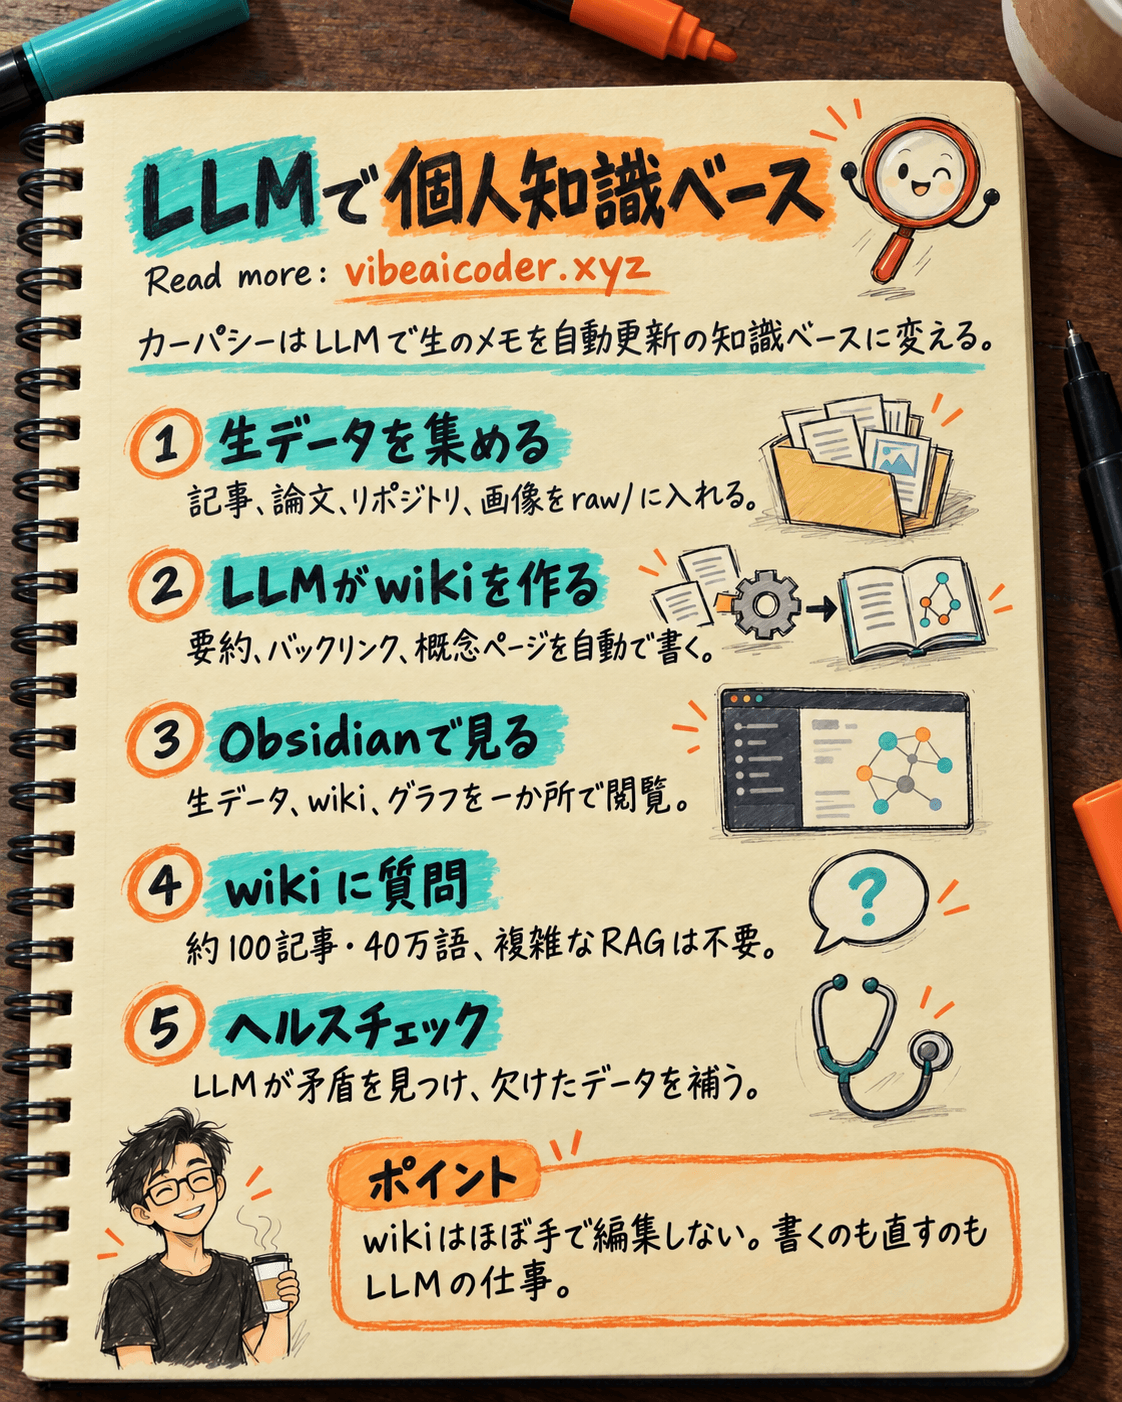
アンドレイ・カーパシー流 LLMで個人ナレッジベースを構築、RAGは不要
アンドレイ・カーパシー(Andrej Karpathy、元Tesla AI責任者、OpenAI共同創業者)が、研究のためにLLMを使って個人用ナレッジベースを構築するという、非常に興味深いワークフローを公開しました。コードを書かせるためだけにAIを使うのではなく、カーパシーは「トークンのスループット」の多くを知識の処理と整理に振り向けているのです。
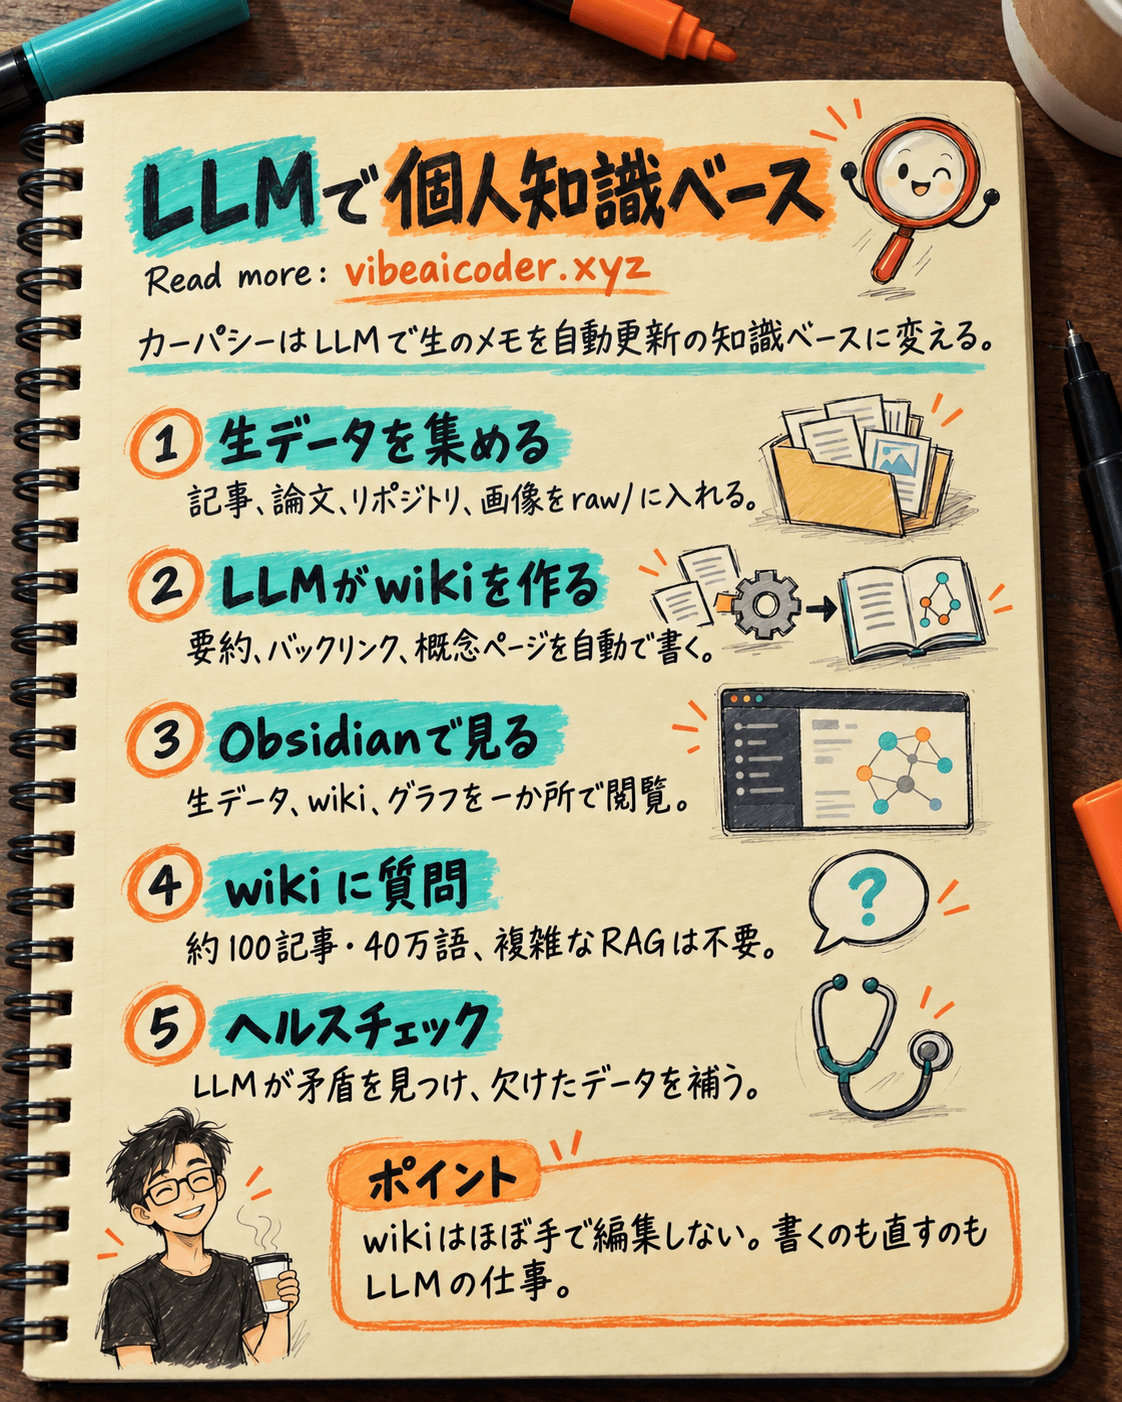
生データを集める
最初のステップは、すべてのソース資料をraw/フォルダにまとめることです。記事、研究論文、GitHubリポジトリ、データセット、画像などが対象になります。カーパシーはObsidian Web Clipperを使ってウェブ記事を.mdファイルに変換し、ホットキーで関連画像をローカルに保存して、LLMが参照しやすいようにしています。
重要なポイントは、フォーマットや整理を一切しなくてよいということです。とにかくraw/に放り込んでおけば、あとはLLMが処理してくれます。
LLMがwikiに「コンパイル」する
ここが最も面白い部分です。LLMはraw/の中のデータをすべて読み込み、自動的にwiki、つまり構造化されたディレクトリ内の.mdファイル群へと「コンパイル」します。このwikiには以下が含まれます。
→ raw/内の各資料の要約 → 記事同士をつなぐバックリンク → 概念(コンセプト)ごとのデータ分類 → 各概念を説明する記事 → すべての記事間の相互リンク
wikiを直接編集することはほとんどありません。そこはLLMの「縄張り」だからです。
ビューアとしてのObsidian
カーパシーはObsidianを、生データ・コンパイル済みのwiki・各種ビジュアライゼーションを閲覧するための「フロントエンドIDE」として使っています。Obsidianはマークダウンの表示に優れ、バックリンクやグラフビュー、便利なプラグインを多数サポートしています。たとえばMarpプラグインを使えば、Obsidian内で直接スライドをレンダリングできます。
wiki上で直接質問する
wikiが十分な規模になると(カーパシーの研究用wikiは約100本の記事、400,000語に達しています)、LLMエージェントにあらゆる複雑な質問を投げかけられるようになります。LLMは自動的に関連する記事を検索・読解し、答えを統合してくれます。
驚くべきことに、複雑なRAGは不要です。LLMが自らインデックスファイルと各資料の短い要約を維持してくれるからです。この規模(約100本程度)であれば、LLMが関連データを読み込んで処理するのはそれほど難しくありません。
出力結果をwikiに書き戻す
ターミナルにテキストで答えを返すだけでなく、カーパシーはLLMに次のような形式でレンダリングさせています。
→ マークダウンファイル → スライドショー(Marp形式) → matplotlibによるグラフ → その他さまざまなビジュアル形式
これらはすべてObsidian上で閲覧できます。興味深いのは、こうした出力結果がしばしばwikiに「ファイリング」され、以降の問い合わせをより豊かにしていく点です。あらゆる発見や質問がナレッジベースの中に「蓄積」されていきます。
LLMによる「ヘルスチェック」
カーパシーはLLMを使ってwikiの健全性チェックも行っています。
→ 記事間の矛盾したデータを発見する → 不足しているデータを補完する(ウェブ検索を利用) → 新しい記事につながりそうな興味深い関連性を見つける → データの整合性を整理・向上させる
LLMは、さらに深く研究するための追加の問いを提案するのが非常に得意です。
補助ツール
カーパシーはデータ処理のための独自ツールも書いています。たとえばwiki用の小さな検索エンジンを「vibeコーディング」し、ウェブUIから直接使えるだけでなく、CLI経由でLLMに大規模なクエリ用のツールとして提供しています。
次の発展方向として想定されているのは、合成データ生成とファインチューニングです。これにより、LLMがコンテキストウィンドウ経由だけでなく、重み(weights)そのものにデータを「知っている」状態にすることを目指しています。
まとめ
さまざまなソースからの生データ → LLMが.md形式のwikiにコンパイル → LLMがCLI経由でwikiを運用し、質問応答と継続的な改善を行う → すべてObsidian上で閲覧可能。wikiを自分で直接書いたり編集したりすることはほとんどなく、それはLLMの仕事です。
カーパシーはこう述べています。「ここには、雑多なスクリプトの寄せ集めではなく、素晴らしいプロダクトを作れる余地がある」。これは個人の知識管理の未来を示しているのかもしれません。
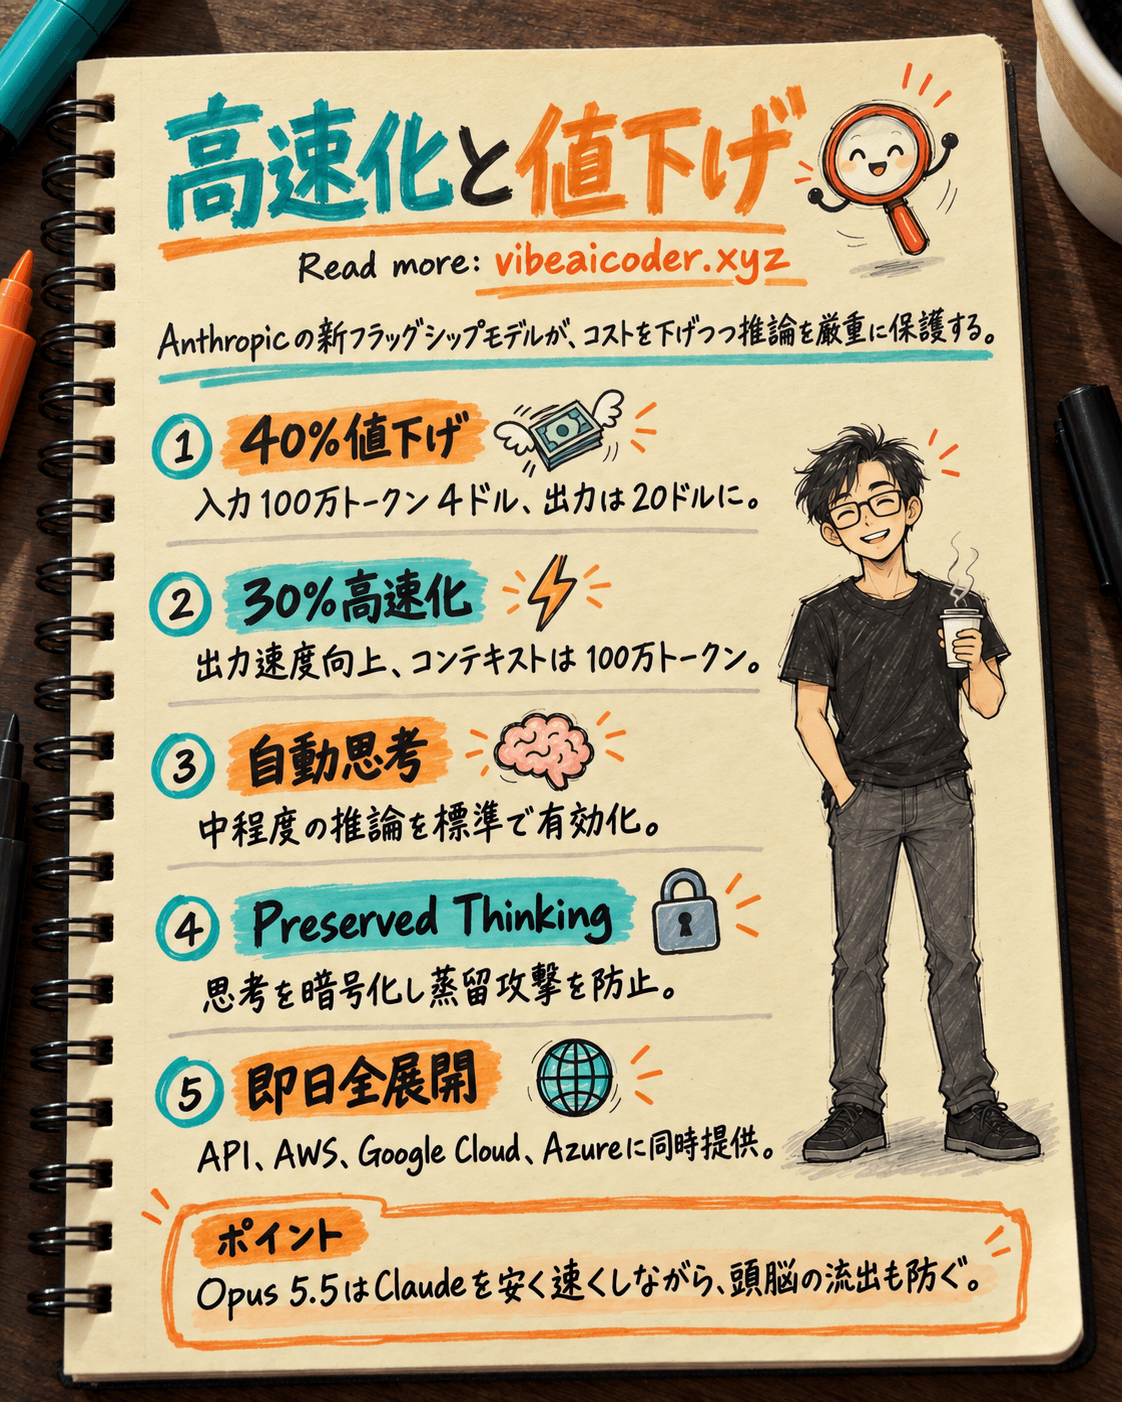
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止