 Dữ liệu tổng hợp (synthetic data) là gì? AI có thể tự tạo dữ liệu để dạy chính nó không
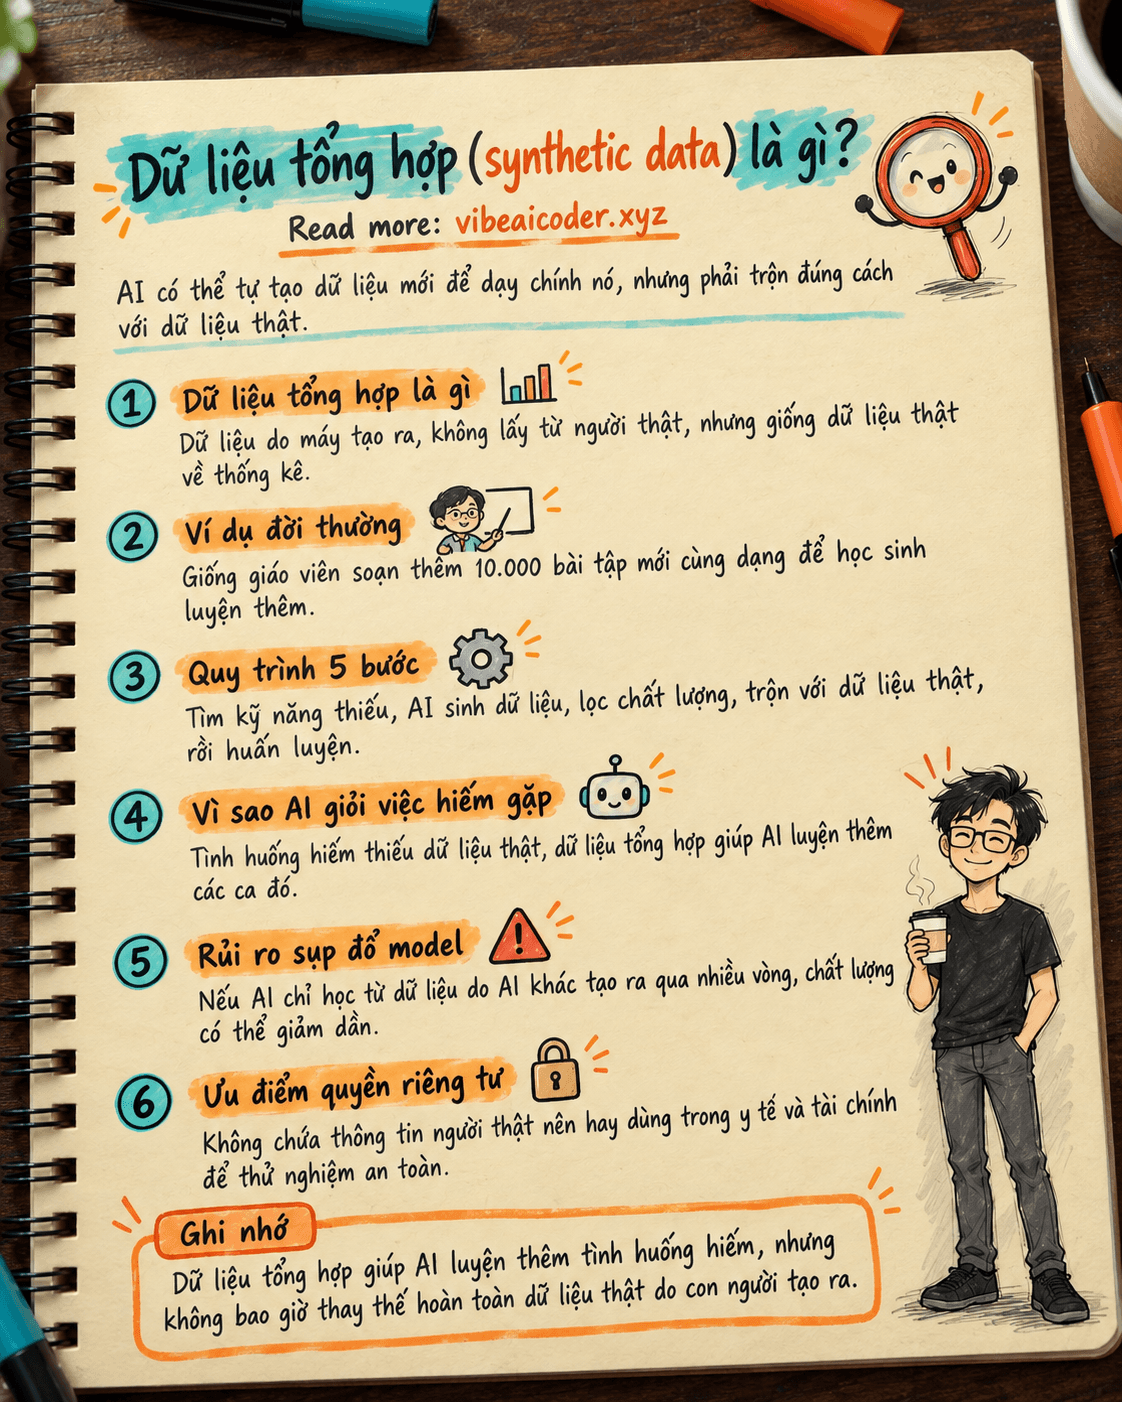
Dữ liệu tổng hợp (synthetic data) là dữ liệu do máy tính tạo ra, không lấy trực tiếp từ người thật hay sự kiện thật, nhưng được làm sao cho giống dữ liệu thật về mặt thống kê và cấu trúc. Nói đơn giản, thay vì đi thu thập hàng triệu câu hỏi thật của người dùng để huấn luyện AI, các công ty có thể dùng chính một AI khác để "bịa" ra hàng triệu câu hỏi và câu trả lời mẫu, miễn là chúng hợp lý và đa dạng. Đây là một trong những cách các công ty AI, trong đó có Anthropic (đơn vị tạo ra Claude), giải bài toán thiếu dữ liệu chất lượng cao khi huấn luyện model mới.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng bạn đang dạy một học sinh luyện thi toán, nhưng sách bài tập thật trong nhà trường chỉ có 100 câu. Để học sinh luyện nhiều hơn, bạn nhờ một giáo viên giỏi khác soạn thêm 10.000 câu bài tập mới, cùng dạng, cùng độ khó, nhưng không chép lại nguyên văn từ sách nào cả. 10.000 câu đó chính là "dữ liệu tổng hợp": không có thật trong bất kỳ cuốn sách nào, nhưng vẫn luyện đúng kỹ năng cần luyện.
AI cũng làm tương tự. Khi dữ liệu thật (văn bản, hội thoại, đoạn code do con người viết) không đủ nhiều hoặc không đủ đa dạng cho một kỹ năng cụ thể, các công ty dùng một model AI để sinh ra thêm ví dụ huấn luyện mới, rồi lọc và kiểm tra chất lượng trước khi dùng để dạy model khác (hoặc dạy lại chính nó).
 Nó hoạt động thế nào
Quy trình tạo và dùng dữ liệu tổng hợp thường có mấy bước chính:
- Xác định kỹ năng còn thiếu. Ví dụ model trả lời toán còn yếu, hoặc viết code Python chưa chắc tay.
- Dùng một model AI mạnh để sinh dữ liệu mẫu. Model này tạo ra hàng loạt câu hỏi, lời giải, đoạn hội thoại mới theo đúng dạng cần luyện.
- Lọc và kiểm tra chất lượng. Dữ liệu sinh ra được chấm điểm, loại bỏ câu sai, câu lặp, câu vô nghĩa. Có thể dùng chính AI để tự chấm, hoặc con người kiểm tra mẫu ngẫu nhiên.
- Trộn với dữ liệu thật. Đây là bước quan trọng nhất: dữ liệu tổng hợp gần như không bao giờ dùng một mình, mà được trộn cùng dữ liệu do con người tạo ra, để tránh model chỉ học theo "khẩu vị" của một AI khác.
- Huấn luyện hoặc tinh chỉnh model bằng tập dữ liệu đã trộn, giống như bước huấn luyện và tinh chỉnh (fine-tuning) thông thường.
Kỹ thuật này gắn liền với cách các công ty AI dạy model biết từ chối yêu cầu nguy hiểm hoặc trả lời an toàn hơn, một quá trình gọi là RLHF (học từ phản hồi của con người), nơi dữ liệu tổng hợp thường được dùng để tạo thêm tình huống giả định cho model luyện tập.
 Điều này có ý nghĩa gì với bạn
Với người dùng AI hằng ngày, dữ liệu tổng hợp không phải thứ bạn trực tiếp thao tác, nhưng nó ảnh hưởng đến cách AI trả lời bạn:
- Vì sao AI ngày càng giỏi những việc hiếm gặp. Những tình huống hiếm trong đời thực (ví dụ một dạng lỗi code lạ, hoặc một câu hỏi pháp lý ít gặp) thường thiếu dữ liệu thật. Dữ liệu tổng hợp giúp model được luyện thêm cho đúng những trường hợp hiếm đó, nên bạn thấy AI trả lời tốt hơn qua từng phiên bản.
- Khi bạn tự tạo dữ liệu huấn luyện cho công việc riêng. Nếu công ty bạn đang tinh chỉnh (fine-tune) một model nhỏ để trả lời theo phong cách riêng, nhưng không có đủ hội thoại thật, bạn có thể thử prompt: "Hãy tạo 50 cặp câu hỏi, câu trả lời mẫu cho [loại sản phẩm], theo đúng giọng văn thân thiện, ngắn gọn của shop tôi" để có dữ liệu luyện ban đầu, sau đó vẫn cần người thật kiểm tra lại trước khi dùng thật.
- Hiểu vì sao AI đôi khi "học lẫn nhau". Nhiều bài viết, hình ảnh trên mạng hiện nay cũng do AI tạo ra. Nếu các model tương lai vô tình học lại chính những nội dung đó mà không có đủ dữ liệu thật để đối chiếu, chất lượng có thể giảm dần theo thời gian, một hiện tượng giới nghiên cứu gọi là "sụp đổ model" (model collapse).
 Hiểu lầm thường gặp
- "Dữ liệu tổng hợp là dữ liệu giả, không đáng tin." Không hẳn. Dữ liệu tổng hợp vẫn hữu ích nếu được lọc kỹ và trộn đúng tỷ lệ với dữ liệu thật. Vấn đề chỉ xảy ra khi dùng dữ liệu tổng hợp không kiểm soát, lặp lại nhiều vòng mà không có dữ liệu thật đối chiếu.
- "Cứ để AI tự tạo dữ liệu dạy chính nó là đủ, không cần dữ liệu thật nữa." Nghiên cứu hiện tại cho thấy nếu một model chỉ học từ dữ liệu do chính nó (hoặc một AI khác) tạo ra, qua nhiều vòng lặp, chất lượng câu trả lời có thể xuống cấp dần, giống như sao chụp một bản photocopy từ chính bản photocopy trước đó. Dữ liệu thật do con người tạo ra vẫn luôn cần thiết để giữ model đi đúng hướng.
- "Dữ liệu tổng hợp chỉ dùng cho văn bản." Thực tế nó được dùng cho cả hình ảnh (ảnh mô phỏng tình huống lái xe hiếm gặp để huấn luyện xe tự lái), dữ liệu y tế mô phỏng (để bảo vệ quyền riêng tư bệnh nhân) và dữ liệu giao dịch tài chính giả để luyện hệ thống phát hiện gian lận.
 Câu hỏi thường gặp
Dữ liệu tổng hợp có an toàn hơn dữ liệu thật về quyền riêng tư không? Thường là có, vì nó không chứa thông tin thật của người cụ thể nào. Đây là lý do ngành y tế và tài chính hay dùng dữ liệu tổng hợp để thử nghiệm hệ thống mà không lộ thông tin khách hàng thật.
Claude có được huấn luyện bằng dữ liệu tổng hợp không? Anthropic, công ty tạo ra Claude, có công khai sử dụng các kỹ thuật tạo dữ liệu huấn luyện bổ sung (bao gồm dữ liệu do model tự sinh ra và được lọc lại) như một phần trong quy trình huấn luyện và làm cho model an toàn hơn, bên cạnh dữ liệu thật và phản hồi của con người. Đây là cách làm phổ biến trong ngành, không riêng một công ty nào.
Model collapse (sụp đổ model) có đang thực sự xảy ra không? Đây vẫn là chủ đề nghiên cứu đang tiếp diễn. Các thí nghiệm cho thấy nguy cơ xảy ra rõ nhất khi model chỉ học từ dữ liệu tự sinh qua nhiều vòng lặp, không có dữ liệu thật xen vào. Khi dữ liệu thật vẫn được giữ lại và trộn đều, nguy cơ này giảm đi nhiều.
Tôi có thể tự tạo dữ liệu tổng hợp để luyện AI riêng cho công việc của mình không? Có. Bạn có thể nhờ Claude hoặc ChatGPT sinh ra bộ câu hỏi, câu trả lời mẫu cho một việc cụ thể (trả lời khách hàng, viết mô tả sản phẩm). Chỉ cần nhớ luôn kiểm tra lại bằng mắt người trước khi dùng, vì AI vẫn có thể bịa sai thông tin khi sinh dữ liệu mẫu.
Khác gì giữa dữ liệu tổng hợp và dữ liệu đã được ẩn danh hóa? Dữ liệu ẩn danh hóa vẫn bắt đầu từ dữ liệu thật, chỉ che hoặc xóa phần thông tin cá nhân. Dữ liệu tổng hợp thì không xuất phát từ một bản ghi thật cụ thể nào, nó được tạo mới hoàn toàn để mô phỏng đặc điểm thống kê của dữ liệu thật.
Muốn hiểu rõ hơn gốc rễ của quá trình này, bạn có thể đọc thêm về AI học như thế nào qua huấn luyện trước và tinh chỉnh, cách chưng cất mô hình (distillation) giúp AI nhỏ vẫn thông minh, RLHF giúp AI biết từ chối và trả lời an toàn hơn, và nếu bạn còn mới với AI nói chung, hãy bắt đầu từ bài AI là gì.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
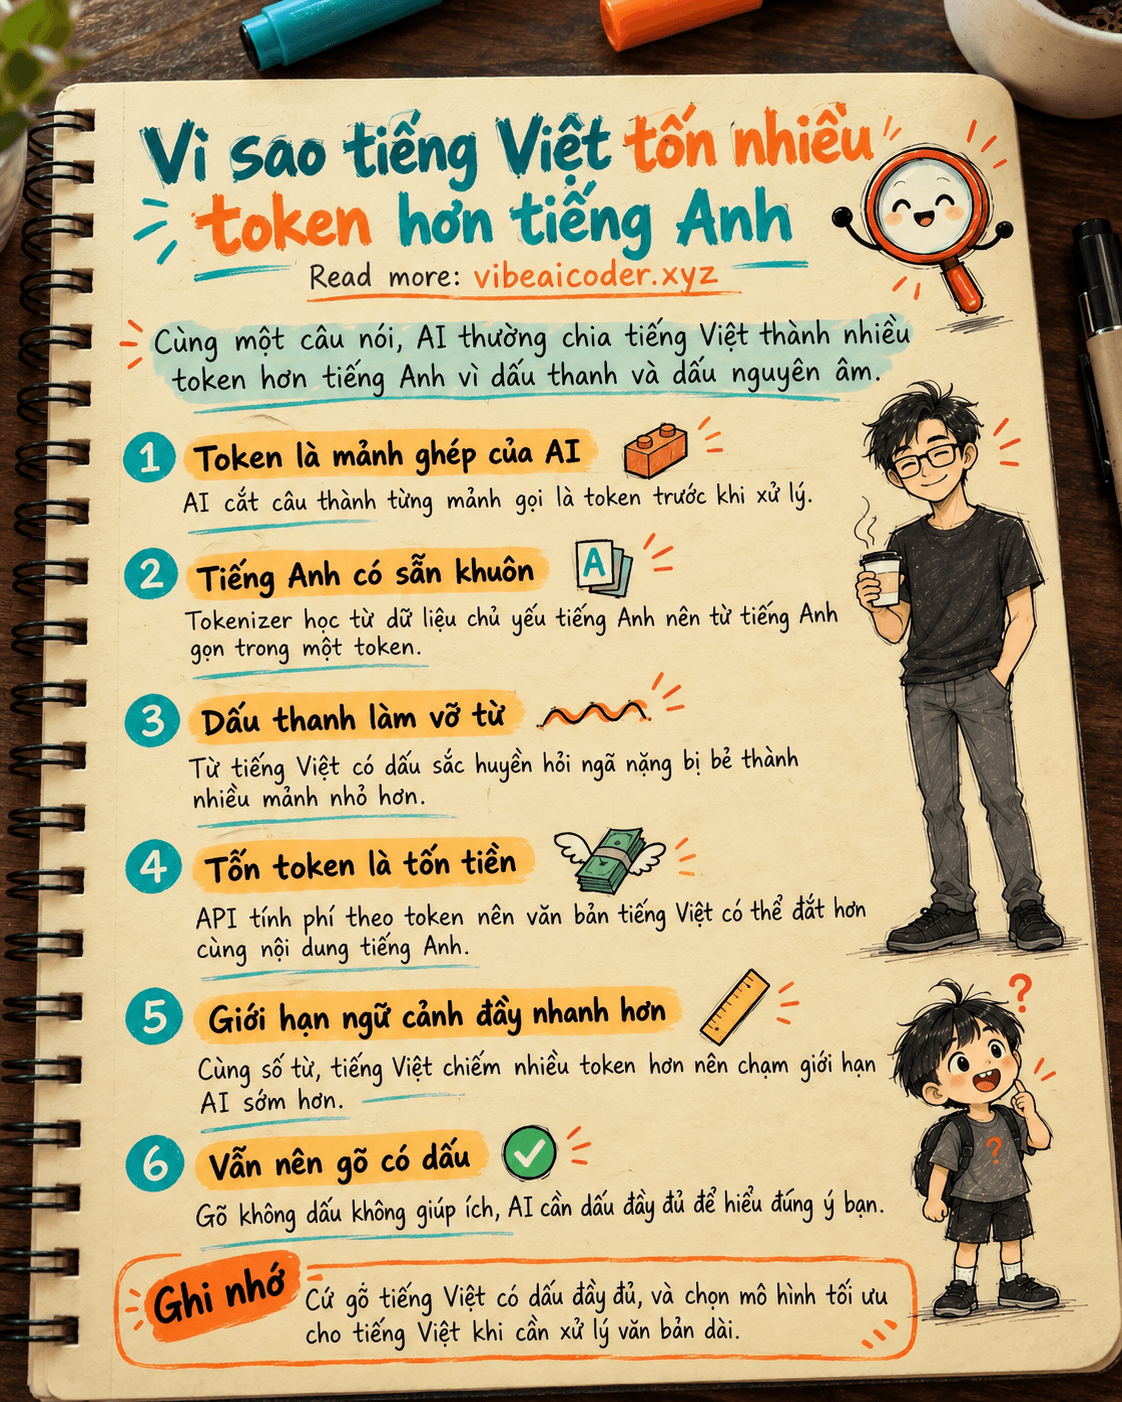
 Vì sao gõ tiếng Việt tốn nhiều token hơn tiếng Anh?