 Embedding là gì? Cách AI biết hai câu giống nghĩa nhau
📺 Xem bản video 2 phút
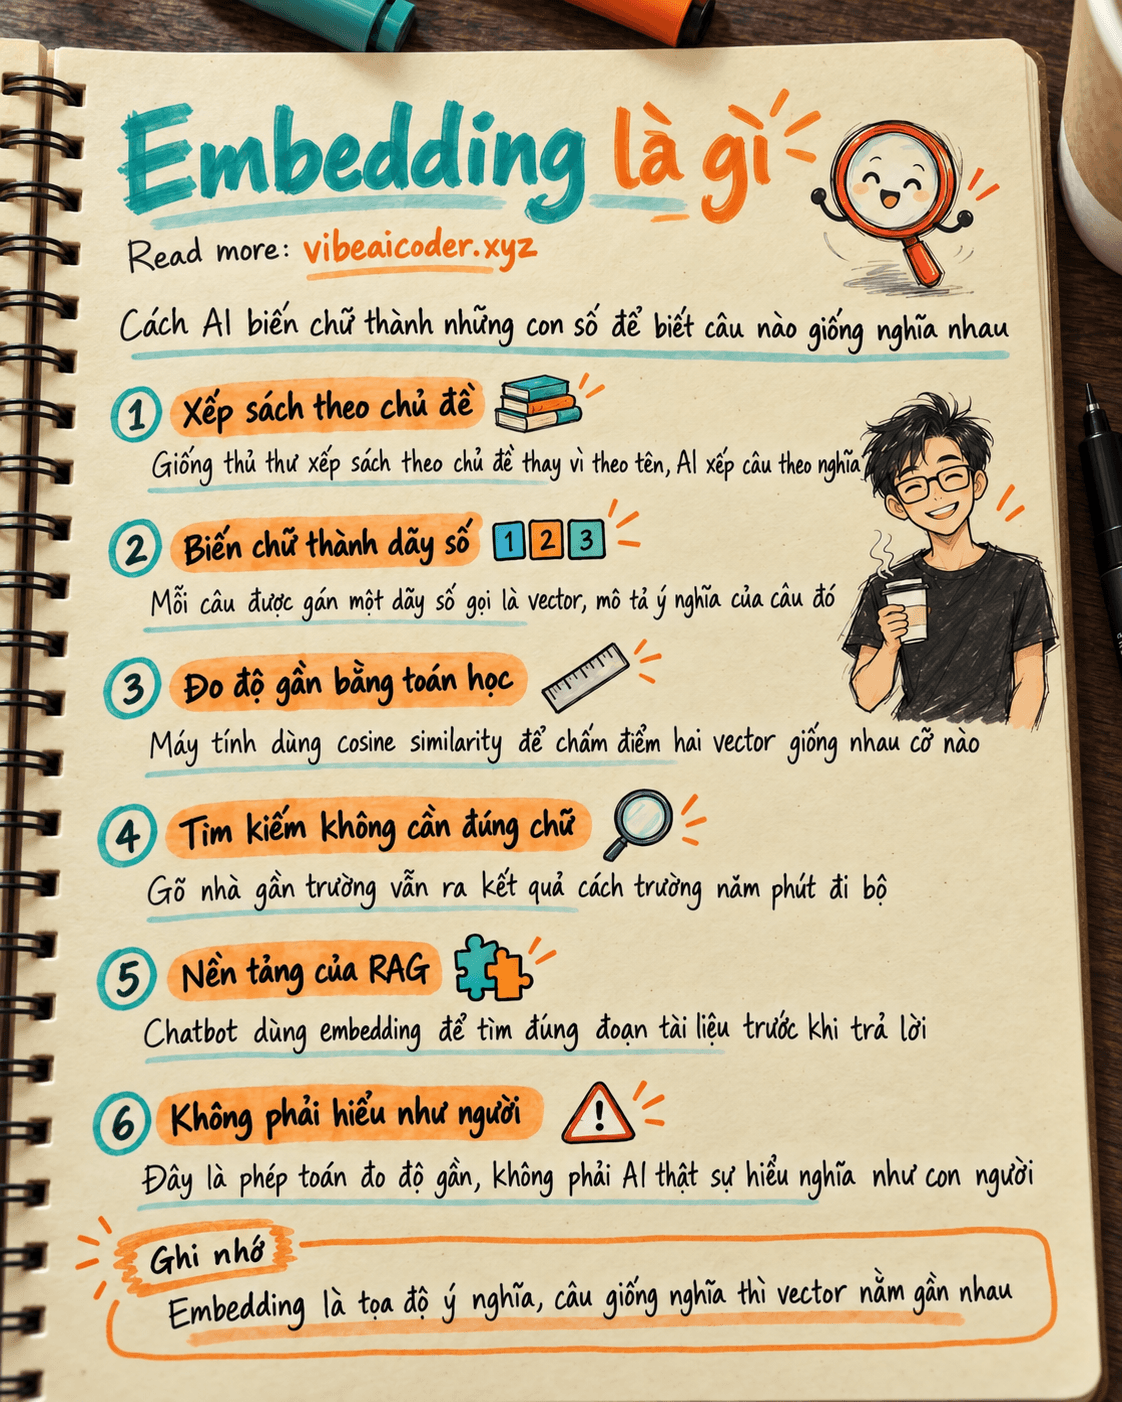
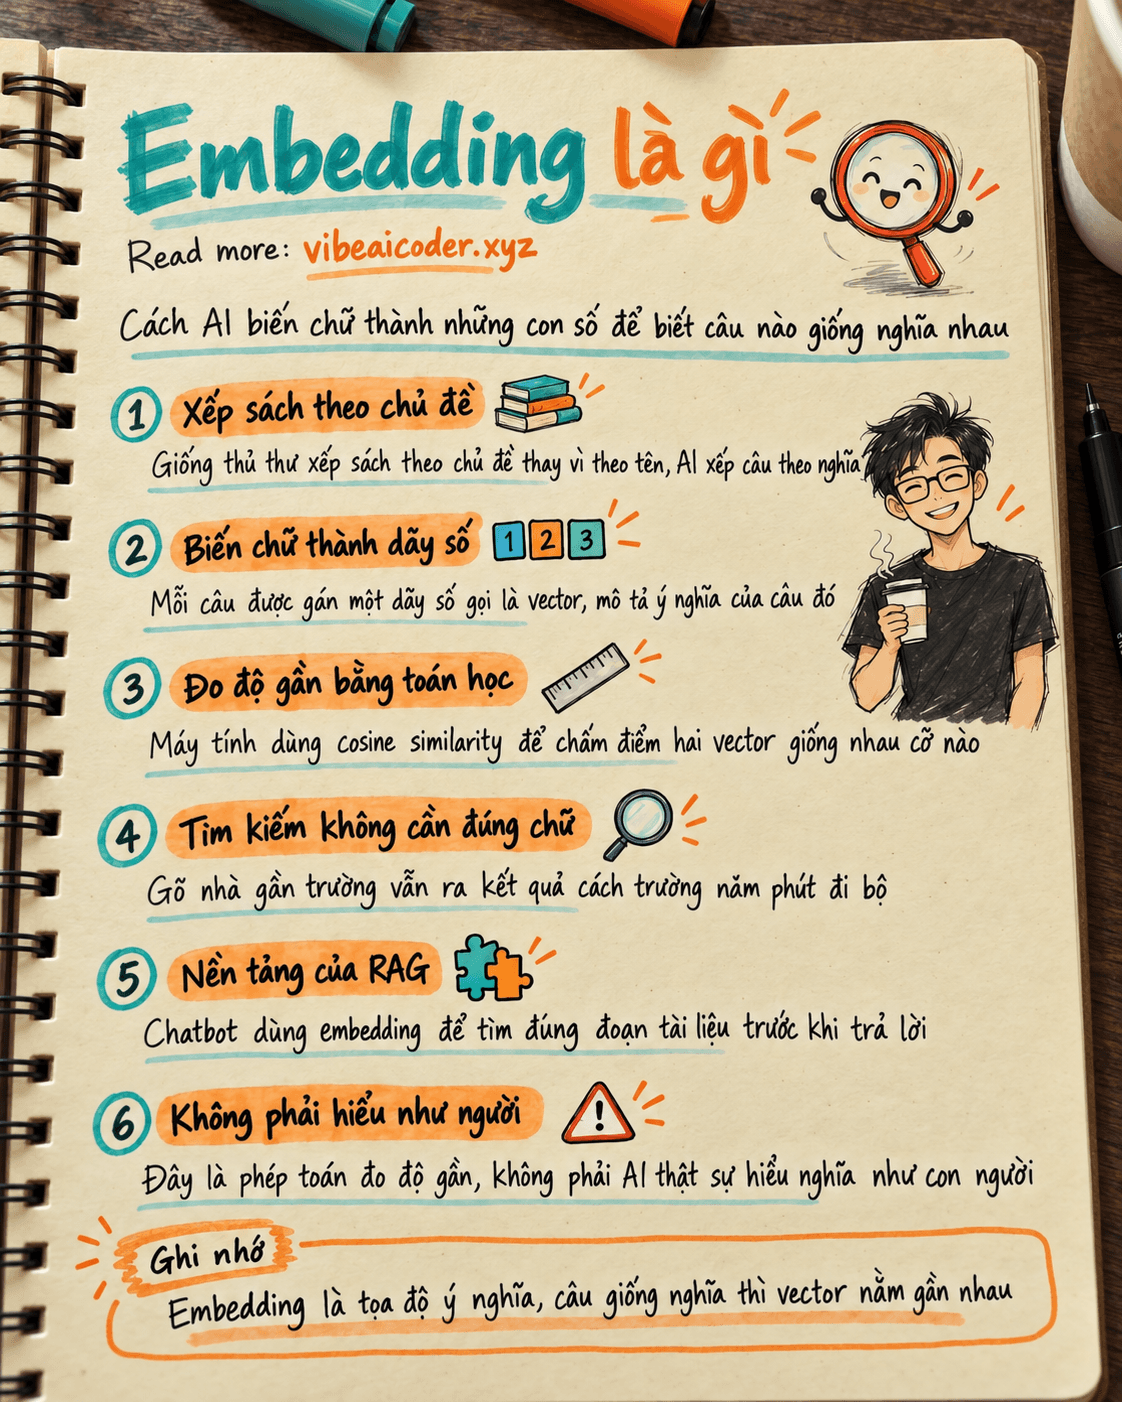
Embedding là cách AI biến chữ (hoặc ảnh, âm thanh) thành một dãy số, để máy tính có thể so sánh xem hai thứ có giống nghĩa nhau hay không. Nhờ vậy AI mới tìm được tài liệu liên quan, gợi ý sản phẩm tương tự, hay nhớ đúng đoạn văn bản cần dùng dù bạn không gõ trúng từ khóa.
 Hiểu nhanh bằng ví dụ đời thường
Tưởng tượng một thủ thư xếp sách trong thư viện. Nếu xếp theo thứ tự ABC của tên sách, hai cuốn cùng nói về nấu ăn nhưng tên khác nhau (ví dụ "Bếp nhà" và "Món ngon mỗi ngày") có thể nằm cách xa nhau cả chục kệ. Một thủ thư giỏi hơn sẽ xếp sách theo chủ đề: mọi cuốn về nấu ăn đứng gần nhau, mọi cuốn về du lịch đứng gần nhau ở khu khác, dù tên sách chẳng cuốn nào giống cuốn nào.
Embedding chính là cách AI "xếp kệ" như vậy, nhưng thay vì kệ sách thật, nó xếp trong một không gian có hàng trăm, hàng nghìn chiều mà con người không hình dung nổi. Mỗi từ, mỗi câu, mỗi đoạn văn bản được gán cho một vị trí trong không gian đó, dưới dạng một dãy số gọi là vector. Những thứ có nghĩa gần nhau thì vector của chúng cũng nằm gần nhau, bất kể chữ viết ra có giống nhau hay không.
 Nó hoạt động thế nào
- Một mô hình chuyên biệt (gọi là embedding model) đọc một đoạn văn bản, một tấm ảnh, hoặc một đoạn âm thanh.
- Nó biến đoạn đó thành một dãy số cố định, ví dụ vài trăm đến hơn một nghìn con số, gọi là vector.
- Trong quá trình huấn luyện, mô hình học cách đặt những câu có nghĩa giống nhau vào vị trí gần nhau, và những câu khác nghĩa vào vị trí xa nhau.
- Để đo "gần nhau" cỡ nào, máy tính dùng một phép toán gọi là cosine similarity, cho ra điểm số từ 0 đến 1, càng gần 1 càng giống nghĩa.
- Khi bạn gõ một câu hỏi hay từ khóa tìm kiếm, AI biến câu đó thành vector theo đúng cách trên, rồi đi tìm những đoạn văn bản có vector gần nhất trong kho dữ liệu, đây chính là cơ chế đứng sau RAG.
 Điều này có ý nghĩa gì với bạn
Một khi hiểu embedding, bạn sẽ dùng AI hiệu quả hơn ở vài chỗ cụ thể:
- Tìm kiếm không cần đúng từ khóa. Gõ "nhà gần trường học cho con đi bộ" vẫn ra kết quả ghi "cách trường tiểu học 5 phút đi bộ", vì embedding so khớp theo nghĩa chứ không theo chữ.
- Chatbot nội bộ công ty trả lời đúng tài liệu. Khi một trợ lý AI được nối với kho tài liệu công ty (hợp đồng, quy trình, FAQ), nó dùng embedding để lục đúng đoạn liên quan trước khi trả lời, thay vì bịa ra câu trả lời. Đây cũng là lý do RAG ra đời.
- Gợi ý sản phẩm hay bài viết "giống" nhau. Shop online gợi ý "sản phẩm tương tự" không dựa vào tên sản phẩm trùng chữ, mà dựa vào vector embedding của mô tả sản phẩm nằm gần nhau.
- Biết khi nào nên hỏi khác đi. Nếu AI tìm sai tài liệu, thử đổi cách diễn đạt câu hỏi, vì vector sinh ra có thể lệch sang vùng khác nếu câu hỏi mơ hồ.
 Hiểu lầm thường gặp
- "Embedding nghĩa là AI hiểu như con người." Không hẳn. Đây chỉ là một phép toán đo độ gần về mặt thống kê dựa trên dữ liệu đã học, không phải sự hiểu biết thật sự. AI có thể xếp sai nếu dữ liệu huấn luyện ít gặp trường hợp đó.
- "Embedding chỉ dùng cho văn bản." Thực ra ảnh, âm thanh, video đều biến thành embedding được. Một số mô hình còn đặt ảnh và chữ mô tả vào chung một không gian, nhờ vậy bạn gõ chữ mà tìm ra đúng tấm ảnh.
- "Embedding với token là một." Khác nhau. Token là cách AI cắt nhỏ câu chữ thành từng mảnh để xử lý và tính tiền. Embedding là dãy số mô tả Ý NGHĨA của một từ, câu hay đoạn văn bản, dùng để so sánh và tìm kiếm.
 Câu hỏi thường gặp
Embedding có phải một phần của mô hình ngôn ngữ lớn (LLM) không? Có liên quan nhưng là hai việc khác nhau. LLM chuyên tạo ra câu trả lời, còn embedding model chuyên biến văn bản thành vector để so sánh và tìm kiếm. Nhiều hệ thống AI dùng cả hai cùng lúc.
Tự làm embedding có tốn tiền không? Có, nếu dùng qua API thì tính theo số token đưa vào, nhưng giá thường rẻ hơn nhiều so với gọi mô hình trả lời đầy đủ, vì embedding model nhỏ và nhanh hơn.
RAG dùng embedding để làm gì? RAG dùng embedding để tìm đúng đoạn tài liệu liên quan đến câu hỏi trước, rồi mới đưa đoạn đó cho AI đọc và trả lời, giúp câu trả lời bám sát tài liệu thật thay vì AI tự bịa.
Embedding có an toàn khi đưa dữ liệu công ty vào không? Về nguyên tắc vector không phải là văn bản gốc nên khó đọc ngược lại trực tiếp, nhưng vẫn nên dùng dịch vụ embedding đáng tin cậy và tránh đưa thông tin nhạy cảm (mật khẩu, số thẻ) vào bất kỳ hệ thống AI nào.
Làm sao biết hai đoạn văn bản có embedding "gần nhau" hay không nếu tôi không phải dân kỹ thuật? Bạn không cần tự tính, các công cụ tìm kiếm AI hay chatbot đã làm việc đó ở phía sau. Điều bạn cần nhớ là diễn đạt câu hỏi rõ ràng, vì câu hỏi mơ hồ sẽ cho ra vector mơ hồ và kết quả tìm kiếm kém chính xác hơn.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
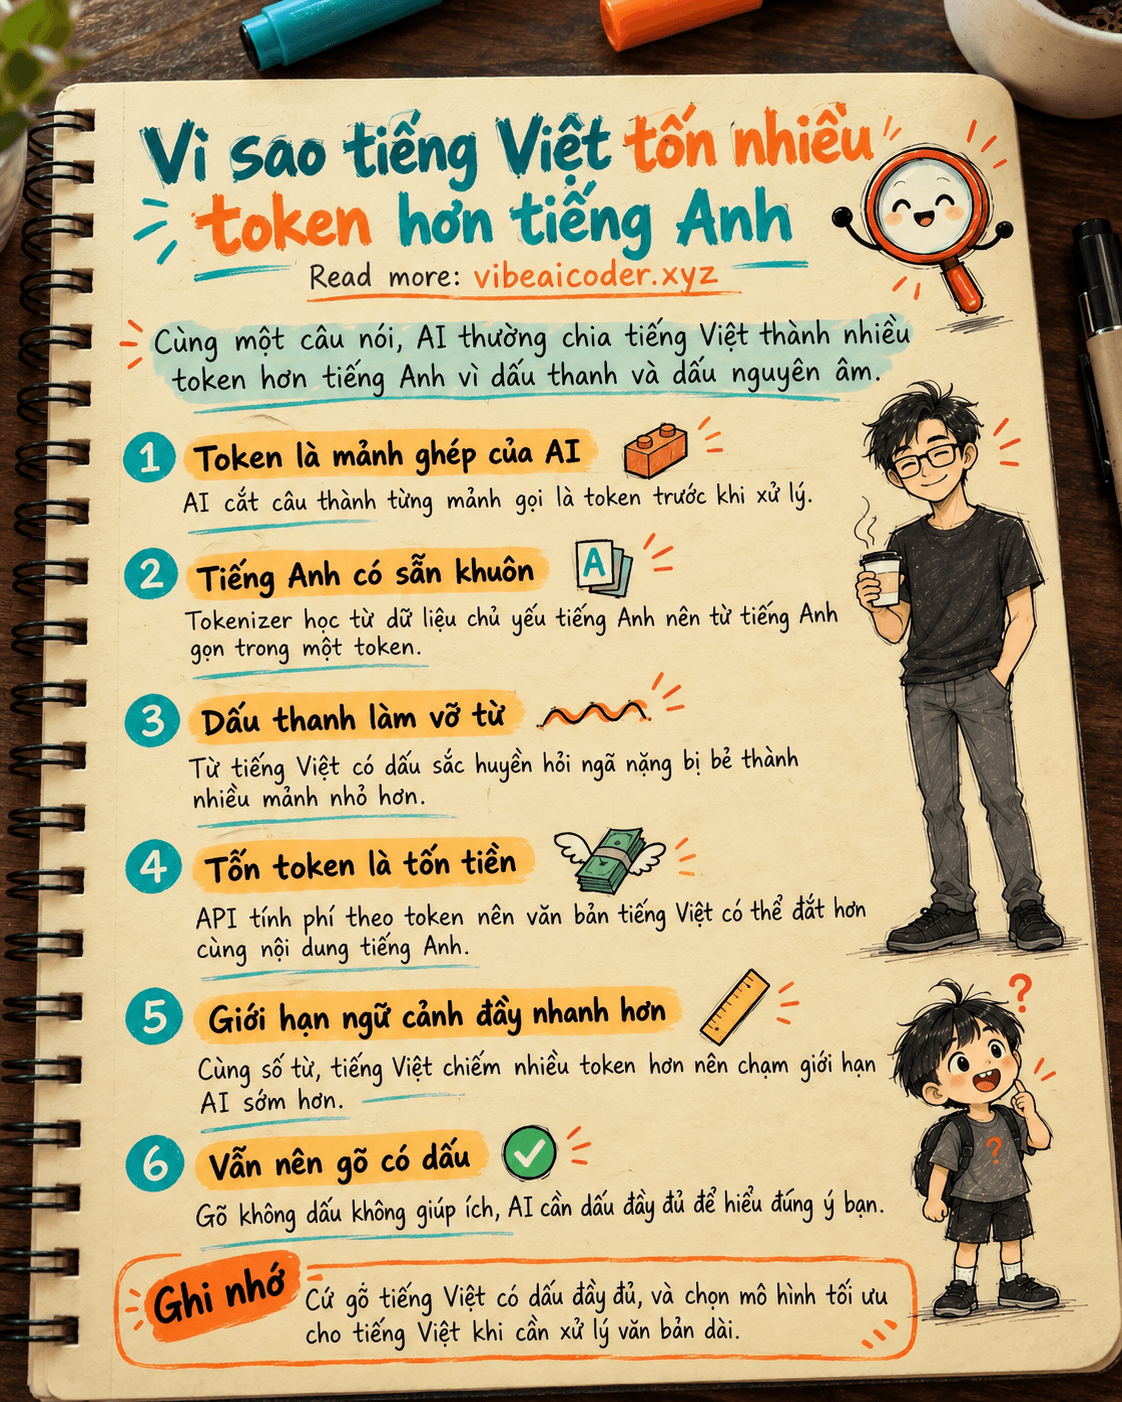
 Vì sao gõ tiếng Việt tốn nhiều token hơn tiếng Anh?