Constitutional AI là gì: cách Anthropic dạy Claude tự kiểm soát hành vi
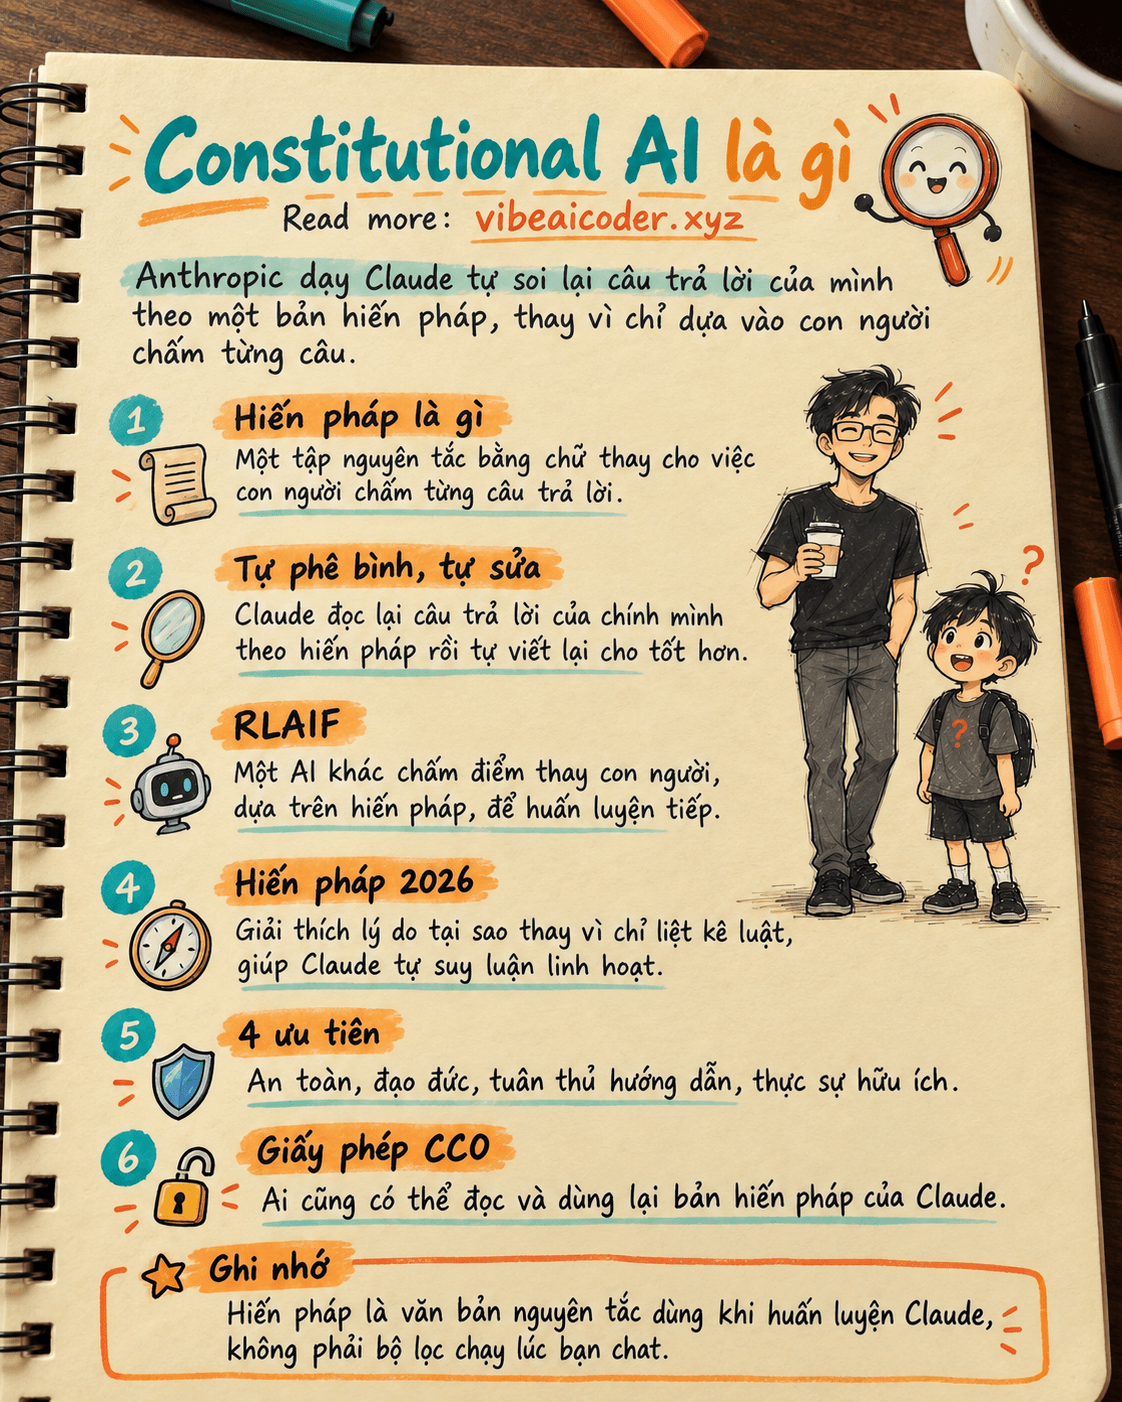
Constitutional AI (AI theo hiến pháp) là cách Anthropic huấn luyện Claude biết đúng sai bằng một bản "hiến pháp", tức một tập hợp nguyên tắc viết bằng chữ, thay vì chỉ dựa vào con người ngồi chấm từng câu trả lời là tốt hay xấu. Nói đơn giản, thay vì nhân viên phải đọc hàng triệu câu trả lời của AI để dạy nó "câu này ổn, câu kia không ổn", Anthropic đưa cho Claude một bộ quy tắc, rồi để chính Claude tự soi lại câu trả lời của mình theo bộ quy tắc đó và tự sửa.
 Hiểu nhanh bằng ví dụ đời thường
Tưởng tượng bạn đang dạy một thực tập sinh mới cách trả lời khách hàng. Có hai cách:
Cách thứ nhất: bạn ngồi cạnh thực tập sinh cả ngày, mỗi câu trả lời đều tự tay sửa, nói "câu này nên nói thế này mới lịch sự". Cách này giống RLHF truyền thống (học từ phản hồi con người), tốn cực nhiều thời gian và cần rất nhiều người có kinh nghiệm ngồi chấm.
Cách thứ hai: bạn đưa cho thực tập sinh một cuốn sổ tay quy tắc ứng xử (ví dụ: "luôn lịch sự, không hứa điều công ty không làm được, không tiết lộ thông tin riêng tư của khách khác"). Sau đó bạn bảo thực tập sinh tự đọc lại câu trả lời của mình, tự hỏi "mình có vi phạm quy tắc nào không", rồi tự sửa trước khi gửi đi. Bạn chỉ cần viết cuốn sổ tay một lần, thực tập sinh tự áp dụng cho hàng nghìn tình huống khác nhau.
Constitutional AI chính là cách thứ hai. "Cuốn sổ tay" đó gọi là hiến pháp (constitution), còn việc Claude tự đọc lại và tự sửa câu trả lời của mình gọi là tự phê bình và tự sửa (self-critique, self-revision).
 Nó hoạt động thế nào
Theo nghiên cứu gốc của Anthropic về Constitutional AI, quá trình huấn luyện gồm hai giai đoạn chính:
- Giai đoạn học có giám sát (SL): Claude trả lời một câu hỏi, sau đó tự phê bình câu trả lời của chính mình dựa trên các nguyên tắc trong hiến pháp (ví dụ: "câu trả lời này có khuyến khích hành vi nguy hiểm không?"), rồi tự viết lại một phiên bản tốt hơn. Những câu trả lời đã được tự sửa này được dùng để huấn luyện lại mô hình.
- Giai đoạn học tăng cường từ phản hồi của AI (RLAIF): Thay vì cần con người so sánh "câu trả lời A hay câu trả lời B tốt hơn" (như RLHF truyền thống), chính một mô hình AI khác đóng vai trò giám khảo, dựa trên hiến pháp để chấm điểm. Điểm số này trở thành tín hiệu thưởng để huấn luyện Claude ngày càng trả lời tốt hơn.
Nhờ cách làm này, Anthropic có thể kiểm soát hành vi của Claude chính xác hơn mà cần ít công sức gắn nhãn thủ công của con người hơn nhiều, đồng thời tạo ra một trợ lý vừa an toàn vừa không né tránh câu hỏi một cách khó chịu.
Bản thân "hiến pháp" cũng đã thay đổi theo thời gian. Phiên bản gốc năm 2023 liệt kê các nguyên tắc riêng lẻ kiểu "không được làm X, nên làm Y". Nhưng theo bản Hiến pháp mới của Claude công bố ngày 22 tháng 1 năm 2026, Anthropic chuyển sang cách tiếp cận giải thích lý do tại sao, thay vì chỉ liệt kê quy tắc khô khan. Tài liệu này được viết cho chính Claude đọc, giúp Claude hiểu bối cảnh nó đang hoạt động và kiểu "thực thể" mà Anthropic muốn nó trở thành, để Claude có thể tự suy luận và áp dụng nguyên tắc vào những tình huống mới lạ, thay vì chỉ máy móc làm theo luật đã liệt kê sẵn.
Bản hiến pháp 2026 đặt ra bốn ưu tiên cho Claude:
- An toàn trên diện rộng (broadly safe): không làm suy yếu khả năng giám sát của con người.
- Đạo đức trên diện rộng (broadly ethical): trung thực, tránh hành động nguy hiểm hoặc gây hại.
- Tuân thủ hướng dẫn của Anthropic (compliant with guidelines).
- Thực sự hữu ích (genuinely helpful): mang lại lợi ích thật sự cho người dùng.
Tài liệu này được Anthropic công bố theo giấy phép Creative Commons CC0 1.0, nghĩa là bất kỳ ai, kể cả các công ty AI khác, đều có thể đọc và sử dụng tự do.
 Điều này có ý nghĩa gì với bạn
Hiểu Constitutional AI giúp bạn dùng Claude thông minh hơn theo vài cách cụ thể:
- Khi Claude từ chối hoặc thận trọng với một yêu cầu, đó không phải Claude "khó tính" ngẫu nhiên, mà là nó đang áp dụng những nguyên tắc đã được huấn luyện sẵn trong hiến pháp, ví dụ nguyên tắc "an toàn trên diện rộng". Nếu bạn thấy câu trả lời bị từ chối oan, hãy thử giải thích rõ mục đích chính đáng của yêu cầu, vì Claude được dạy để suy luận theo bối cảnh chứ không chỉ chặn từ khóa.
- Khi cần Claude giữ vững một quy tắc riêng của bạn (ví dụ trong một ứng dụng doanh nghiệp), bạn có thể viết quy tắc đó rõ ràng trong system prompt, giống như việc "thêm một trang nhỏ vào cuốn hiến pháp" cho riêng phiên làm việc của bạn. Claude đã quen với việc đọc nguyên tắc và tự áp dụng, nên cách này thường hiệu quả hơn là liệt kê hàng chục lệnh cấm.
- Khi so sánh các mô hình AI khác nhau, bạn sẽ hiểu vì sao một số AI trả lời "cứng nhắc theo luật" trong khi Claude thường cố giải thích lý do hoặc tìm cách trả lời có ích trong giới hạn an toàn, đó là hệ quả trực tiếp của cách huấn luyện dựa trên hiến pháp và lý do, chứ không chỉ liệt kê quy tắc.
 Hiểu lầm thường gặp
- Hiểu lầm: "Hiến pháp là một đoạn code hoặc bộ lọc chặn từ khóa". Sự thật: hiến pháp là văn bản ngôn ngữ tự nhiên, giải thích nguyên tắc và lý do, được dùng trong quá trình huấn luyện mô hình (giai đoạn tự phê bình và giai đoạn RLAIF), không phải một lớp lọc chạy riêng khi bạn chat với Claude.
- Hiểu lầm: "Constitutional AI nghĩa là không cần con người tham gia nữa". Sự thật: con người vẫn là người viết ra hiến pháp và quyết định những nguyên tắc nào quan trọng. Chỉ có việc chấm điểm từng câu trả lời lặp đi lặp lại là được chuyển cho AI làm (RLAIF), chứ không phải toàn bộ quá trình bỏ qua con người.
- Hiểu lầm: "Claude cứng nhắc làm theo luật, không linh hoạt". Sự thật: mục tiêu của bản hiến pháp 2026 là ngược lại, Anthropic chủ động bỏ bớt việc liệt kê luật cứng để Claude hiểu lý do đằng sau, từ đó tự suy luận linh hoạt trong các tình huống mới mà bản hiến pháp chưa liệt kê sẵn.
 Câu hỏi thường gặp
Constitutional AI có phải chỉ Anthropic mới dùng không? Phương pháp này do Anthropic nghiên cứu và công bố, nhưng vì bản hiến pháp 2026 của Claude được phát hành theo giấy phép CC0 (miễn phí, không ràng buộc bản quyền), các nhóm nghiên cứu hoặc công ty khác cũng có thể tham khảo và áp dụng ý tưởng tương tự.
Hiến pháp của Claude có thay đổi được không? Có. Bản thân tài liệu đã được cập nhật từ phiên bản liệt kê nguyên tắc năm 2023 sang phiên bản giải thích lý do năm 2026, nghĩa là Anthropic tiếp tục chỉnh sửa khi hiểu rõ hơn cách giúp Claude cư xử tốt trong nhiều tình huống.
Constitutional AI khác RLHF ở điểm nào? RLHF cần con người trực tiếp so sánh và chấm điểm từng cặp câu trả lời. Constitutional AI dùng hiến pháp để một mô hình AI khác tự chấm điểm thay con người ở bước này (gọi là RLAIF), giúp giảm đáng kể khối lượng công việc thủ công mà vẫn kiểm soát được hành vi của mô hình.
Tôi có thể đọc bản hiến pháp của Claude không? Có, Anthropic công bố công khai bản hiến pháp 2026 trên trang chính thức của mình, ai cũng có thể đọc để hiểu Claude được kỳ vọng cư xử như thế nào và tại sao.
Vì sao Claude đôi khi vẫn trả lời sai hoặc "ảo giác" dù đã có hiến pháp? Hiến pháp giúp định hướng hành vi và giá trị (an toàn, trung thực, hữu ích), nhưng không đảm bảo mô hình luôn biết chính xác mọi sự thật. Đây là lý do vấn đề ảo giác của AI vẫn cần người dùng tự kiểm chứng thông tin quan trọng, giống như với bất kỳ AI nào khác.
Hiểu được Claude được dạy để "tự soi lại mình" theo một bộ nguyên tắc rõ ràng, thay vì chỉ học thuộc lòng hàng triệu ví dụ, sẽ giúp bạn đặt câu hỏi và đánh giá câu trả lời của nó một cách hợp lý hơn. Nếu bạn muốn tìm hiểu thêm những cơ chế đứng sau để AI trả lời an toàn, có thể đọc thêm về RLHF, guardrail và jailbreak AI.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
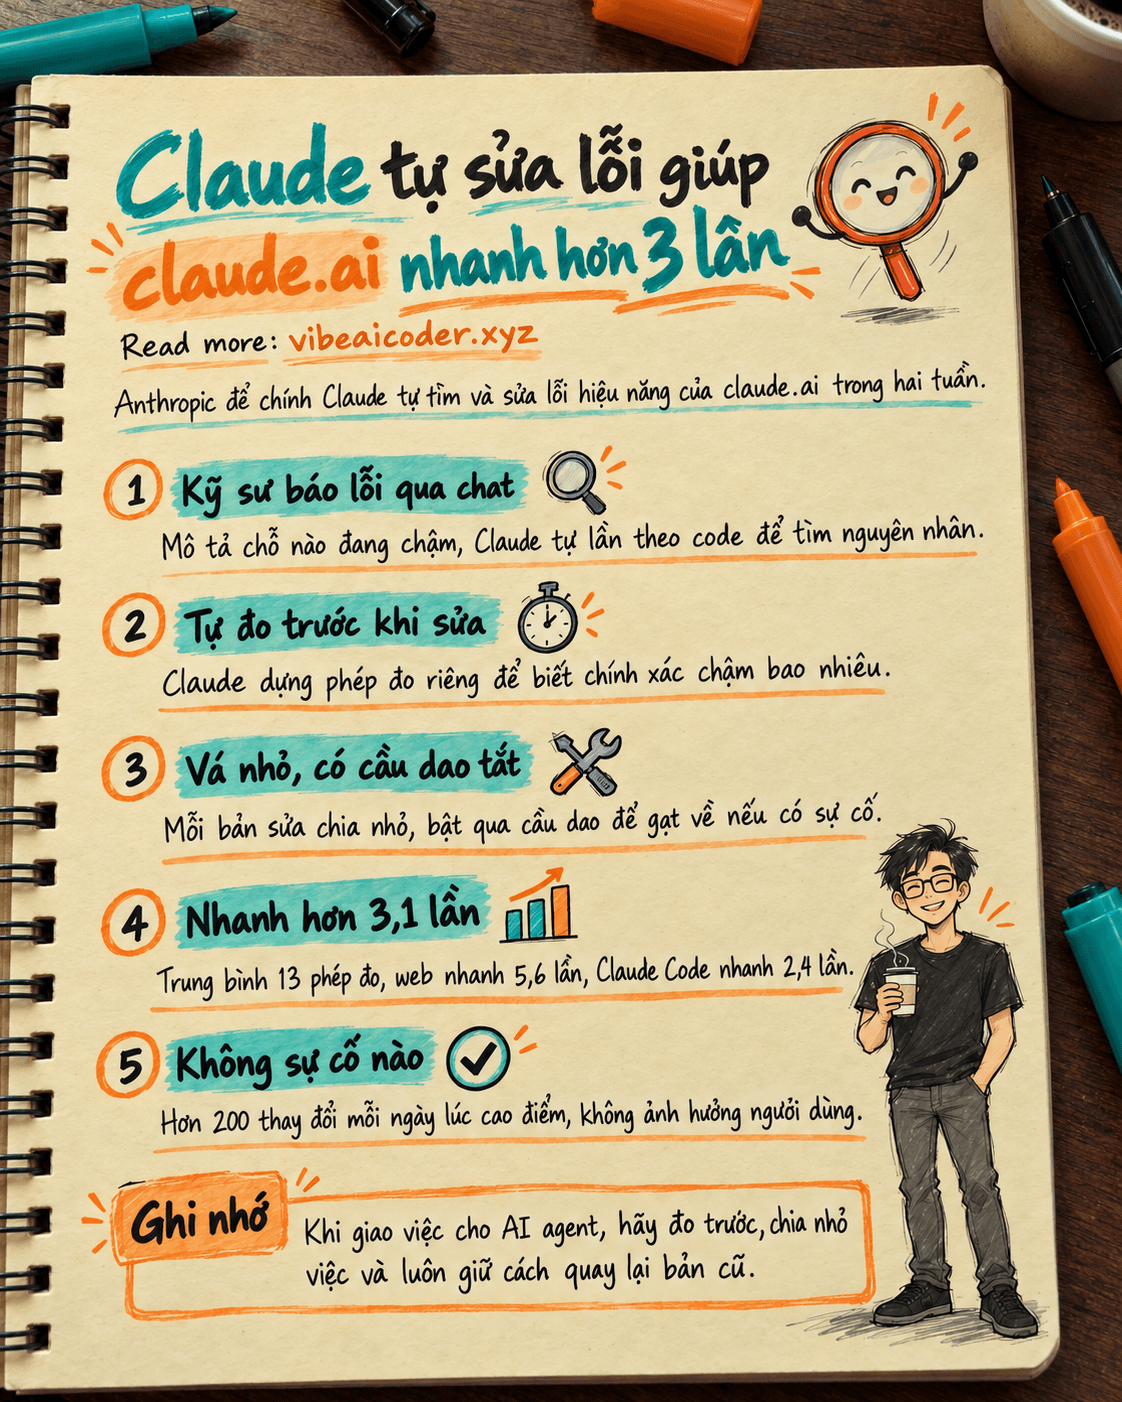
 Claude tự sửa lỗi giúp claude.ai nhanh hơn 3 lần, bài học từ Anthropic