AI tạo giọng nói và video hoạt động thế nào, giới hạn và rủi ro bản quyền bạn nên biết
 AI tạo giọng nói và video hoạt động thế nào, giới hạn và rủi ro bản quyền bạn nên biết
AI tạo giọng nói và video là công nghệ cho phép máy tính tự tạo ra một giọng đọc hoặc một đoạn phim chỉ từ vài dòng chữ, không cần micro, máy quay hay diễn viên thật. Bạn gõ mô tả, chờ vài giây đến vài phút, và nhận về một file âm thanh nghe như người thật hoặc một đoạn video có chuyển động, ánh sáng, thậm chí cả tiếng động đi kèm. Nhưng công nghệ càng giống thật thì nó càng kéo theo câu hỏi khó: ai được phép dùng giọng của ai, và video mình đang xem có thật hay không.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng một diễn viên lồng tiếng đã nghe hàng triệu giờ người khác nói chuyện, học thuộc cách ngắt câu, lên xuống giọng, cách một câu vui khác một câu buồn ra sao. Khi bạn đưa cho họ một kịch bản mới, họ đọc lên bằng chất giọng "chung chung" đó, không bắt chước một người cụ thể nào, trừ khi bạn yêu cầu riêng họ học theo giọng của một người thật trong vài phút rồi nói lại y hệt, đó chính là nhân bản giọng (voice cloning).
Với video, hãy nghĩ đến một họa sĩ đã xem hàng chục triệu đoạn phim và học được quy luật: quả bóng rơi thì nhanh dần, ánh nắng buổi chiều có màu vàng cam, một người bước đi thì tay chân di chuyển theo nhịp nào. Khi bạn mô tả một cảnh mới, họa sĩ đó không quay phim thật, mà vẽ nối tiếp hàng trăm khung hình dựa trên những quy luật đã học, ghép lại thành một đoạn chuyển động trông như thật.
 Nó hoạt động thế nào
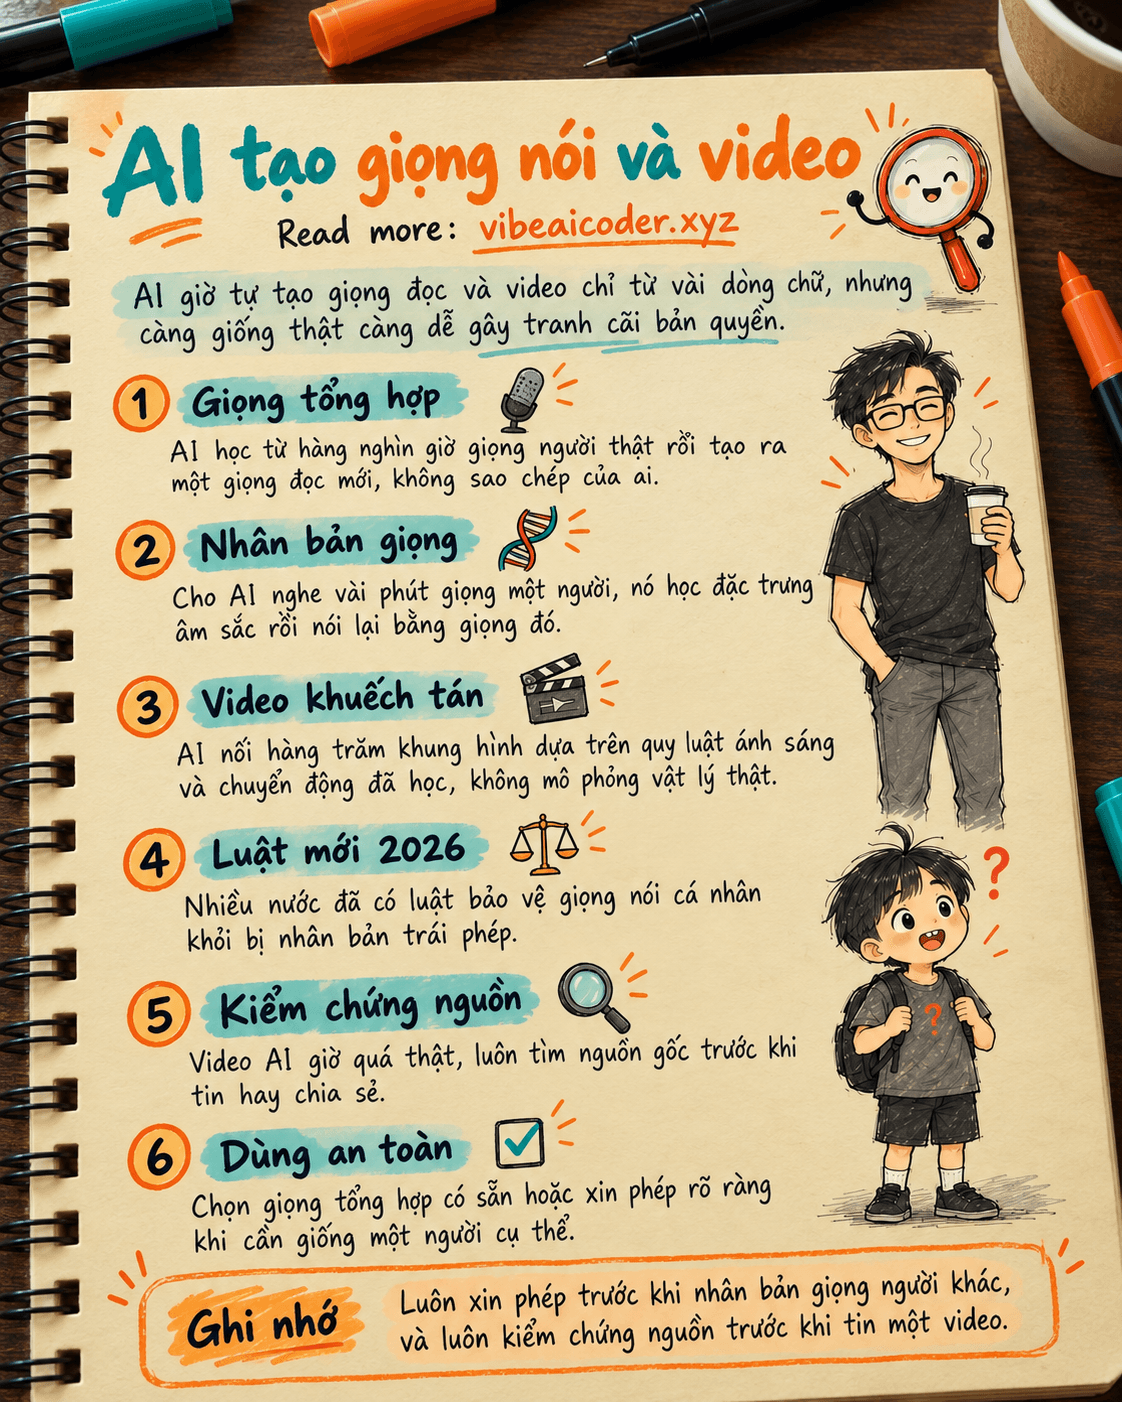
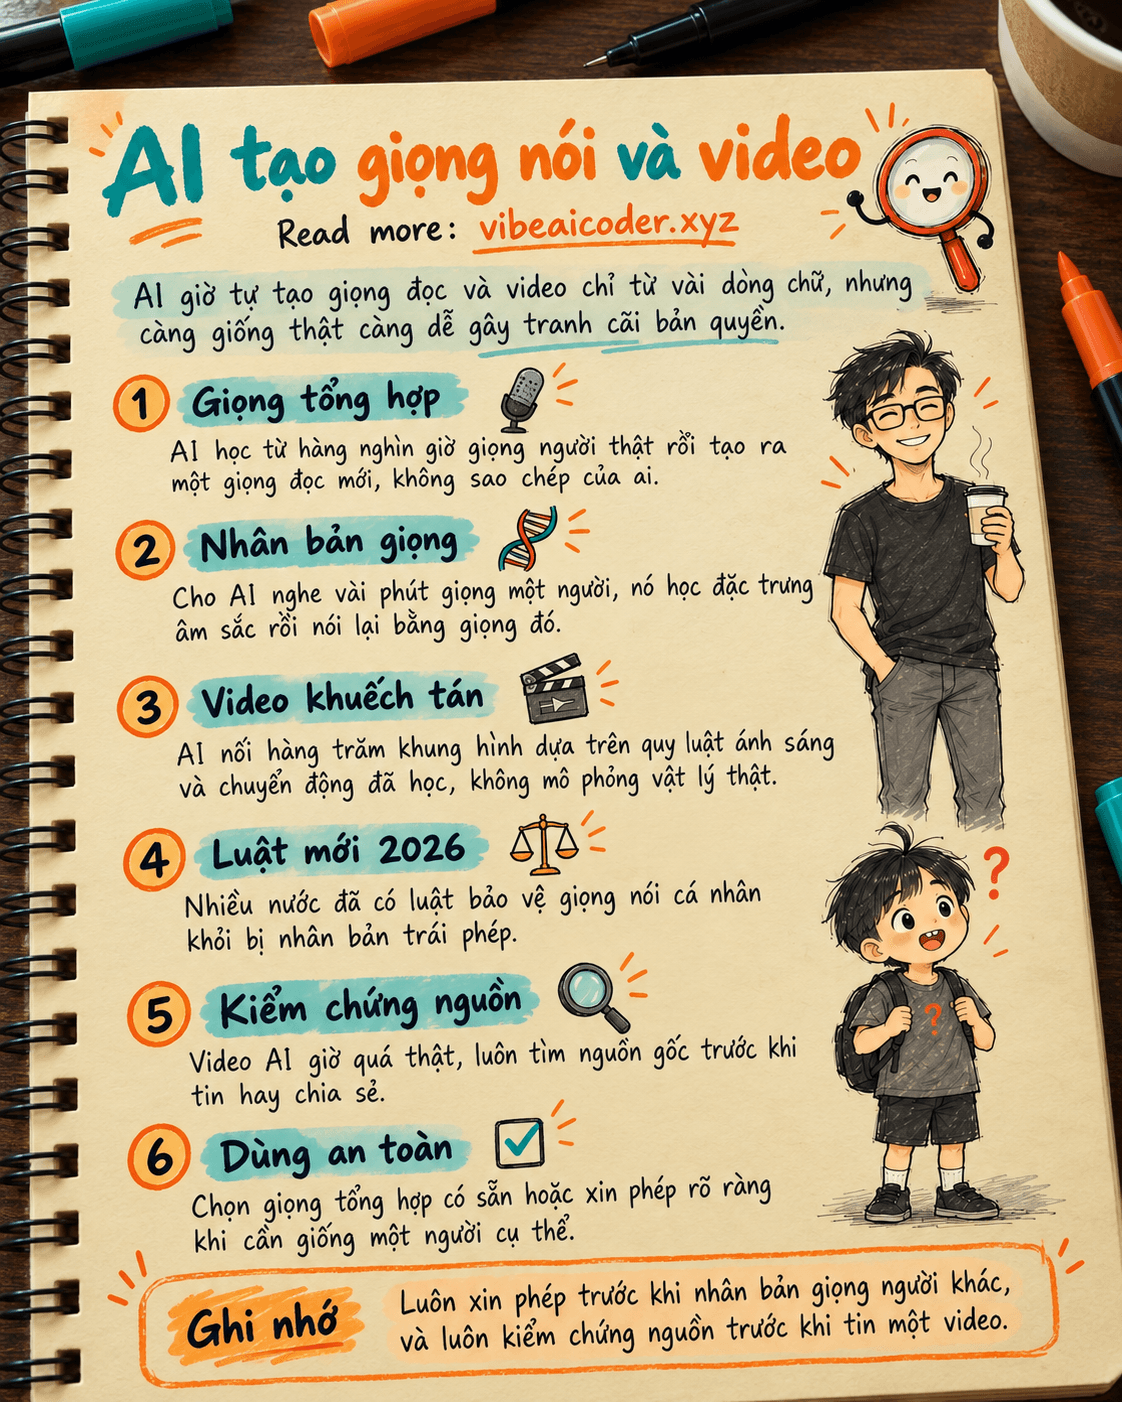
- Học từ dữ liệu giọng nói thật. Mô hình tạo giọng (text to speech, viết tắt TTS) được huấn luyện trên hàng nghìn giờ ghi âm người thật, học cách phát âm, nhịp điệu, cách ngắt hơi giữa các câu, chứ không ghi nhớ một bản ghi âm cụ thể nào.
- Tổng hợp một giọng "trung tính". Khi bạn chỉ cần một giọng đọc nghe tự nhiên, mô hình tạo ra một giọng hoàn toàn mới do máy "phát minh", không thuộc về ai, nên không có vấn đề xin phép.
- Nhân bản giọng khi cần giống một người cụ thể. Nếu cho mô hình nghe vài phút giọng của một người, nó học được đặc trưng âm sắc riêng (cao độ, tông giọng, cách nhấn nhá) rồi có thể "nói" bất kỳ câu nào bằng giọng đó, đây là phần nhạy cảm nhất về pháp lý.
- Video dùng công nghệ khuếch tán (diffusion), tương tự AI tạo ảnh đã nói ở bài trước, nhưng thêm chiều thời gian. Model học cách hàng trăm khung hình nối tiếp nhau mượt mà, giữ ánh sáng và vị trí vật thể nhất quán từ khung này sang khung khác.
- Model "hiểu" vật lý ở mức đoán xác suất, không mô phỏng thật. Nó biết quả bóng thường rơi nhanh dần vì đã thấy điều đó lặp lại rất nhiều lần trong dữ liệu, chứ không tính toán công thức vật lý, nên những cảnh phức tạp (nhiều người, chuyển động nhanh, tay cầm vật nhỏ) vẫn hay bị sai lệch, méo hình.
 Điều này có ý nghĩa gì với bạn
- Khi cần giọng đọc cho video học tập hay podcast, hãy chọn một giọng tổng hợp có sẵn trong các công cụ như ElevenLabs thay vì nhân bản giọng một người cụ thể, bạn đã có hướng dẫn chi tiết trong bài ElevenLabs là gì, cách tạo giọng đọc AI tiếng Việt. Cách này vừa nhanh vừa không vướng vấn đề xin phép.
- Nếu muốn nhân bản giọng của chính mình, của sếp, hay của một người nổi tiếng để làm nội dung, hãy xin sự đồng ý rõ ràng bằng văn bản trước khi làm, vì nhiều nước đã có luật riêng cho việc này (xem phần hiểu lầm bên dưới).
- Khi lướt mạng xã hội và thấy một video "quá thật" của một nhân vật nổi tiếng nói điều gì đó gây sốc, hãy coi đó là tín hiệu để kiểm tra nguồn trước khi tin hay chia sẻ, vì video AI bây giờ có thể khớp môi, ánh sáng và giọng nói đồng bộ gần như hoàn hảo. Đây cũng là một dạng mở rộng của đa phương thức (multimodal) mà AI đang làm được.
 Hiểu lầm thường gặp
- "Giọng AI nghe thật nghĩa là nó đang phát lại bản ghi âm của ai đó." Sai. Phần lớn giọng tổng hợp là âm thanh hoàn toàn mới do mô hình tạo ra từ những gì đã học, không phải cắt ghép từ bản ghi âm có thật nào.
- "Video do AI tạo ra là bằng chứng đáng tin." Sai, và ngày càng sai hơn. Công nghệ deepfake hiện đủ thật để đánh lừa mắt thường, nên một video dù trông thuyết phục đến đâu vẫn cần được kiểm chứng từ nguồn gốc, giống cách bạn kiểm chứng câu trả lời của AI bằng cách tìm nguồn gốc rõ ràng.
- "Chỉ cần vài giây giọng mẫu là có thể nhân bản thoải mái, không ai bắt được." Sai. Năm 2026, nhiều nơi đã siết chặt luật: tiểu bang Tennessee (Mỹ) có đạo luật ELVIS bảo vệ giọng nói và hình ảnh của nghệ sĩ khỏi bị nhân bản trái phép, dự luật liên bang NO FAKES Act đang được xem xét để tạo quyền khởi kiện khi giọng bị sao chép không xin phép, còn Liên minh châu Âu từ tháng 8 năm 2026 đã yêu cầu nội dung giọng nói tổng hợp phải được gắn nhãn minh bạch. Nhiều vụ kiện lớn, như vụ hãng khởi nghiệp Lovo bị các diễn viên lồng tiếng kiện vì nhân bản giọng không xin phép, cho thấy đây không còn là vùng xám.
 Câu hỏi thường gặp
AI tạo giọng nói có bắt buộc phải có giọng mẫu không? Không. Bạn có thể chọn một giọng tổng hợp có sẵn trong công cụ (không thuộc về ai) để đọc bất kỳ văn bản nào, chỉ khi muốn giống một người cụ thể mới cần giọng mẫu của người đó.
Nhân bản giọng của người khác mà không xin phép có vi phạm pháp luật không? Tùy quốc gia và mục đích sử dụng, nhưng xu hướng năm 2026 là ngày càng nhiều luật bảo vệ quyền với giọng nói cá nhân, nên an toàn nhất là luôn xin sự đồng ý rõ ràng trước khi nhân bản giọng ai đó, kể cả người quen.
Làm sao biết một đoạn video là do AI tạo ra? Để ý các dấu hiệu như chuyển động tay, ngón tay bất thường, ánh sáng không nhất quán giữa các khung hình, hoặc tìm xem nội dung có được gắn nhãn minh bạch theo quy định mới hay không. Cách chắc chắn hơn là tìm nguồn gốc chính thức của video đó.
Dùng AI tạo giọng đọc cho video của mình có an toàn về mặt pháp lý không? Có, nếu bạn dùng giọng tổng hợp do nền tảng cung cấp (không sao chép giọng người thật) hoặc đã xin phép rõ ràng khi muốn dùng giọng của một người cụ thể.
AI tạo video đã làm được phim dài như phim thật chưa? Chưa. Các công cụ hàng đầu hiện chỉ tạo được clip ngắn, thường vài chục giây đến vài phút, và vẫn gặp khó khi mô tả cảnh phức tạp nhiều người hay chuyển động nhanh, nên vẫn cần con người dựng và ghép lại để ra một video hoàn chỉnh.
#AI #TríTuệNhânTạo #GiọngNóiAI #VideoAI #BảnQuyềnAI #KiếnThứcAI
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
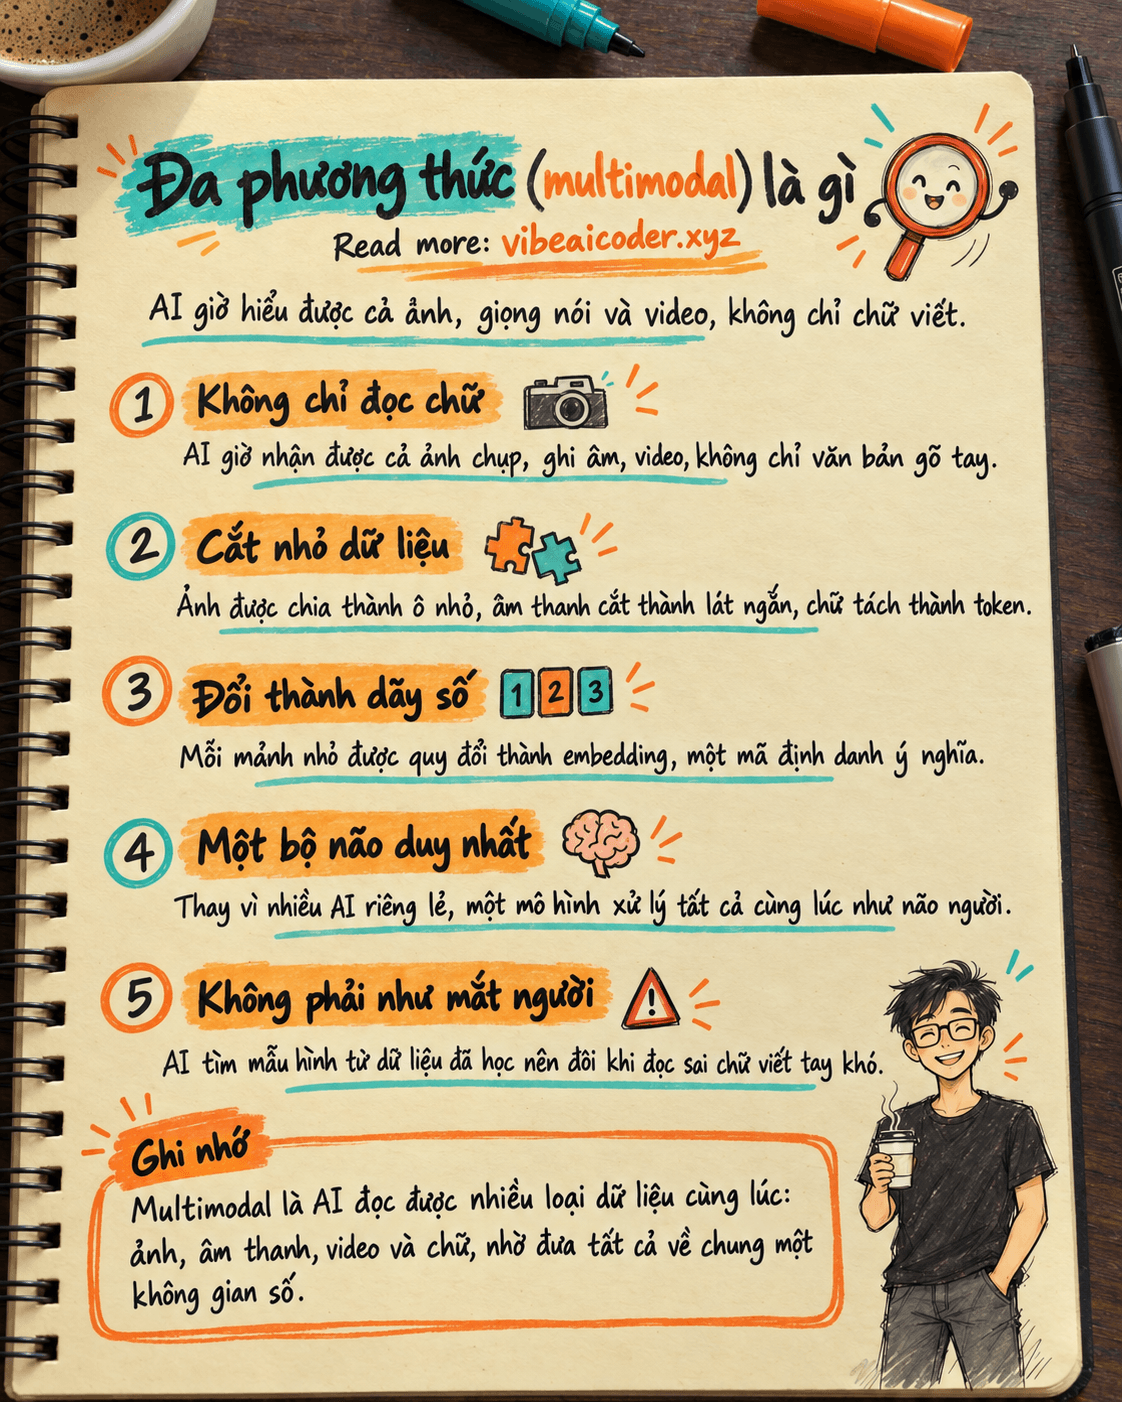
 Đa phương thức (multimodal) là gì? AI giờ đọc ảnh, nghe giọng nói, xem video