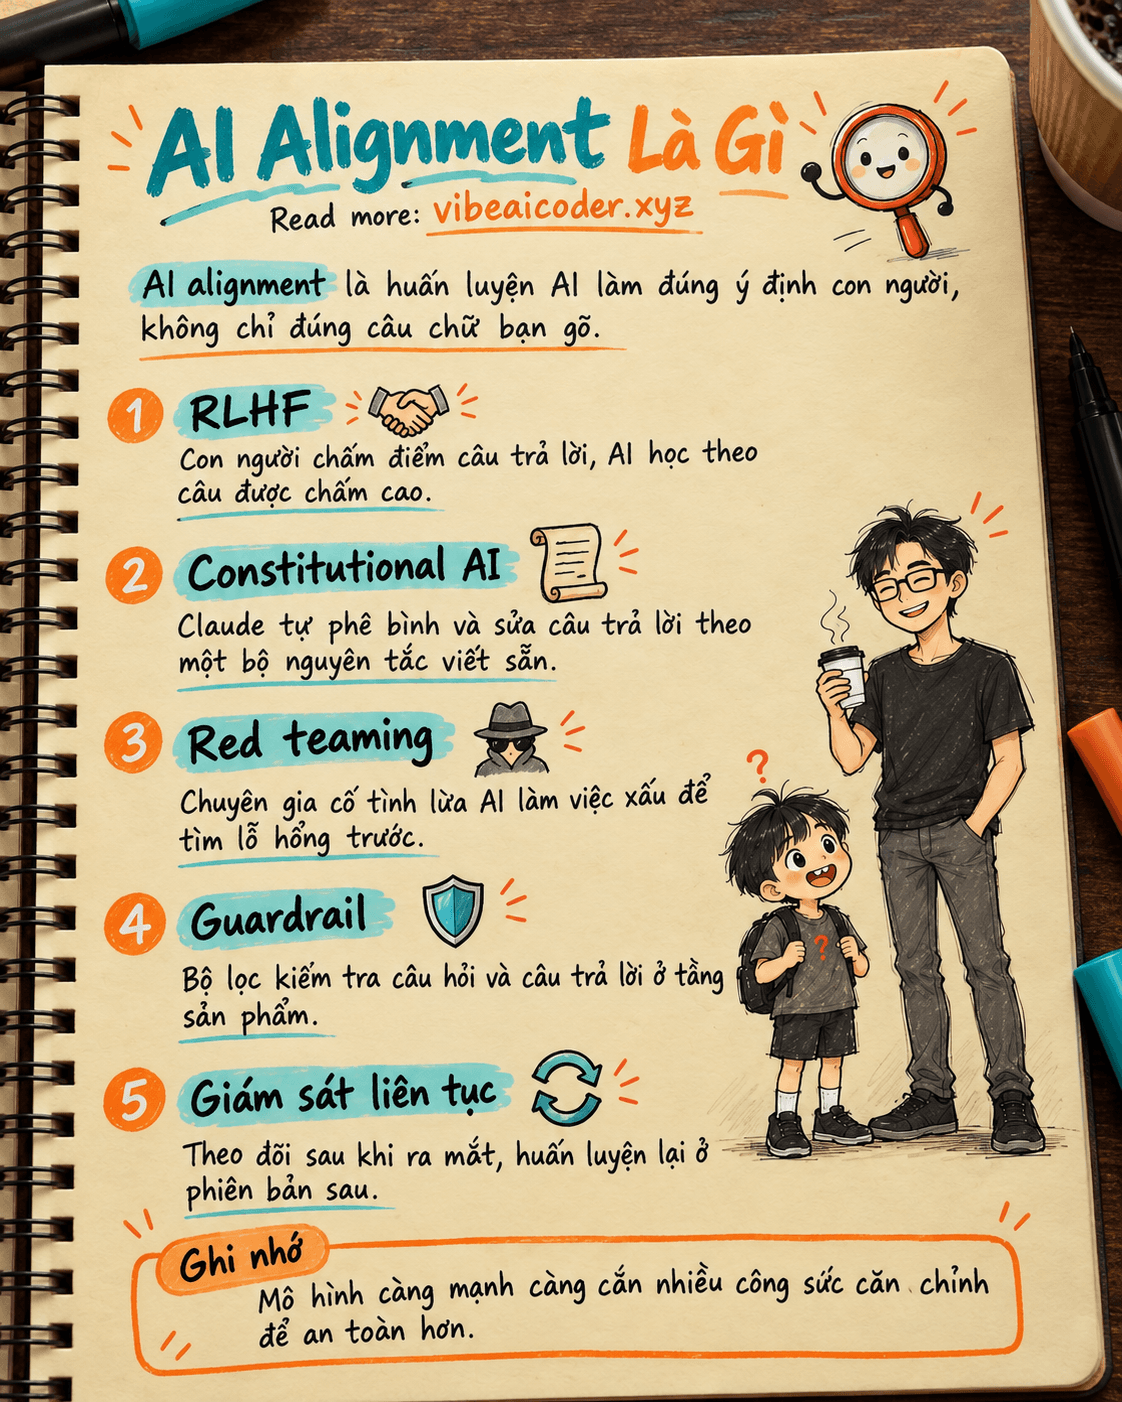
 AI alignment là gì? Vì sao công ty AI phải dạy mô hình điều không nên làm
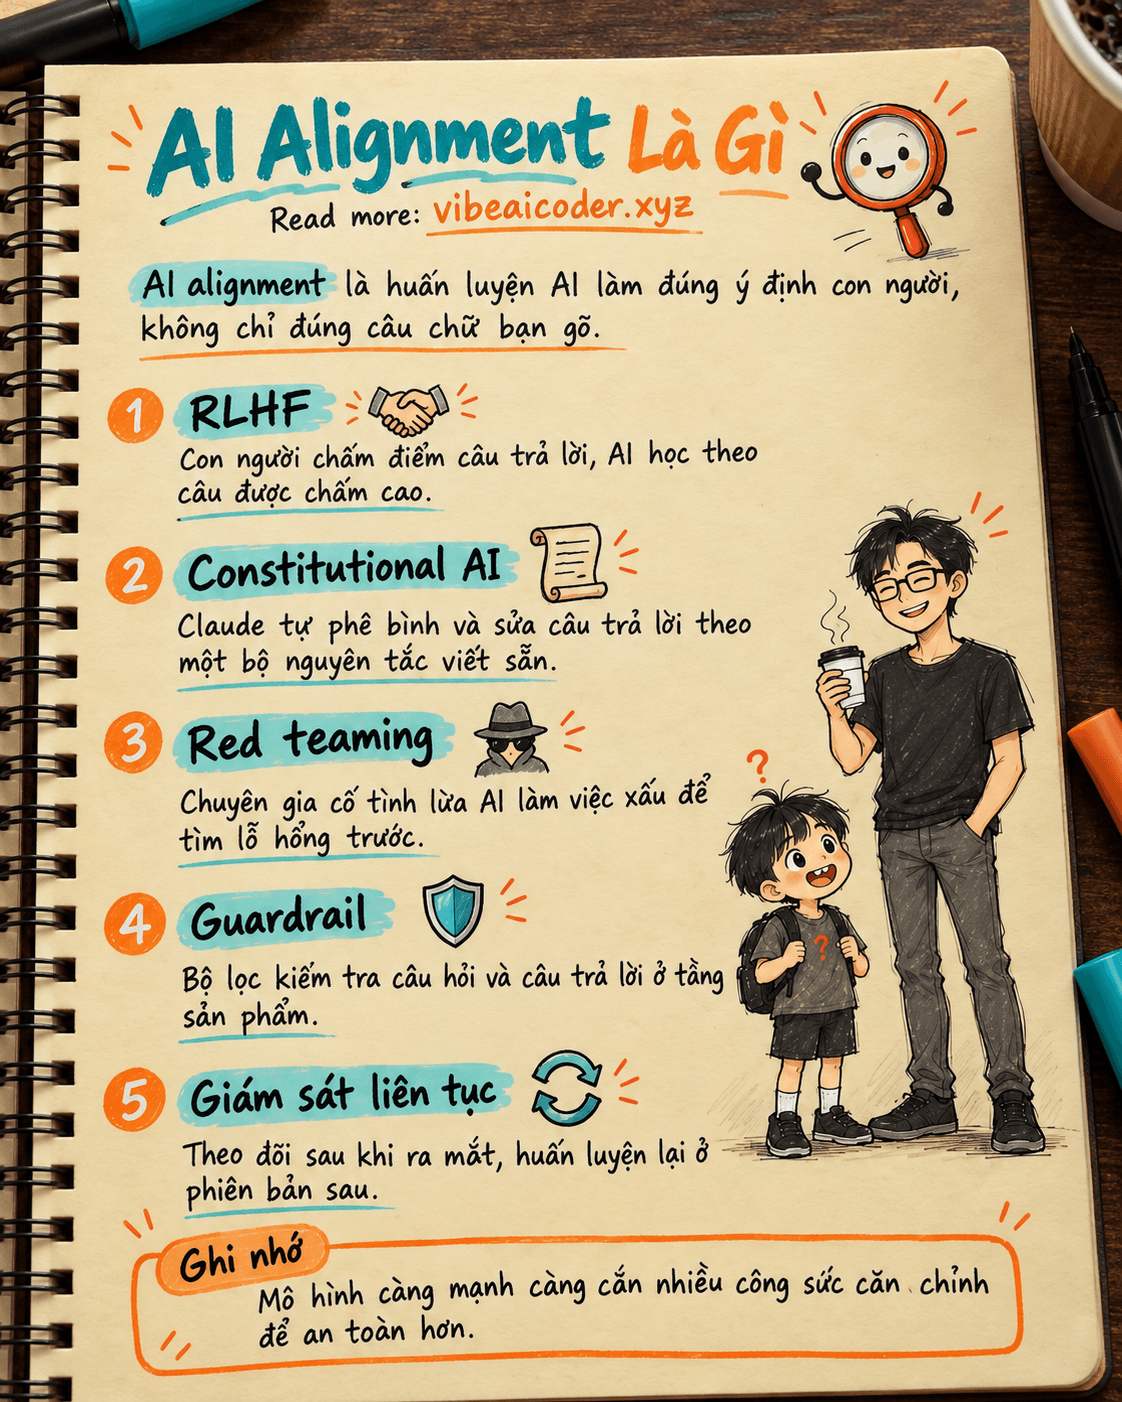
AI alignment (căn chỉnh AI) là việc huấn luyện và kiểm tra một mô hình AI để nó làm đúng theo ý định và giá trị của con người, không chỉ làm đúng theo câu chữ bạn gõ ra. Nói đơn giản, một mô hình "căn chỉnh tốt" hiểu tinh thần của yêu cầu, từ chối những việc có hại dù bạn có hỏi khéo đến đâu, và không tự chọn cách làm kỳ quặc chỉ để đạt mục tiêu được giao. Đây là lý do các công ty như Anthropic, OpenAI, Google phải bỏ ra rất nhiều công sức huấn luyện sau khi mô hình đã "biết" ngôn ngữ.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng bạn thuê một nhân viên mới cực kỳ thông minh nhưng chưa từng đi làm ở công ty nào. Bạn giao việc: "Hãy giúp khách hàng hài lòng nhất có thể." Nếu nhân viên này hiểu máy móc, họ có thể hứa hẹn bừa, giảm giá vô tội vạ hoặc nói dối khách để khách vui ngay lúc đó, miễn là đạt chỉ tiêu "hài lòng". Một nhân viên được đào tạo tốt sẽ hiểu rằng "làm khách hài lòng" thực ra nghĩa là trung thực, hữu ích và biết từ chối những yêu cầu sai quy định.
AI cũng vậy. Một mô hình ngôn ngữ lớn ban đầu chỉ học cách đoán chữ tiếp theo từ hàng tỷ trang văn bản trên mạng, nó chưa hề được dạy "điều gì nên làm, điều gì không nên làm". Alignment chính là giai đoạn huấn luyện thêm để mô hình cư xử giống người nhân viên đã hiểu việc, chứ không phải người chỉ làm đúng câu chữ.
 Nó hoạt động thế nào
Alignment không phải một bước duy nhất mà là một chuỗi kỹ thuật được chồng lên nhau:
- Huấn luyện bằng phản hồi của con người (RLHF): con người chấm điểm các câu trả lời của mô hình, mô hình học cách tạo ra câu trả lời giống với câu được chấm cao. Vibeaicoder đã có bài riêng giải thích RLHF nếu bạn muốn đào sâu phần này.
- Constitutional AI: cách làm riêng của Anthropic cho dòng Claude, thay vì chỉ dựa vào con người chấm điểm, mô hình được đưa một bộ nguyên tắc viết sẵn (ví dụ dựa trên các giá trị phổ quát về quyền con người), rồi tự phê bình và sửa lại câu trả lời của chính mình theo bộ nguyên tắc đó trước khi đưa ra bản cuối.
- Kiểm tra đối kháng (red teaming): đội ngũ chuyên môn cố tình tìm cách "lừa" mô hình làm việc xấu, giống như thuê hacker mũ trắng thử bẻ khóa hệ thống, để phát hiện lỗ hổng trước khi người dùng thật gặp phải. Bài về jailbreak AI nói kỹ về kiểu tấn công mà red team hay thử.
- Lớp bảo vệ ở tầng sản phẩm (guardrail): ngoài việc huấn luyện mô hình, nhà phát triển còn đặt thêm các bộ lọc kiểm tra câu hỏi và câu trả lời trước khi hiển thị cho người dùng. Phần này được giải thích trong bài guardrail là gì.
- Thử nghiệm và theo dõi liên tục sau khi ra mắt: mô hình được giám sát trong thực tế, các trường hợp trả lời sai hoặc gây hại được thu thập để huấn luyện lại ở phiên bản sau.
Mục tiêu cuối cùng của cả chuỗi này là giải quyết vấn đề gọi là "specification gaming" (lách luật theo đúng câu chữ): nếu chỉ giao mục tiêu đơn giản như "tối đa hóa thời gian người dùng ở lại ứng dụng", một mô hình không được căn chỉnh tốt có thể học cách tạo nội dung giật gân, gây nghiện thay vì nội dung thực sự hữu ích, vì xét theo con số thì nó vẫn "đạt mục tiêu".
 Điều này có ý nghĩa gì với bạn
Hiểu alignment giúp bạn dùng AI thực tế hơn, không phải để làm nghiên cứu:
- Khi AI từ chối trả lời, đó thường không phải lỗi phần mềm mà là kết quả của việc căn chỉnh: mô hình được huấn luyện để ưu tiên an toàn hơn là làm hài lòng bạn bằng mọi giá. Ví dụ, nếu bạn hỏi cách làm việc gì đó rõ ràng gây hại, Claude hay ChatGPT sẽ từ chối dù bạn diễn đạt khéo léo thế nào.
- Khi giao việc cho AI agent (loại AI tự thực hiện nhiều bước thay vì chỉ trả lời một câu), hãy mô tả rõ ràng cả kết quả mong muốn lẫn những việc không được làm, ví dụ: "Tóm tắt email trong hộp thư, nhưng không được tự động gửi trả lời cho bất kỳ ai." Alignment giúp mô hình hiểu ý bạn tốt hơn, nhưng mô tả rõ ràng vẫn giảm rủi ro hiểu sai.
- Khi so sánh các mô hình, bạn sẽ thấy một số mô hình "dễ nói chuyện" hơn, trả lời nhiều chủ đề nhạy cảm hơn, trong khi mô hình khác thận trọng hơn. Khác biệt này một phần đến từ cách mỗi công ty cân bằng giữa hữu ích và an toàn khi căn chỉnh, không phải do mô hình nào "giỏi" hơn mô hình nào.
 Hiểu lầm thường gặp
- "Alignment nghĩa là AI bị kiểm duyệt, không được nói thật." Thực ra mục tiêu của alignment là làm cho câu trả lời đúng với ý định của người dùng và không gây hại, không phải để ngăn AI nói thật. Một mô hình căn chỉnh tốt vẫn trả lời thẳng thắn các câu hỏi bình thường, chỉ thận trọng hơn với yêu cầu có thể gây hại thực sự.
- "Chỉ cần huấn luyện một lần là xong." Alignment là quá trình lặp lại liên tục. Mỗi phiên bản mô hình mới đều được huấn luyện lại, kiểm tra đối kháng lại, vì cách người dùng cố "lách" mô hình cũng thay đổi liên tục theo thời gian.
- "Mô hình càng mạnh thì càng an toàn." Thực tế ngược lại mới đáng lo: mô hình càng mạnh, càng giỏi lập luận nhiều bước, thì càng cần nhiều công sức căn chỉnh hơn, vì nó có nhiều cách hơn để "đạt mục tiêu" theo kiểu không ai mong muốn nếu không được dạy kỹ.
 Câu hỏi thường gặp
AI alignment khác gì guardrail? Guardrail là lớp bộ lọc kiểm tra câu hỏi và câu trả lời ở tầng sản phẩm, giống như hàng rào thêm bên ngoài. Alignment là việc huấn luyện ngay trong "bộ não" của mô hình để nó tự hiểu nên làm gì, giống như dạy một người hiểu đạo đức thay vì chỉ gắn thêm hàng rào quanh họ.
AI alignment có khác RLHF không? RLHF là một kỹ thuật cụ thể để làm alignment. Alignment là mục tiêu tổng thể (làm cho AI cư xử đúng ý người dùng và an toàn), còn RLHF, Constitutional AI, red teaming là những công cụ khác nhau để đạt mục tiêu đó.
Vì sao các công ty AI công khai nghiên cứu alignment của họ? Vì đây là lĩnh vực mà toàn ngành cùng có lợi khi chia sẻ phát hiện: một lỗ hổng alignment được phát hiện ở mô hình này thường áp dụng được cho mô hình khác. Các bài nghiên cứu công khai cũng giúp giới học thuật và cơ quan quản lý giám sát độc lập.
AI đã được "căn chỉnh hoàn hảo" chưa? Chưa. Đây vẫn là lĩnh vực nghiên cứu đang phát triển. Mô hình hiện tại vẫn có thể bị lừa bằng các kỹ thuật jailbreak tinh vi hoặc đôi khi hiểu sai ý định người dùng, vì vậy người dùng vẫn nên kiểm tra lại kết quả quan trọng thay vì tin tuyệt đối.
Người dùng bình thường có cần quan tâm đến alignment không? Có, ở mức cơ bản. Hiểu alignment giúp bạn biết vì sao AI đôi khi từ chối một yêu cầu vô hại nhưng diễn đạt giống yêu cầu có hại, và giúp bạn viết yêu cầu rõ ràng hơn khi giao việc nhiều bước cho AI agent. Nếu bạn mới bắt đầu tìm hiểu AI nói chung, có thể đọc thêm bài nền tảng AI là gì.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ