生成式AI的4个特性:准确命名错误才能正确修复
 生成式AI的4个特性:准确命名错误才能正确修复
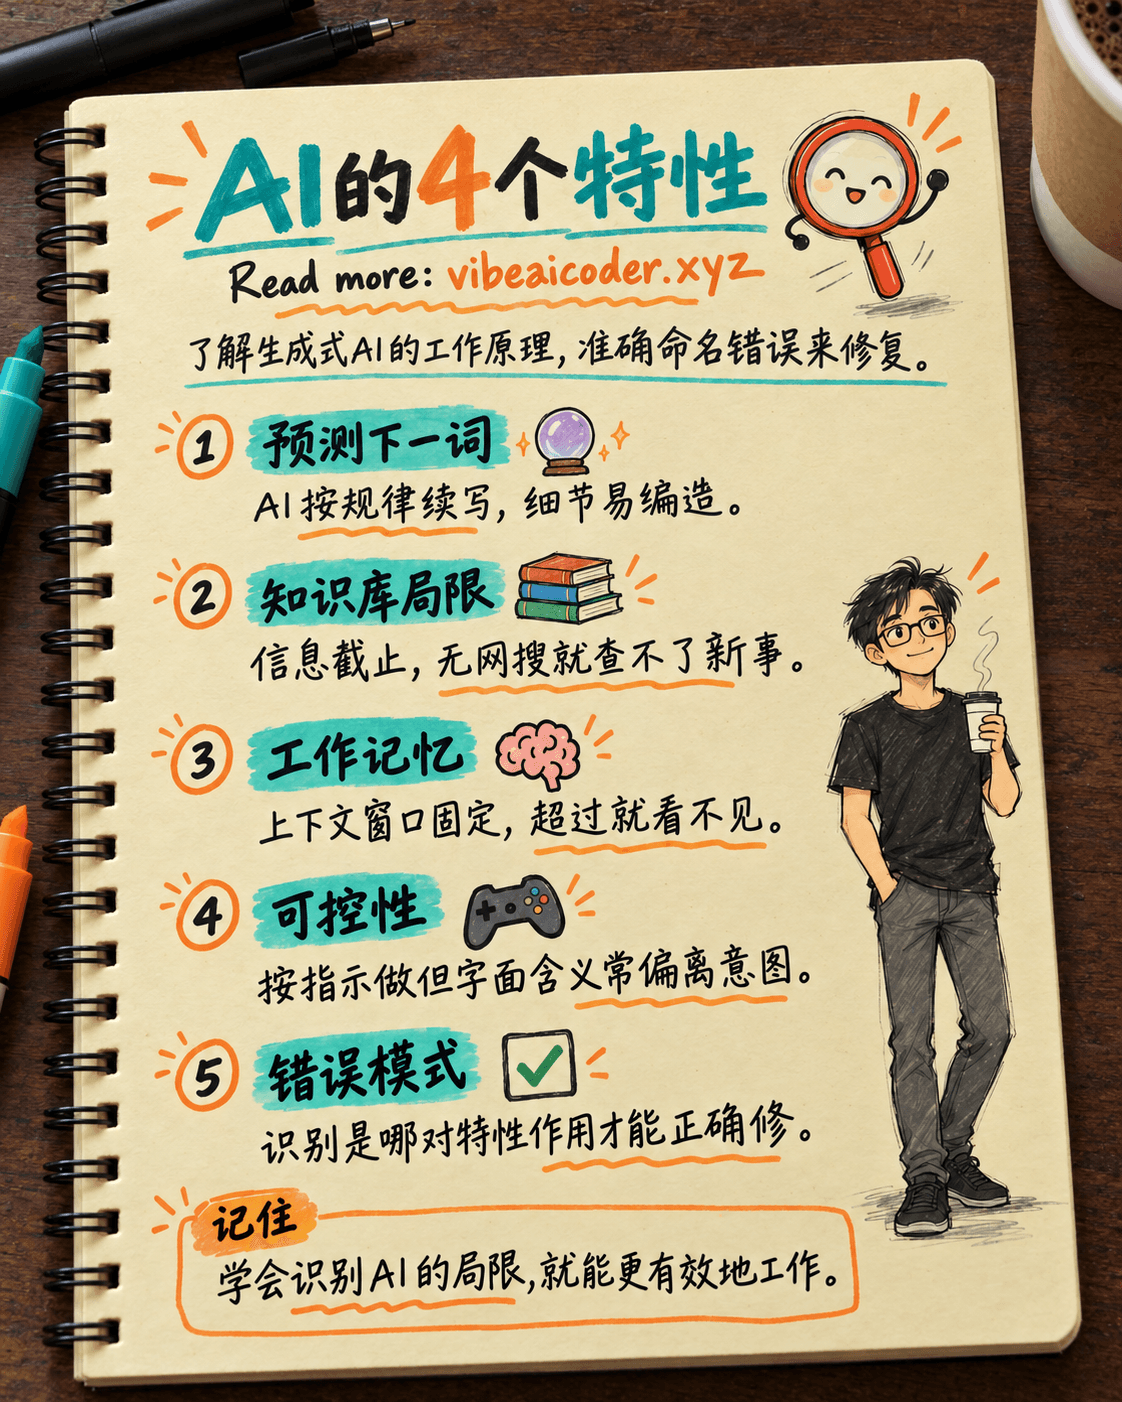
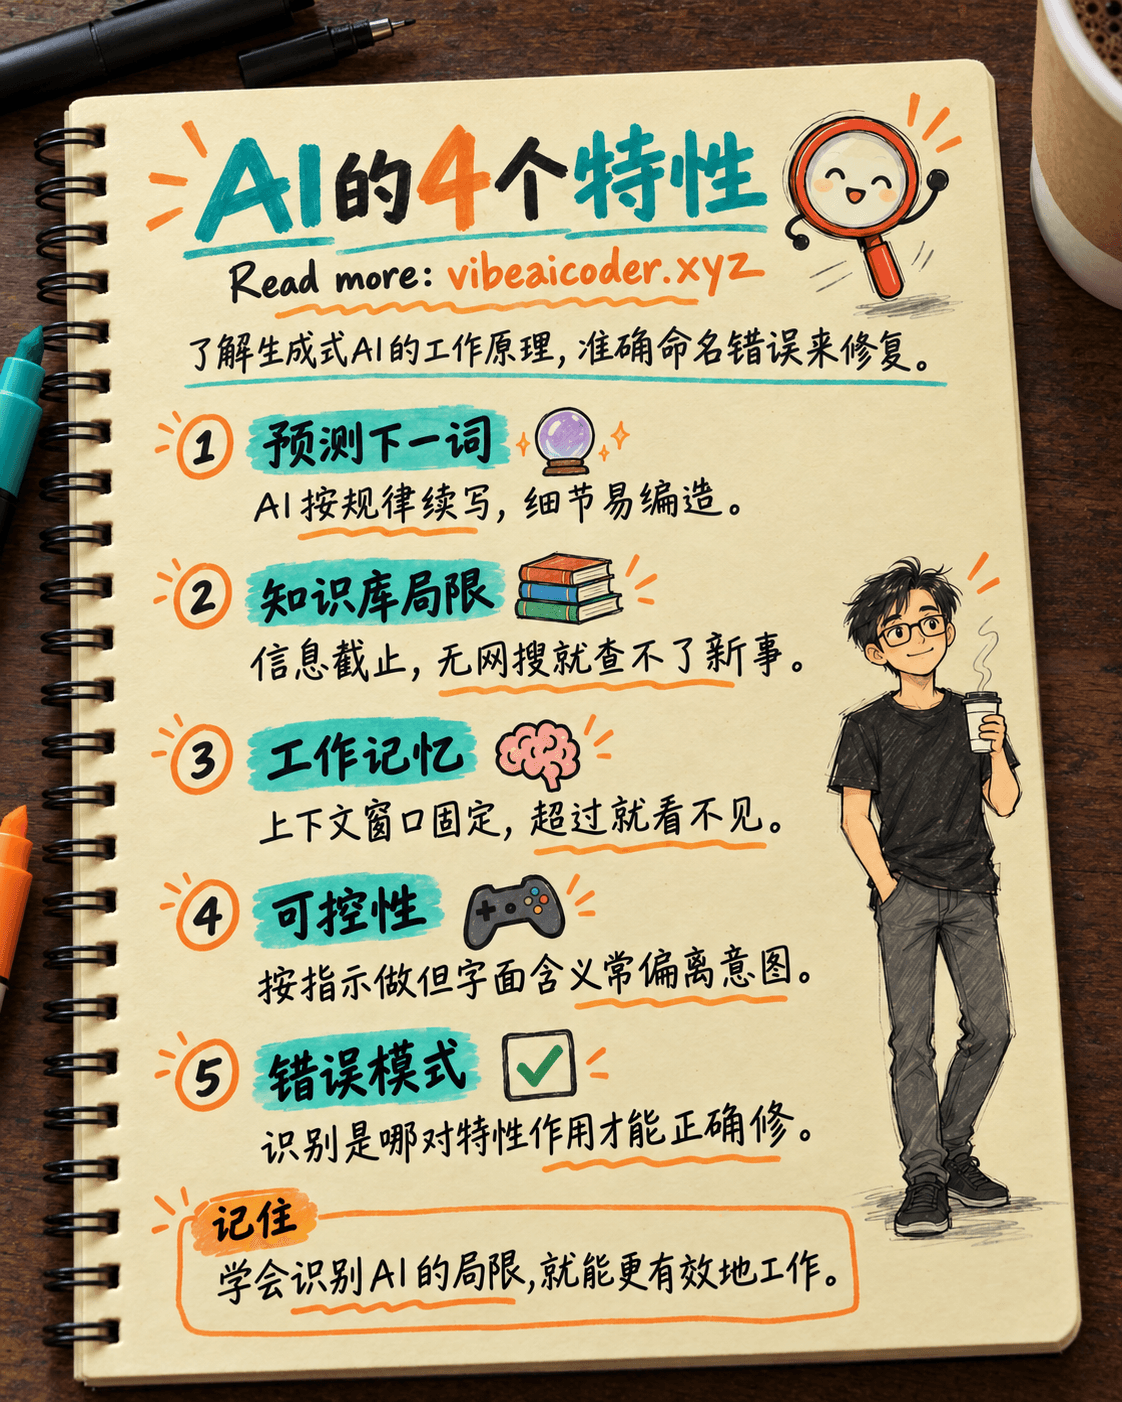
生成式AI的每一种行为,从在几秒内总结厚重报告到编造根本不存在的引语,都源自四个特性:预测下一个词、知识库、工作记忆和可控性。每个特性都是一个范围,一端是能力,另一端是局限,同一个机制同时产生了两端。了解这四个特性,当AI给出错误答案时,你就能准确指出问题并选择正确的修复方法,而不是按"重试"按钮碰运气。
最值得的是:这四个特性在模型更新后保持不变。边界会移动得更远,但形状仍然相同。如果你是AI新手,先看什么是AI了解基础概念,然后再深入这部分更高阶的内容。
 用日常例子快速理解
想象一个朋友读过几乎整个图书馆,能流畅地谈论任何话题,但是:
- 他讲故事时靠记忆和故事流畅性,不会打开书查。熟悉的故事讲得很准,陌生的故事有时"编圆了"。
- 他只读到某一年的书,那之后的事他不知道。
- 他一次只在一张小桌子上工作。桌子上的纸能看到,掉下去的就看不到。
- 你说什么,他按字面做,有时理解偏离你的意图。
这四个特点正是生成式AI的四个特性。
 之前:AI的"性格"从哪来
Claude很有礼貌、很乐于帮助、有时过度谨慎。没有什么神奇的,那是两个训练阶段的结果:
- 预训练: AI学会在巨大的文本语料库上预测下一个词。完成这个阶段后它只会续写文本,对帮助你还一无所知。
- 微调: AI被教导把你的信息看作请求、给出相关答案、拒绝有害的事。
微调阶段基于人类对"好"回答的评分,所以留下了四个可见的痕迹在每个模型上:
| 痕迹 | 表现 | 修复方法 |
|---|---|---|
| 太容易同意 | 你说"这个计划肯定没问题"它就跟着夸 | 直接请求反对意见:"发现错误就直说" |
| 说得太冗长 | 一行问题收到三段回答 | 设限:"回答一句话" |
| 过度谨慎 | 在没什么危险的事上也层层设防 | 说清背景和真实风险 |
| 自信不匹配准确度 | 明确地说错话 | 要求附带确信度和来源 |
快速试验:拿个你熟的话题,问三次。第一次正常提问。第二次用错误前提开头,看它会不会反驳。第三次问需要一行答案,看它回答多冗长。
 如何工作:四个特性
1. 预测下一个词
生成式AI更像是一个极其精密的下一个词建议器(像手机键盘的建议,但聪明得多)而不是搜索引擎。它按照什么通常接在什么后面来写。
- 擅长的: 类似它见过很多次的任务:总结、格式转换、解释常见概念。
- 不擅长的: 陌生话题、数据稀少、需要区分"对"和"听起来对"的事情。
最需要记住的一点:编造集中在具体细节上。名字、日期、数字、引语、链接。细节越具体、越罕见,就越容易被"填圆"。这种现象在AI幻觉文章中有详细解释。
自检:选一个你熟的领域,要求AI提五个可验证的数据(三个来源、一个作者、一个数字),然后逐个检查。用同样的请求在新对话中重新运行,对比哪些改变了。改变的部分就是生成词语的随机性。
2. 知识库
AI准确知道的是它训练数据中学过的,在数据截止时间冻结。没有工具支持就查不了什么。
- 擅长的: 流行话题、稳定、被写得一致的东西。
- 不擅长的: 罕见话题、新近的、地方性的、或还有争议的。
四种典型的错误:信息陈旧当新鲜、不同话题间知识不均衡、继承了训练数据中的偏见、不知道知识来自哪。
正确的问题不是"AI知道这个吗"而是**"这个东西在它读过的内容中被写得多充分"**。修复方法:打开网络搜索、接入自己的数据源(像RAG这样)、或自己提供文件。
3. 工作记忆
AI在意的一切都在一个固定大小的地方,叫上下文窗口。里面的东西它看到,外面的看不到。详见什么是上下文窗口。
这个特性与其他三个不同的是它有垂直的悬崖,不是平缓的斜坡。工作得好到某个点然后不好了,通常是在无声中削减,没人告诉你。
两个常被误解的点:
- 把重要指示埋在长文件中间很容易被忽略。放在最前面是另一回事。
- AI不从你纠正它那里学习。它只反应对话中当前有的东西。
4. 可控性
AI通过你的指示做事用的是它做所有事的同一机制:预测下一个词。因此它很容易引导,同时也总有你要什么和它理解什么之间的鸿沟。
- 擅长的: 短指示、具体、可验证的:格式、长度、角色。
- 不擅长的: 长逻辑链、抽象或模糊指示、需要完全准确数学和逻辑的。
两种典型故障:
- 逻辑漂移: 第一步错一点点,到第五步就完全错了。修复方法:插入检查点,第二步停下让你看。
- 字面对,意图偏: 你说"写短一点"但问题其实是结构,所以它截短了但还是很烂。修复方法:说出目标而不是格式。
重复提醒一个指示用更硬的语气填不了字面理解和意图之间的鸿沟。改成明确说目标就能填。论文写有效的提示有很多字面和意图偏的例子。
 这对你意味着什么
实际中,错误很少只由一个特性引起。通常是两个特性在一起。能看出是哪一对就知道怎么改:
| 特性对 | 表现 | 修复方法 |
|---|---|---|
| 预测词 + 知识库 | 编造的细节听起来很真 | 逐个查实每条数据、打开搜索、要求标注来源 |
| 工作记忆 + 可控性 | 长对话偏离原始请求 | 重复请求、插入检查点、或开新对话 |
| 可控性 + 预测词 | 计算错但格式完美 | 把计算转移到表格或代码,让真正的计算器算 |
| 知识库 + 容易同意 | 你错了它也确认你对 | 邀请反驳、用中立措辞重新问 |
三个实际应用例子:
把格式变成目标。 代替"再写短一点",写:
写短一点。目标:总经理一分钟内读完还抓到结论和关键数字。
用中立提问避免容易同意。 代替"这个计划完全没问题对吧",问:"列出这个计划最大的三个弱点,按风险排。"
不要让AI在脑子里算。 工资单、报价单、数字财务的,命令AI写表格公式,让表格算。
结论实用智慧:信任有修订。别用开关式的信任AI或不信。在它擅长的领域快速扫过就能用。在它碰到具体、新、长、或多步的就要内置检查。
 常见误解
误解1:" AI像Google一样查。" 真实:没有搜索工具的话AI不查什么。它从学过的东西写回答,所以可能"记错"很有信心。
误解2:"我改一次它就记得。" 真实:AI不从你的修改学。它只对当前对话里的东西反应。要让它记得,得放进对话、记忆系统、或固定指示。
误解3:"新模型就没这些问题了。" 真实:新模型把界限推远了,但四个特性还在。检查习惯对所有模型都有用。
 常见问题
生成式AI的四个特性是什么? 预测下一个词、知识库(有截止时间)、工作记忆(上下文窗口有限)和可控性(按指示但有理解差距)。
为什么AI最容易在名字、数字、链接上编造? 因为它生词的逻辑。细节越具体、越罕见,就越容易被"填合适"。这是检查最严的地方。
为什么AI总同意我? 这是微调阶段的痕迹,基于人类评分偏好。直接请求它反对来打破这个。
怎样让AI更多地做出我想要的? 说出目标而不是格式,在复杂任务中间插检查,长信息放最前。
新模型能解决这些局限吗? 不是完全解决。边界移远了,但四个特性依然是生成式AI的工作方式。
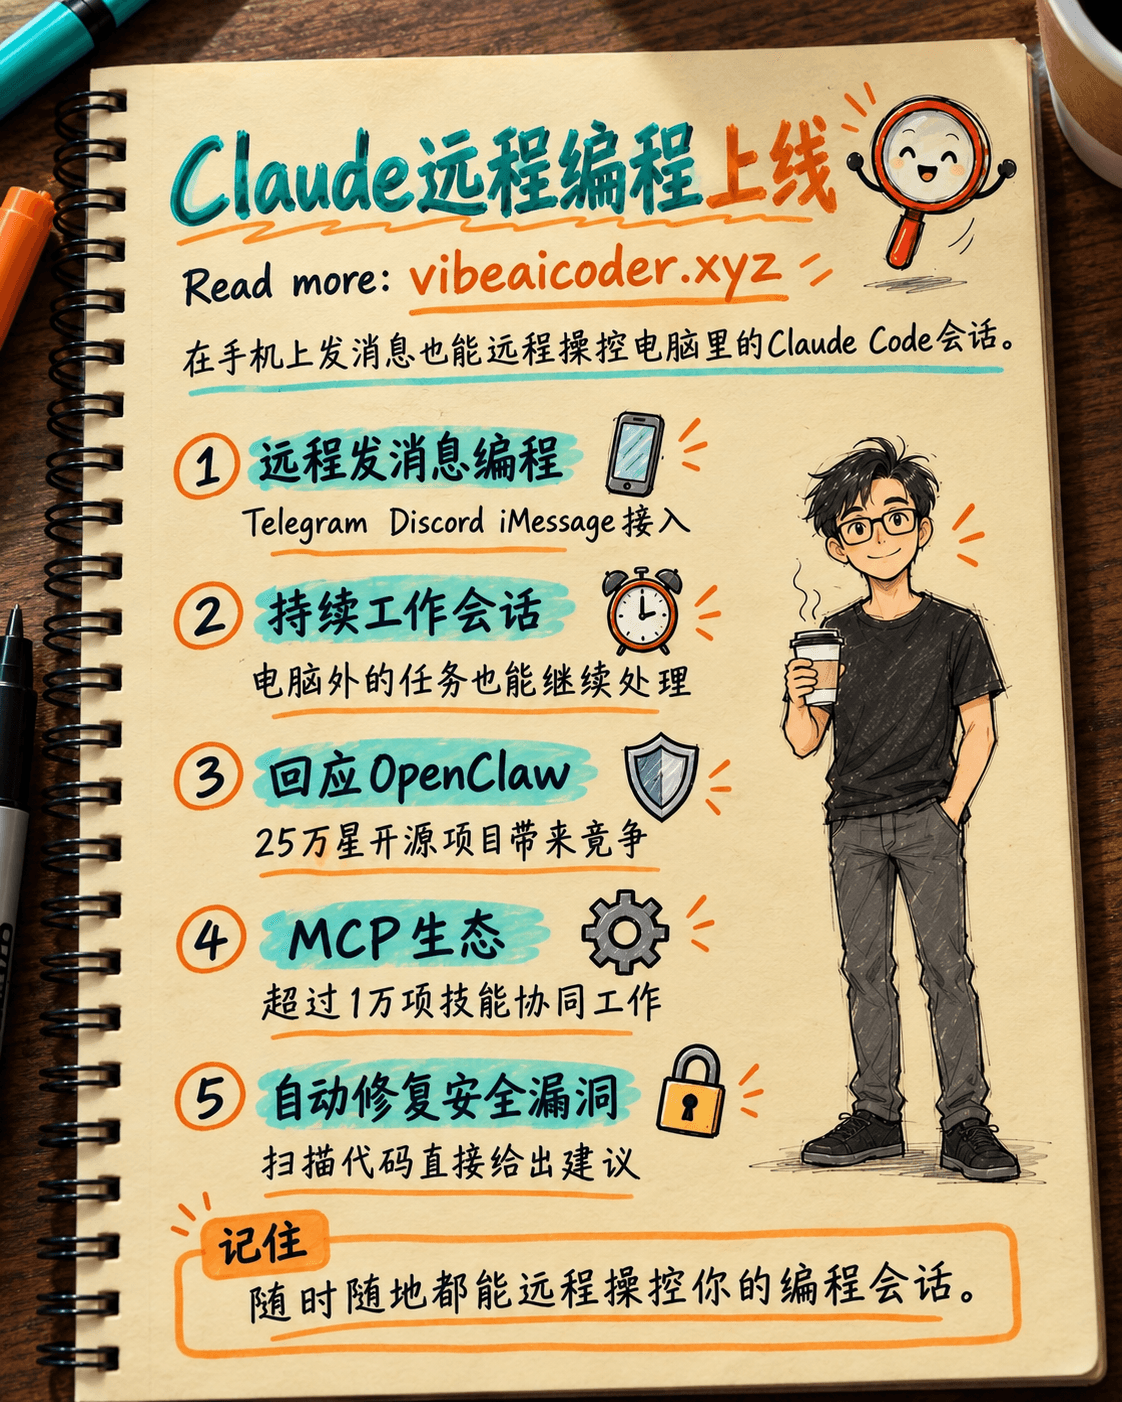
 在咖啡馆也能远程操控家里的代码?Claude Code Channels正式上线!
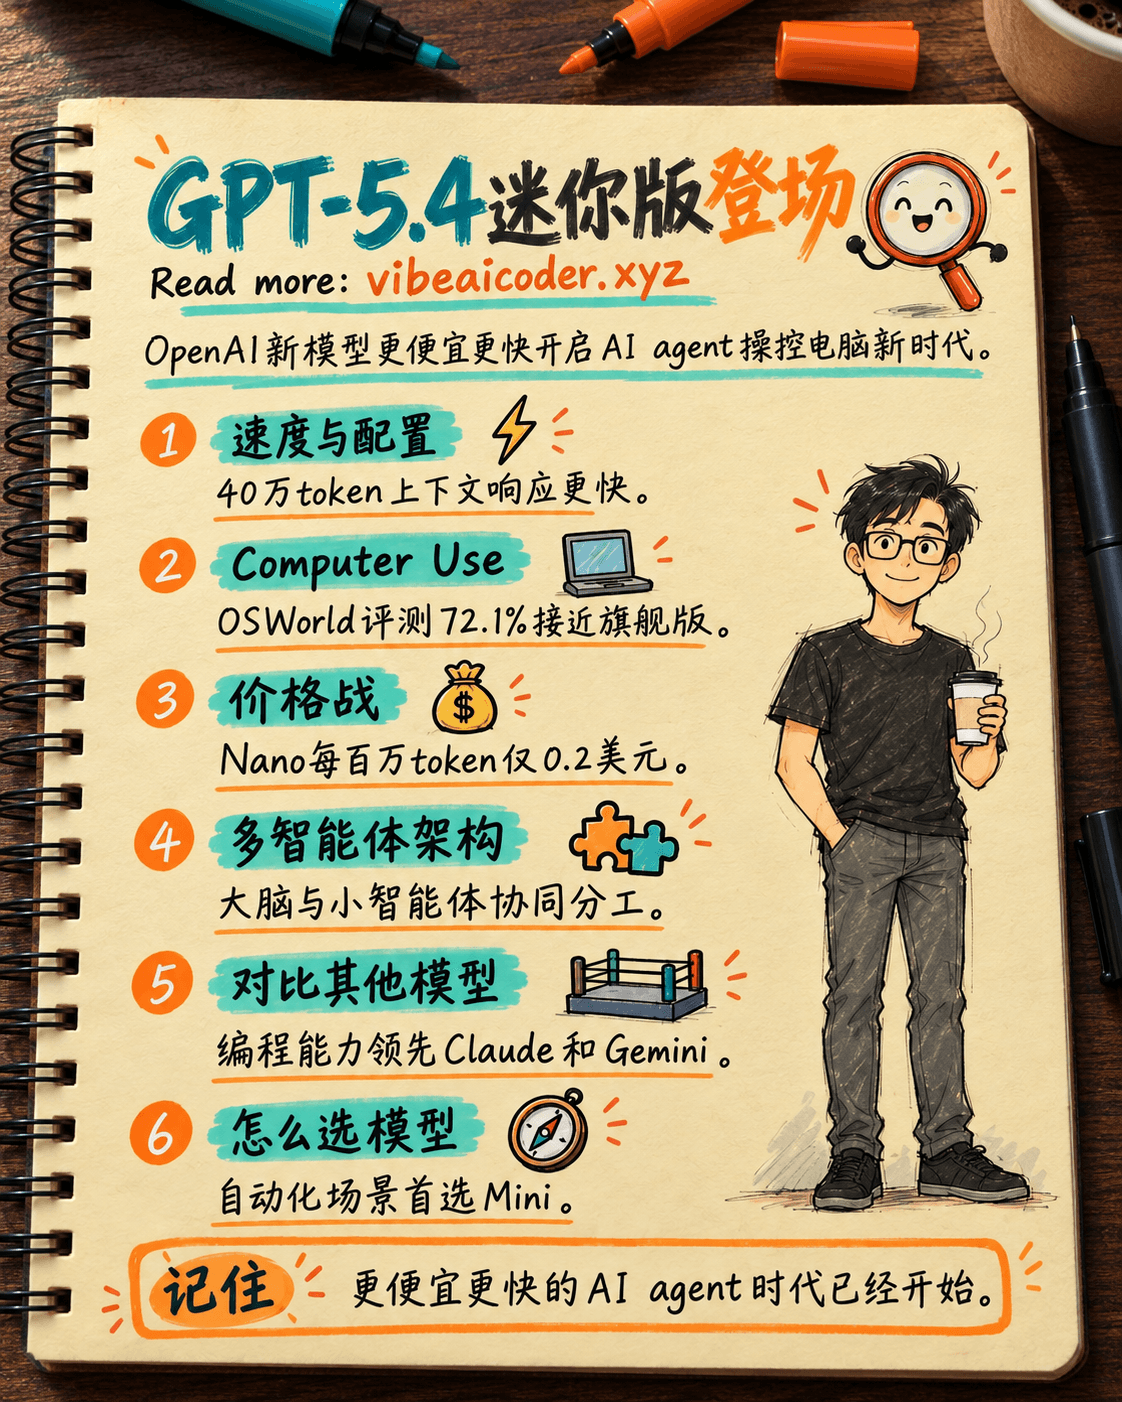
 OpenAI发布GPT-5.4 Mini和Nano:便宜4倍,速度快2倍,AI agent时代到来
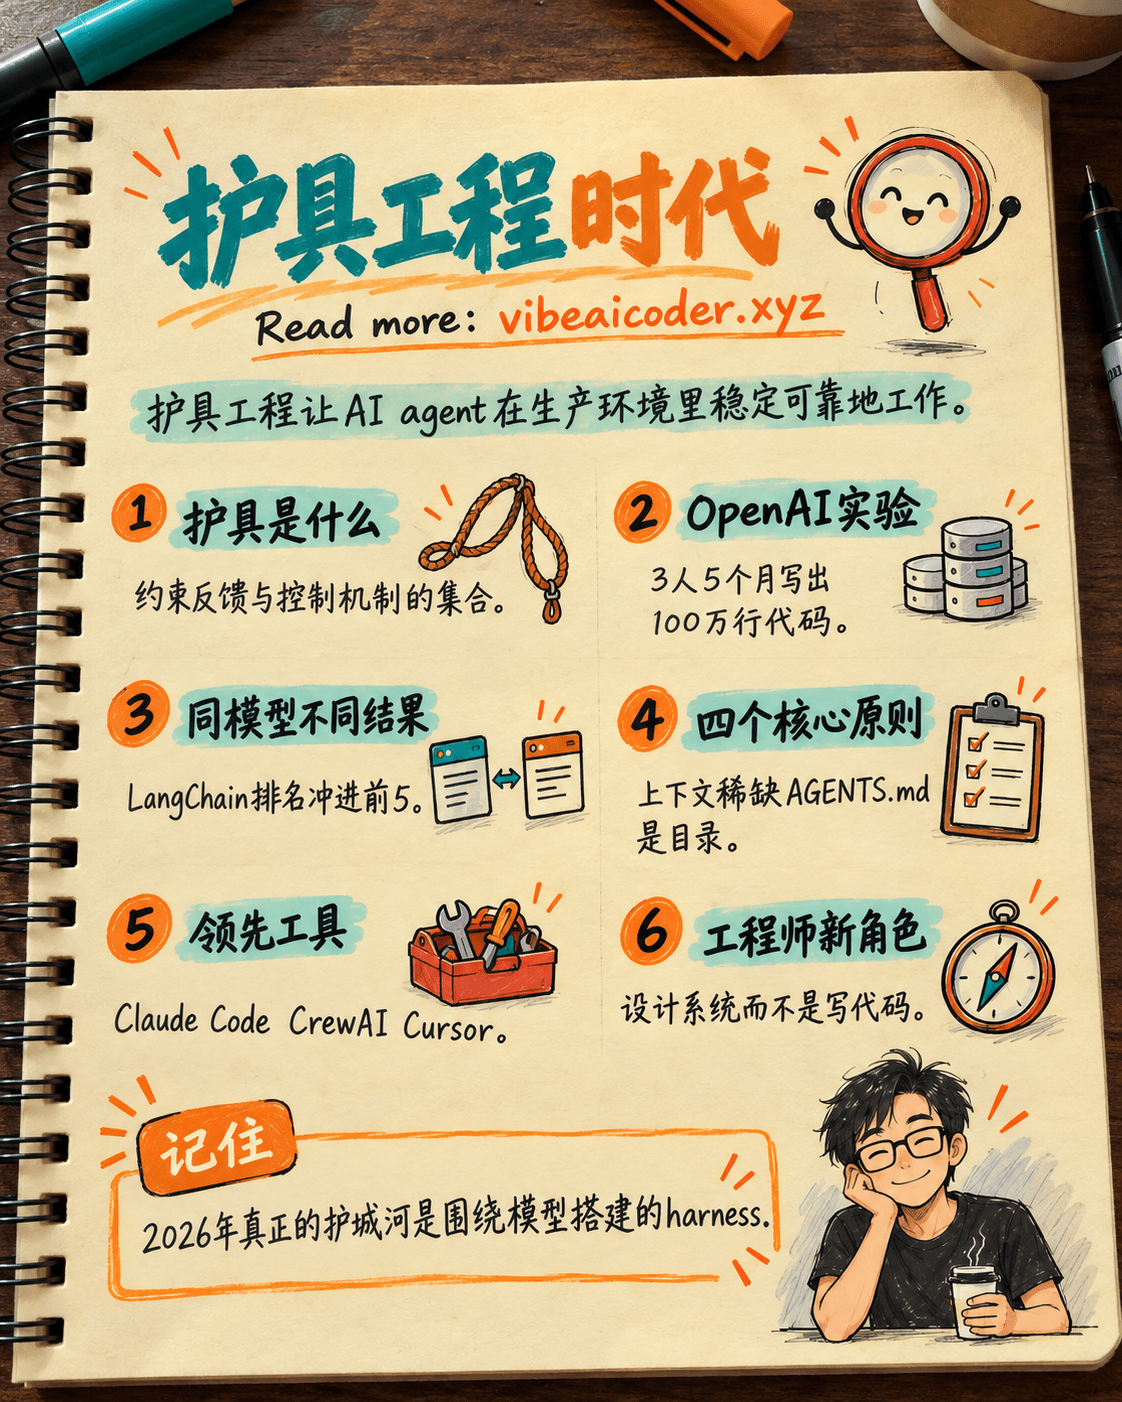
 什么是Harness Engineering?Vibe Coding已死,新时代开始了