Codex Security CLIでリポジトリを検査し、チームで脆弱性の結果を仕分ける方法
Codex Security CLIでリポジトリを検査し、チームで脆弱性の結果を仕分ける方法
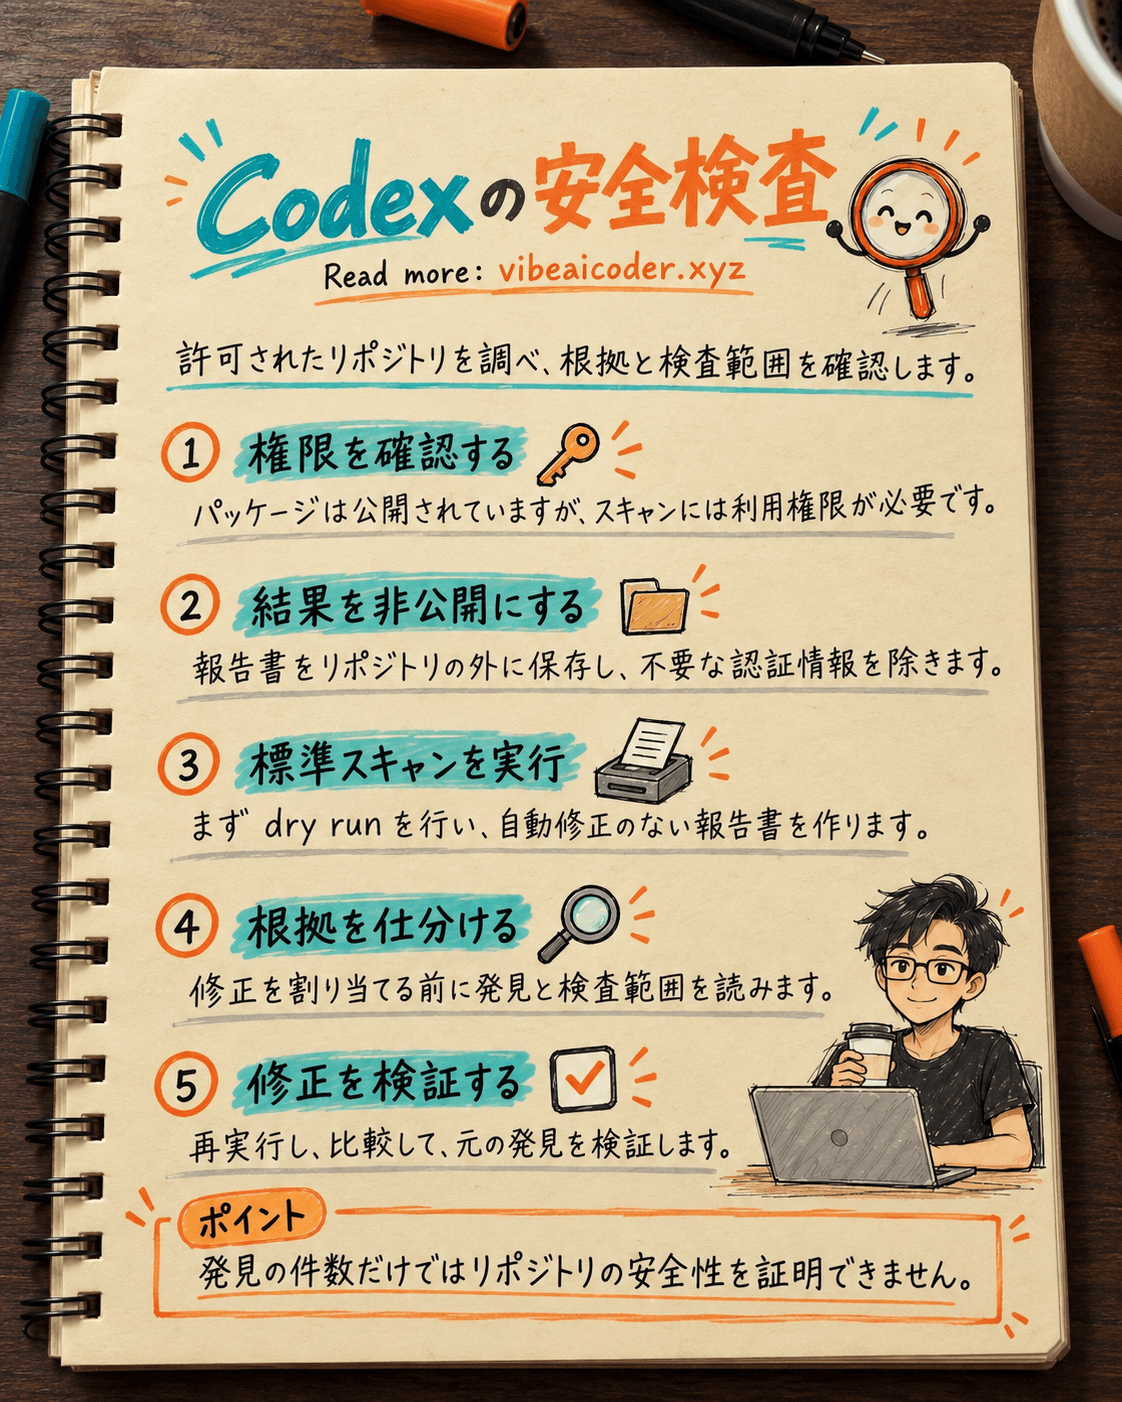
「重大度の高い問題が二件」という報告だけでは、どちらを先に直すか決められません。検査した範囲と、各問題の根拠を知る必要があります。この記事では、評価する権限のあるリポジトリを Codex Security CLI で一度スキャンし、結果を修正対象、追加確認が必要な項目、十分に調べられなかった領域に分けます。セットアップと報告書の確認には約30分を見込み、実際のスキャン時間はリポジトリと設定によって変わります。
これは製品コードの脆弱性を調べる手順です。チームでCodexを使ってコードを変更する際の権限とサンドボックスとは目的が異なります。前者は製品のリスクを調べ、後者は作業中のツールのアクセスを管理します。
 準備するもの
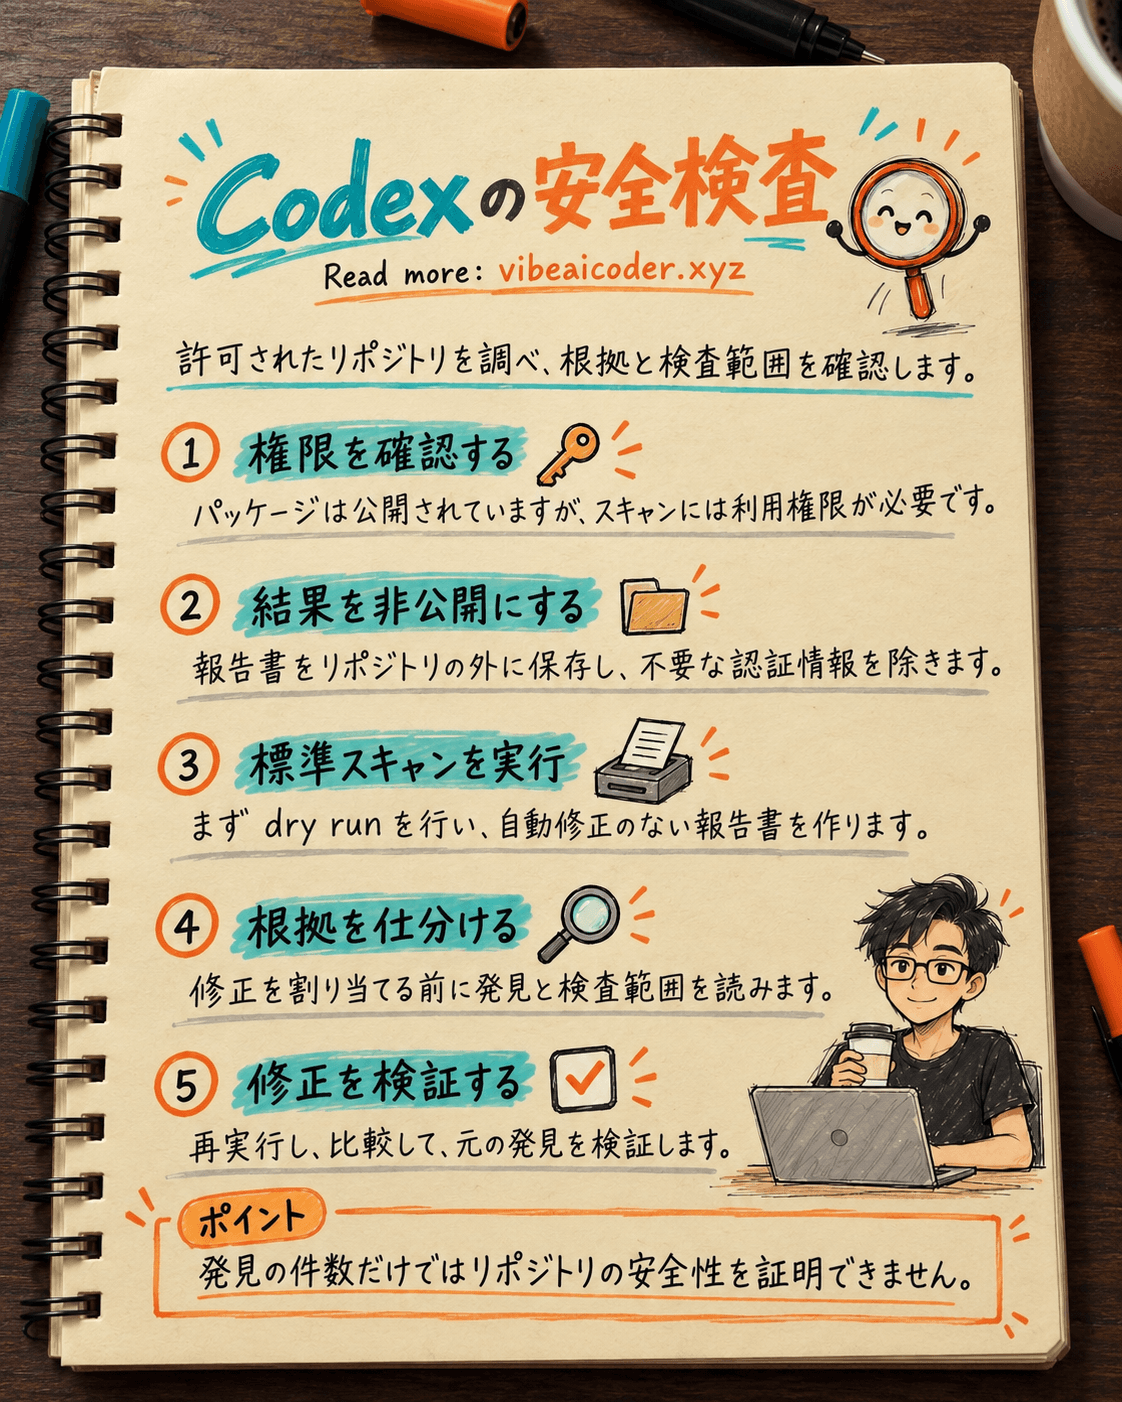
OpenAIのCodex Security CLIクイックスタートによると、@openai/codex-securityパッケージは公開されていますが、スキャンの実行にはCodex Securityへのアクセス権が必要です。アカウントやリポジトリによっては、リポジトリ全体のスキャンにTrusted Access for Cyberも必要です。パッケージをインストールできても、スキャン権限があるとは限りません。チームへの展開前に確認してください。
CLIにはNode.js 22の22.13.0以降、またはNode.js 24か26が必要です。スキャンや保存済み結果の確認にはPython 3.10以降も必要です。所有しているか評価許可を得たリポジトリを使い、現在のブランチと結果の担当者を確認します。ターミナルに慣れていなければ、小さなCodex CLI作業を自分で検証する手順から始められます。
結果にはソースコードの抜粋や脆弱性の詳細が含まれる場合があります。結果はリポジトリの外にある非公開ディレクトリに置き、閲覧権限と保管期限を決めます。OpenAIによると、ローカルスキャンは実行者のOS権限を使い、途中で承認を求めて停止しません。環境変数も引き継ぐ可能性があります。開始前に不要な認証情報を取り除き、設定エラーを避けるためだけに権限を上げないでください。
 手順
1. バージョンを確認してサインインする
まずNode.js、Python、CLIを確認します。次のコマンドは環境を調べるだけで、リポジトリをスキャンしません。
node --version
python3 --version
npx @openai/codex-security --version
npx @openai/codex-security info --json
npx @openai/codex-security --help
info --jsonはパッケージと同梱プラグインのバージョンを示します。対応外のNode.jsは先に修正します。対話的に使う端末では、必要な権限のあるChatGPTアカウントでサインインします。
npx @openai/codex-security login
npx @openai/codex-security login status
ブラウザーを使えないリモート端末ではlogin --device-authを利用できます。CIでは環境変数のAPIキーが一般的ですが、スキャン権限は別途必要です。ChatGPTのサインインとOPENAI_API_KEYまたはCODEX_API_KEYが両方ある場合、--auth chatgptか--auth api-keyを明示します。既定のautoは対話端末とCIで異なる認証情報を選ぶ場合があります。キーを端末に表示したり、社内手順書に貼ったりしないでください。
2. 対象と保存先を決めて入力を点検する
次の例のパスを、使用する端末の適切な絶対パスに置き換えます。SCAN_DIRはREPOSITORYの外に置き、結果へのアクセスを制限します。
REPOSITORY=/path/to/authorized-repository
SCAN_DIR=/path/outside-repository/security-results
npx @openai/codex-security scan "$REPOSITORY" --output-dir "$SCAN_DIR" --dry-run
OpenAIのCLIリファレンスによると、--dry-runは指定されたナレッジベースのパスなど、ローカルの入力を確認します。認証情報を読み込まず、Codexを起動せず、プラグイン用Pythonも検査しません。成功してもスキャン権限があることや、本番のスキャンが完了することは証明できません。パスや設定の誤りを早く見つけるための手順です。
複数のサービスがあるリポジトリでは、--path services/billingを追加し、担当者の明確な範囲から調べます。--knowledge-baseで設計図やセキュリティ方針を文脈として与える場合は、共有してよい内容か先に確かめます。CodexチームのAGENTS.mdルールは日常作業の指示です。それが存在するだけで、スキャナーが製品の信頼境界を十分に理解したとは言えません。
3. 標準スキャンを実行し、元の成果物を残す
dry runで対象と保存先を確認したら、標準スキャンを実行します。以下ではChatGPTでのサインインを明示しています。承認された運用がAPIキーを使う場合は--auth api-keyに変更します。
npx @openai/codex-security scan "$REPOSITORY" \
  --output-dir "$SCAN_DIR" \
  --auth chatgpt
既定のスキャンは報告のみで、コードを自動修正しません。対話端末には進行状況の画面が表示されます。通常、要約と報告書のパスはstderrに出力され、完全な結果はstdoutに出ません。進行状況の画面にはソースや認証情報が含まれる可能性があるため、スクリーンショットを共有する前に確認します。自動処理で完全なJSON文書が必要な場合に--jsonを使います。
完了したらreport.md、findings.json、coverage.json、scan-manifest.jsonを確認します。report.mdは人が読みやすい報告書です。findings.jsonには重大度、場所、根拠、修正の提案があります。coverage.jsonは検査した領域、除外、未解決の問いを記録します。scan-manifest.jsonは対象、範囲、状態を示します。チーム向けに要約する前に元のファイルを残してください。
4. 根拠と検査範囲で結果を仕分ける
最初に coverage を読みます。OpenAIが示す値はcomplete、partial、unknownです。partialやunknownなら、確認できなかったパスや機能を記録します。検出件数が少なくても、スキャンしていない決済機能の安全性は判断できません。completeでも対象の範囲、除外、未解決の問いを確認してから結果を解釈します。
各findingは検証が必要な仮説として扱います。チームの一覧には、発見と根拠、暫定判断、担当者と確認手順の三列があると便利です。判断は「修正して再確認」「追加調査」「具体的な根拠がある不適用」などです。重大度は順番を決める助けになりますが、データの流れ、到達可能性、本番の設定、利用者への影響は人が見ます。
誤検知が疑われる場合は、保存済み報告からoccurrence IDを確認し、findings false-positiveで具体的な理由を記録します。一つの事例が該当しないからといって、脆弱性の分類全体を除外しないでください。CLI FAQによると、この判断は後のスキャンの文脈になりますが、現在のコードと到達可能性は再確認されます。根拠が足りなければ「追加調査」のままにします。
5. 新しいスキャンで修正を確かめる
次の報告書からfindingが消えても、それだけで修正の証明にはなりません。以前の発見は解決または却下まで開いたままの場合があります。担当者がコードを変更したら、元の設定を再実行して比較します。
npx @openai/codex-security scans list "$REPOSITORY"
npx @openai/codex-security scans rerun BEFORE_SCAN_ID
npx @openai/codex-security scans compare BEFORE_SCAN_ID AFTER_SCAN_ID
BEFORE_SCAN_IDとAFTER_SCAN_IDを実際のIDに置き換えます。新しいスキャンが元の問題のパスを対象に含め、そこがpartialやunknownではないことを確認します。さらにvalidateで、現在のcheckoutに対する元のfindingを再確認します。Codexにパッチを作らせた場合もdiffを確認してテストを実行してください。--patchは明示的なオプションであり、標準の報告のみのスキャンには含まれません。
 結果の例
あるリポジトリに、ファイルのダウンロードで権限確認が足りないfindingと、誤検知かもしれないデータベースの警告があるとします。Webhook部分の検査も不十分でした。チームはダウンロード問題に担当者を付け、データベースの警告を調査中とし、Webhookの再確認を予定します。最初の問題を閉じるのは、再スキャンとvalidateの双方で修正を確認してからです。これは流れを説明する仮の例で、実際のスキャン結果ではありません。
 より良い結果を得るコツ
まず一つのリポジトリか担当者の明確なサービスを標準モードで調べます。最初の報告書を理解してから、deep scan、diff scan、コミット前の検査へ広げます。大きなリポジトリでは--pathが担当範囲との対応に役立ちます。Pull requestでコミット済み変更を調べる場合は--diff origin/main --head HEAD、未コミットの変更は--working-tree --base HEADです。これらの変更スキャンではリポジトリ引数にGit worktreeのルートが必要です。--path、--diff、--working-treeは同時に使えません。
予算上限がある場合は--max-costを設定します。推定モデル費用が上限を超えた時点で停止しますが、進行中のリクエストにより少し超過することがあります。途中で止まったdeep scanのcoverageはpartialになり得ます。後で同じ対象を比較できるよう、各スキャンのID、日付、ブランチ、commit、範囲、確認者を記録しましょう。報告書は技術的判断の材料であり、コードレビューや適切なセキュリティテストの代わりにはなりません。
 知っておきたい制限
スキャンにはCodex Securityへのアクセス権が必要で、Trusted Access for Cyberが必要な場合もあります。CLIはOSアカウントが読めるものを読めるうえ、スキャン中に承認を求めて停止しません。許可されたリポジトリだけを対象にし、不要な認証情報を取り除き、結果を非公開にしてください。ソースの抜粋や脆弱性報告を公開しないでください。推論プロバイダーや保存先を変更する前に、組織のデータ規則も確認します。
AIを使うスキャンは見落としや誤判定があり、同じ設定でも結果が変わることがあります。completeはそのスキャンが調べた範囲の記録であり、リポジトリに脆弱性がないという証明ではありません。重要なfindingと実際の影響はシステムを理解する人が確認する必要があります。この記事のコマンドは現在のOpenAI公式文書と照合しましたが、対象リポジトリと権限が指定されていないため、実際のスキャンは行っていません。
 よくある質問
公開CLIをインストールすればすぐスキャンできますか? いいえ。Codex Securityのアクセス権が必要です。一部のリポジトリ全体のスキャンにはTrusted Access for Cyberも必要な場合があります。
Dry runはモデルのトークンを使ったり、サインインを確認したりしますか? OpenAIによると、--dry-runはローカル入力を調べ、認証情報を読み込まず、Codexを起動せず、プラグインのPythonも検査しません。
Findingがなければリポジトリは安全ですか? いいえ。coverage.json、対象範囲、除外、未解決の問いを読みます。coverageがcompleteでも、すべての脆弱性を見つけた保証にはなりません。
スキャン中に問題を自動修正できますか? --patchというオプションはありますが、既定のスキャンは報告のみです。変更を受け入れる前に根拠と範囲を確認し、diffのレビューとテストを行います。
次のスキャンで問題が消えたら修正済みですか? 断定できません。スキャンを比較し、対象コードのcoverageを確かめ、現在のcheckoutで元のfindingをvalidateします。
公式出典:Codex Security CLIクイックスタート、CLIリファレンス、CLI FAQ、OpenAI Learn。確認日:2026年10月5日。#CodexSecurity #コードセキュリティ #CodexCLI #AI開発 #VibeCoding
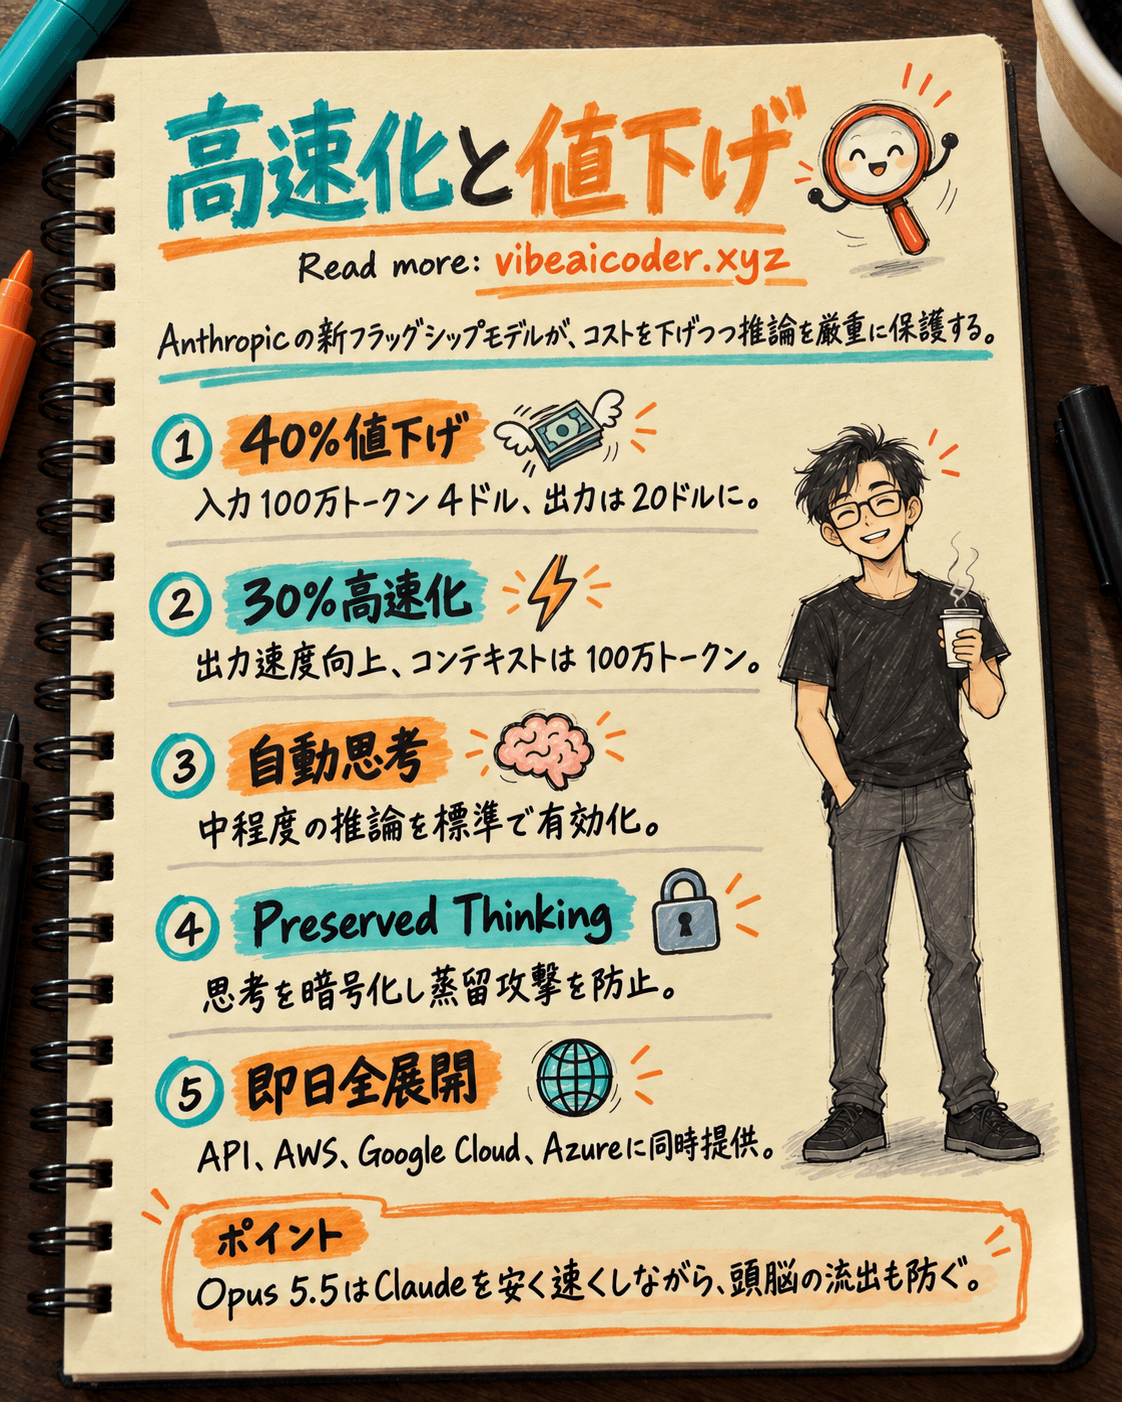
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止