Vector Database Là Gì? Nơi AI Lưu Và Tìm Lại Thông Tin Bằng Ý Nghĩa
🗄️ Vector database là gì? Nơi AI "nhớ" và tìm lại thông tin bằng embedding
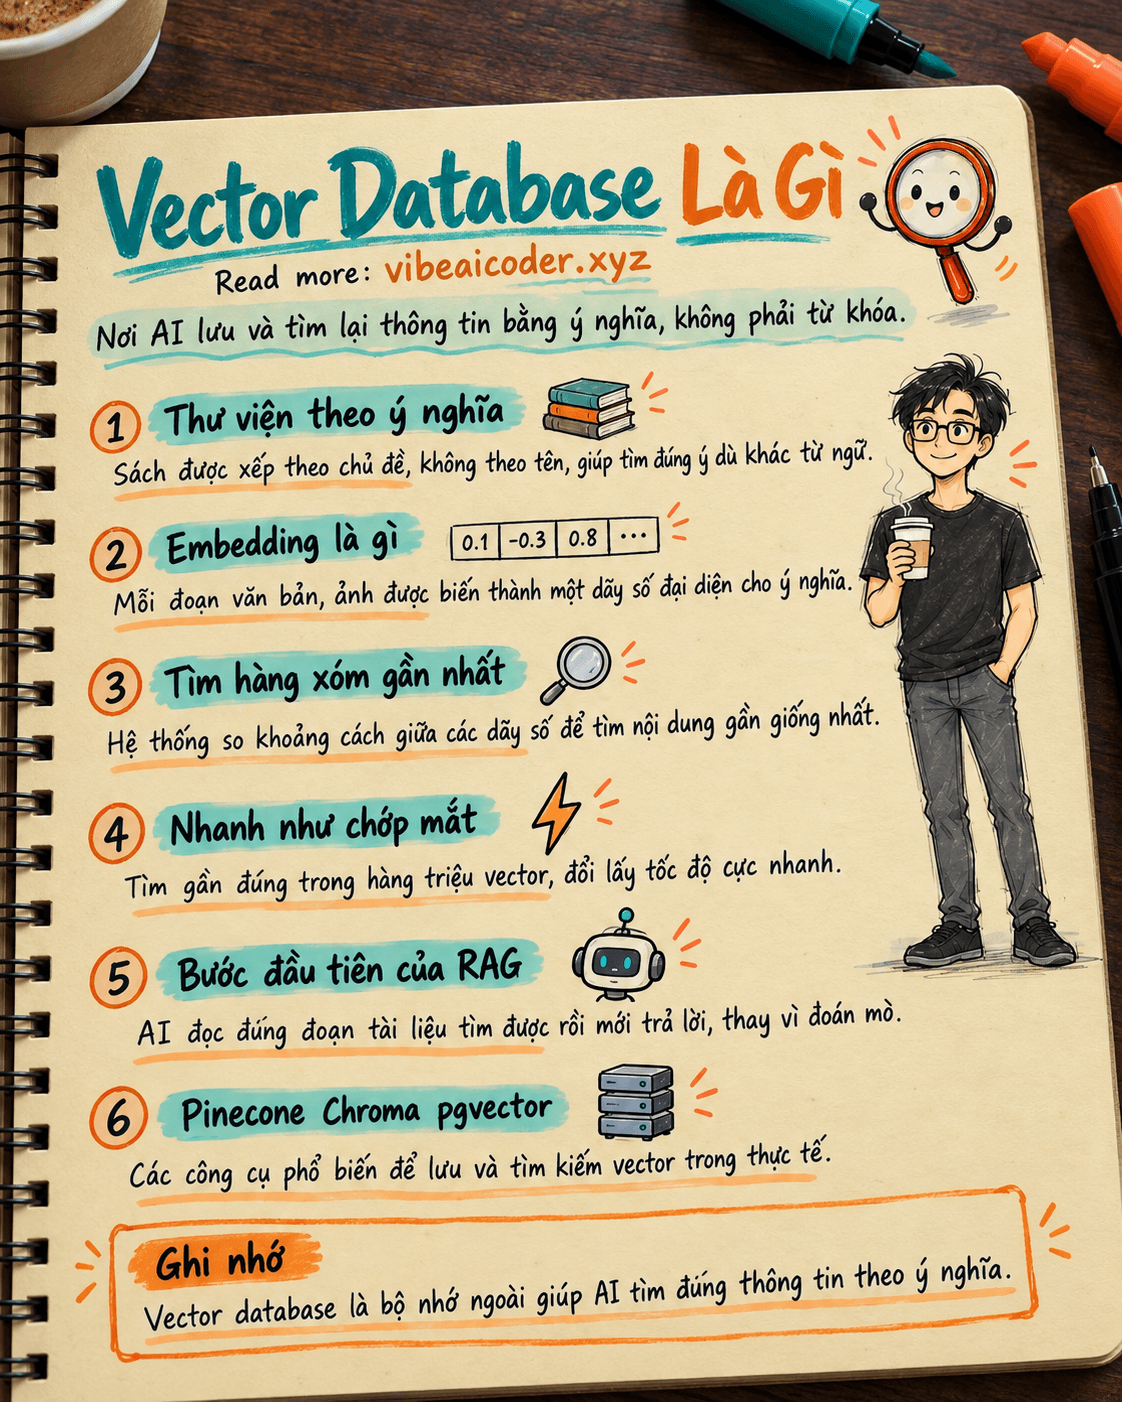
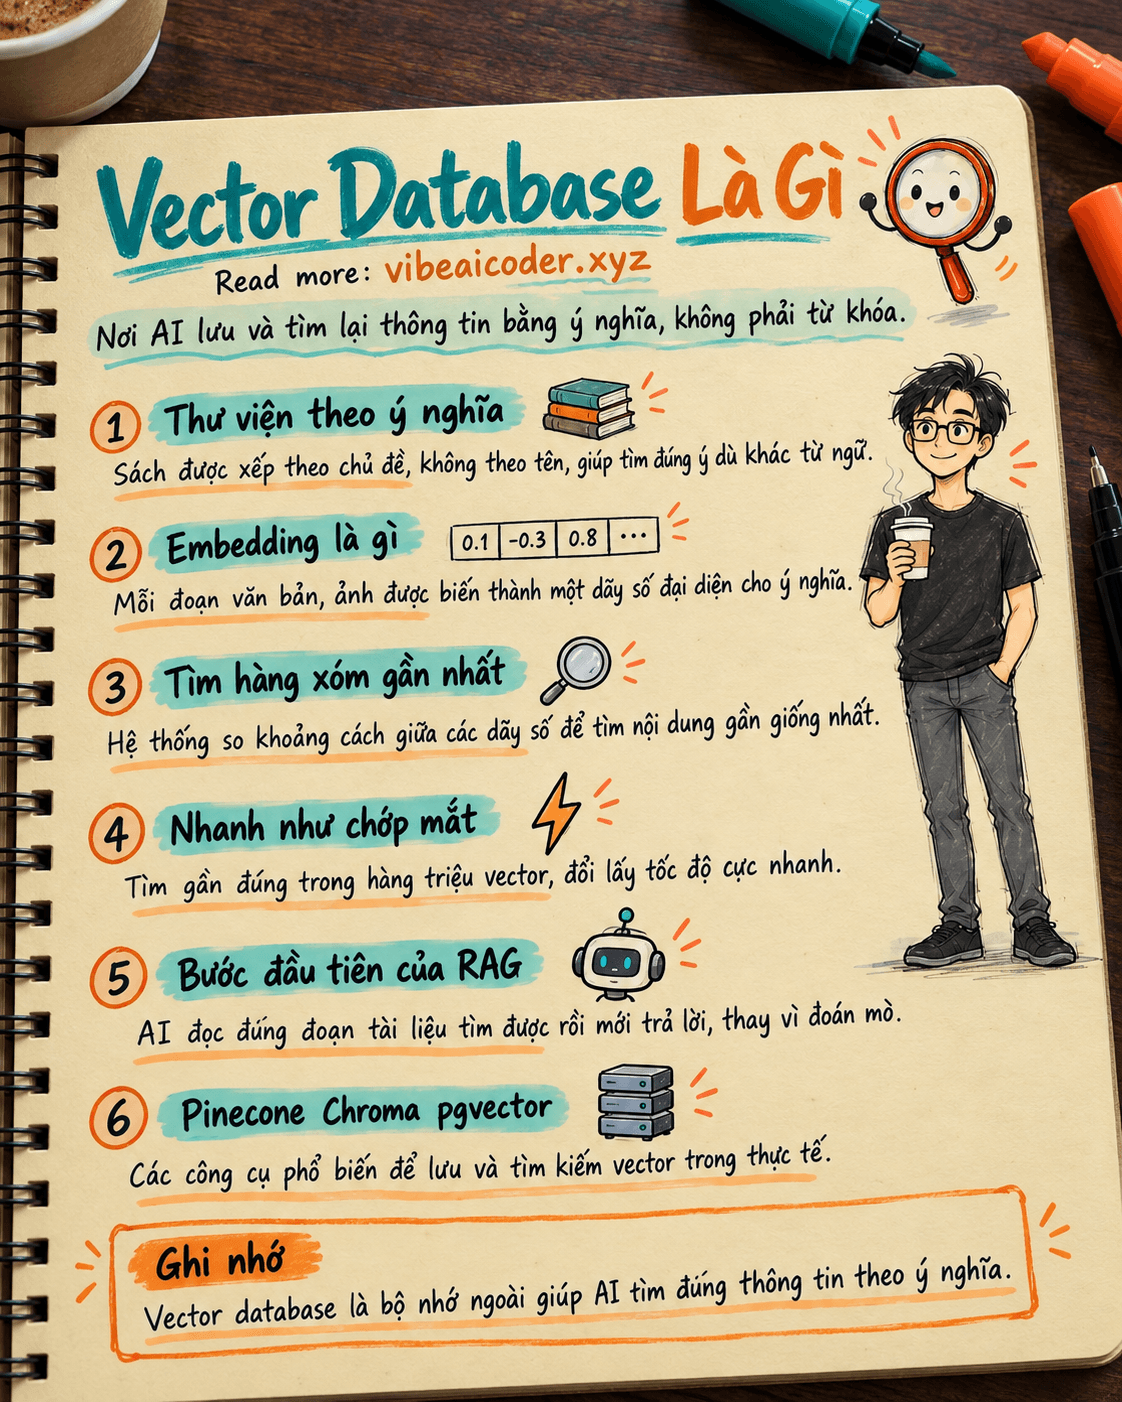
Vector database (cơ sở dữ liệu vector) là nơi lưu trữ thông tin dưới dạng những dãy số gọi là embedding, để AI có thể tìm lại đúng đoạn văn bản, hình ảnh hay tài liệu "giống nghĩa" với câu bạn hỏi, chỉ trong tích tắc. Nói đơn giản, đây chính là "bộ nhớ ngoài" giúp AI trả lời đúng dựa trên dữ liệu riêng của bạn, thay vì chỉ dựa vào những gì nó học thuộc từ trước.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng một thư viện khổng lồ với hàng triệu cuốn sách. Nếu sắp xếp theo bảng chữ cái tên sách, bạn chỉ tìm được sách khi biết chính xác tên. Nhưng nếu thủ thư xếp sách theo chủ đề và ý nghĩa, ví dụ mọi cuốn nói về "tình yêu trong chiến tranh" được đặt gần nhau dù tên sách hoàn toàn khác nhau, bạn chỉ cần hỏi "có sách nào nói về tình yêu thời chiến không?" là tìm ra ngay, kể cả khi không nhớ tên sách.
Vector database hoạt động giống người thủ thư đó. Nó không xếp dữ liệu theo chữ cái hay từ khóa, mà xếp theo "ý nghĩa". Khi bạn hỏi AI một câu, hệ thống sẽ đi tìm những đoạn dữ liệu có ý nghĩa gần giống câu hỏi nhất, dù chúng dùng từ ngữ hoàn toàn khác.
 Nó hoạt động thế nào
- Biến dữ liệu thành embedding. Mỗi đoạn văn bản, hình ảnh hay tài liệu được một mô hình AI chuyển thành một dãy số (thường vài trăm đến vài nghìn con số). Dãy số này đại diện cho "ý nghĩa" của nội dung đó.
- Lưu vào vector database. Thay vì lưu chữ thô như cơ sở dữ liệu thông thường, vector database lưu các dãy số này cùng với nội dung gốc đi kèm.
- Khi bạn đặt câu hỏi, câu hỏi cũng được biến thành một dãy số theo đúng cách tương tự.
- Hệ thống so sánh "khoảng cách" giữa dãy số của câu hỏi với hàng triệu dãy số đã lưu, để tìm ra những đoạn có ý nghĩa gần nhất. Việc này gọi là tìm "hàng xóm gần nhất" (nearest neighbor), và vì dữ liệu quá lớn nên hệ thống thường tìm gần đúng thay vì tuyệt đối chính xác, đổi lại tốc độ nhanh hơn rất nhiều.
- Những đoạn tìm được sẽ đưa vào AI cùng câu hỏi của bạn, để AI đọc và trả lời dựa trên đúng thông tin đó, thay vì đoán mò.
Đây chính là bước nền tảng phía sau kỹ thuật RAG (cho AI tra cứu tài liệu trước khi trả lời) mà nhiều công ty dùng để AI trả lời đúng theo tài liệu nội bộ, thay vì chỉ dựa vào kiến thức đã học trước đó.
 Điều này có ý nghĩa gì với bạn
Bạn có thể không tự xây vector database, nhưng việc hiểu nó giúp bạn dùng AI thông minh hơn:
- Khi một công cụ AI quảng cáo "chat với tài liệu của bạn" hay "AI biết hết dữ liệu công ty bạn", nhiều khả năng phía sau nó đang dùng vector database để tìm đúng đoạn tài liệu liên quan trước khi trả lời.
- Nếu bạn là người làm sản phẩm hoặc kỹ thuật, biết khái niệm này giúp bạn hiểu vì sao một số sản phẩm AI "nhớ" tài liệu công ty rất tốt (ChatGPT với tính năng tải file lên, Claude với Projects, hay các công cụ tìm kiếm nội bộ doanh nghiệp) đều cần một vector database đứng phía sau.
- Khi AI trả lời sai hoặc "quên" một tài liệu bạn vừa tải lên, một nguyên nhân có thể là bước tìm kiếm trong vector database không tìm đúng đoạn liên quan, chứ không hẳn do AI "ngu". Biết điều này giúp bạn thử lại bằng cách hỏi cụ thể hơn, dùng đúng từ khóa xuất hiện trong tài liệu gốc.
 Hiểu lầm thường gặp
- "Vector database chỉ là cơ sở dữ liệu thông thường, đổi tên cho sang." Sai. Cơ sở dữ liệu thông thường (như Excel hay MySQL) tìm kiếm theo giá trị chính xác hoặc từ khóa khớp. Vector database tìm theo "ý nghĩa gần giống", nên có thể tìm ra câu trả lời đúng dù bạn không dùng đúng từ trong tài liệu gốc.
- "Có vector database là AI sẽ không bao giờ trả lời sai nữa." Không đúng. Vector database chỉ giúp tìm đúng tài liệu liên quan, nhưng AI vẫn có thể hiểu sai hoặc diễn giải nhầm nội dung tìm được. Đây vẫn là một bước giảm rủi ro ảo giác, không phải giải pháp tuyệt đối.
- "Chỉ công ty công nghệ lớn mới cần vector database." Không hẳn. Nhiều công cụ phổ biến (Notion AI, các chatbot hỗ trợ khách hàng, trợ lý đọc tài liệu) đều dùng vector database ở quy mô nhỏ, và một số như pgvector (chạy trên PostgreSQL có sẵn) hay Chroma (chạy ngay trên máy cá nhân) rất dễ dùng ngay cả cho dự án nhỏ.
 Câu hỏi thường gặp
Vector database có phải AI không? Không. Bản thân nó chỉ là nơi lưu trữ và tìm kiếm dữ liệu. AI là phần đọc câu hỏi, tạo ra embedding và viết câu trả lời dựa trên dữ liệu tìm được.
Vector database khác gì embedding? Embedding là dãy số đại diện cho ý nghĩa của một đoạn văn bản hay hình ảnh. Vector database là nơi lưu hàng triệu embedding đó và tìm kiếm nhanh trong số đó. Embedding là "dữ liệu", vector database là "nơi chứa và công cụ tìm kiếm".
Những cái tên như Pinecone, Weaviate, Milvus, Chroma, pgvector là gì? Đây là các sản phẩm vector database phổ biến. Pinecone là dịch vụ quản lý sẵn, không cần tự vận hành máy chủ. Milvus phù hợp khi cần lưu hàng tỷ vector. Chroma chạy nhẹ ngay trên máy cá nhân, thích hợp để thử nghiệm. pgvector là một tiện ích mở rộng cho PostgreSQL, phù hợp nếu bạn đã dùng sẵn Postgres và không muốn thêm hệ thống mới.
Người dùng bình thường có cần quan tâm đến vector database không? Không cần biết kỹ thuật, nhưng biết khái niệm giúp bạn hiểu vì sao một số công cụ AI "nhớ" tài liệu của bạn tốt hơn công cụ khác, và vì sao câu hỏi càng cụ thể, càng gần với từ ngữ trong tài liệu gốc thì AI càng dễ tìm đúng và trả lời chính xác.
Vector database có lưu trữ an toàn dữ liệu của tôi không? Điều này phụ thuộc vào dịch vụ bạn dùng, không phải bản chất của vector database. Trước khi tải tài liệu nhạy cảm lên bất kỳ công cụ AI nào, hãy đọc chính sách bảo mật và dữ liệu của chính sản phẩm đó, giống như với bất kỳ phần mềm lưu trữ đám mây nào khác.
Hiểu được embedding là gì và cách vector database tìm kiếm theo ý nghĩa sẽ giúp bạn hình dung rõ hơn cách các AI agent phối hợp làm việc với kho dữ liệu riêng của từng công ty, hay vì sao một số công cụ cần chạy AI ngay trên máy cá nhân để giữ dữ liệu không rời khỏi thiết bị. Nếu bạn mới bắt đầu tìm hiểu AI, có thể đọc lại bài gốc AI là gì để nắm các khái niệm nền tảng trước.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
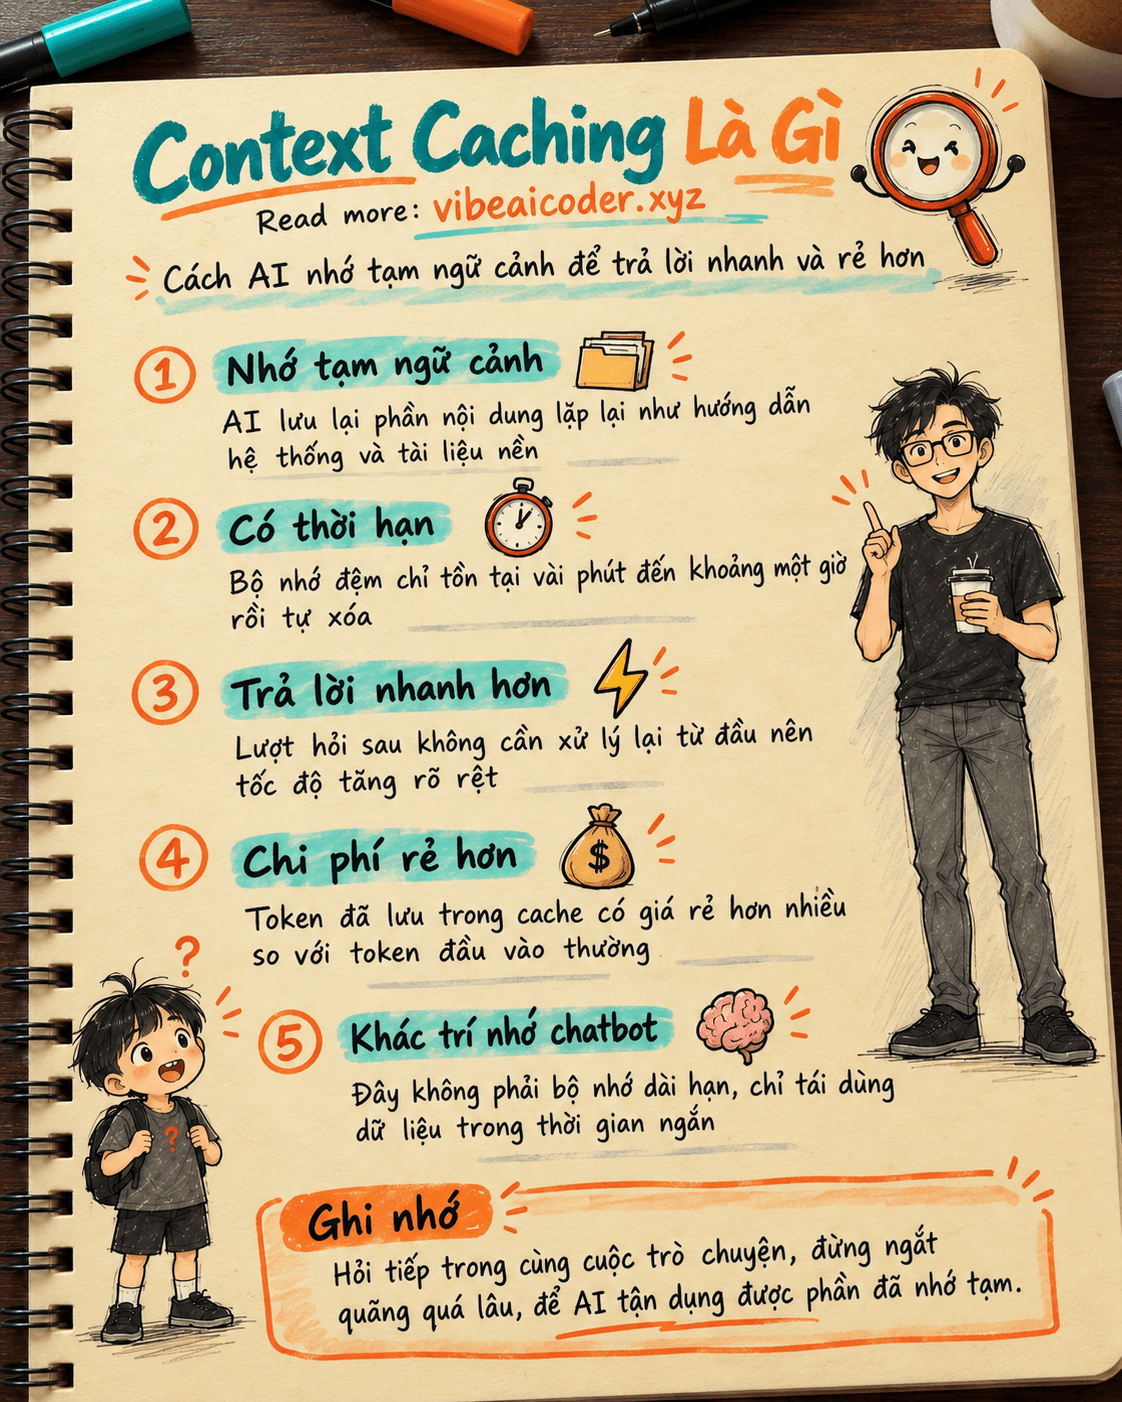
 Context caching là gì? Vì sao dùng lại ngữ cảnh giúp AI nhanh và rẻ hơn
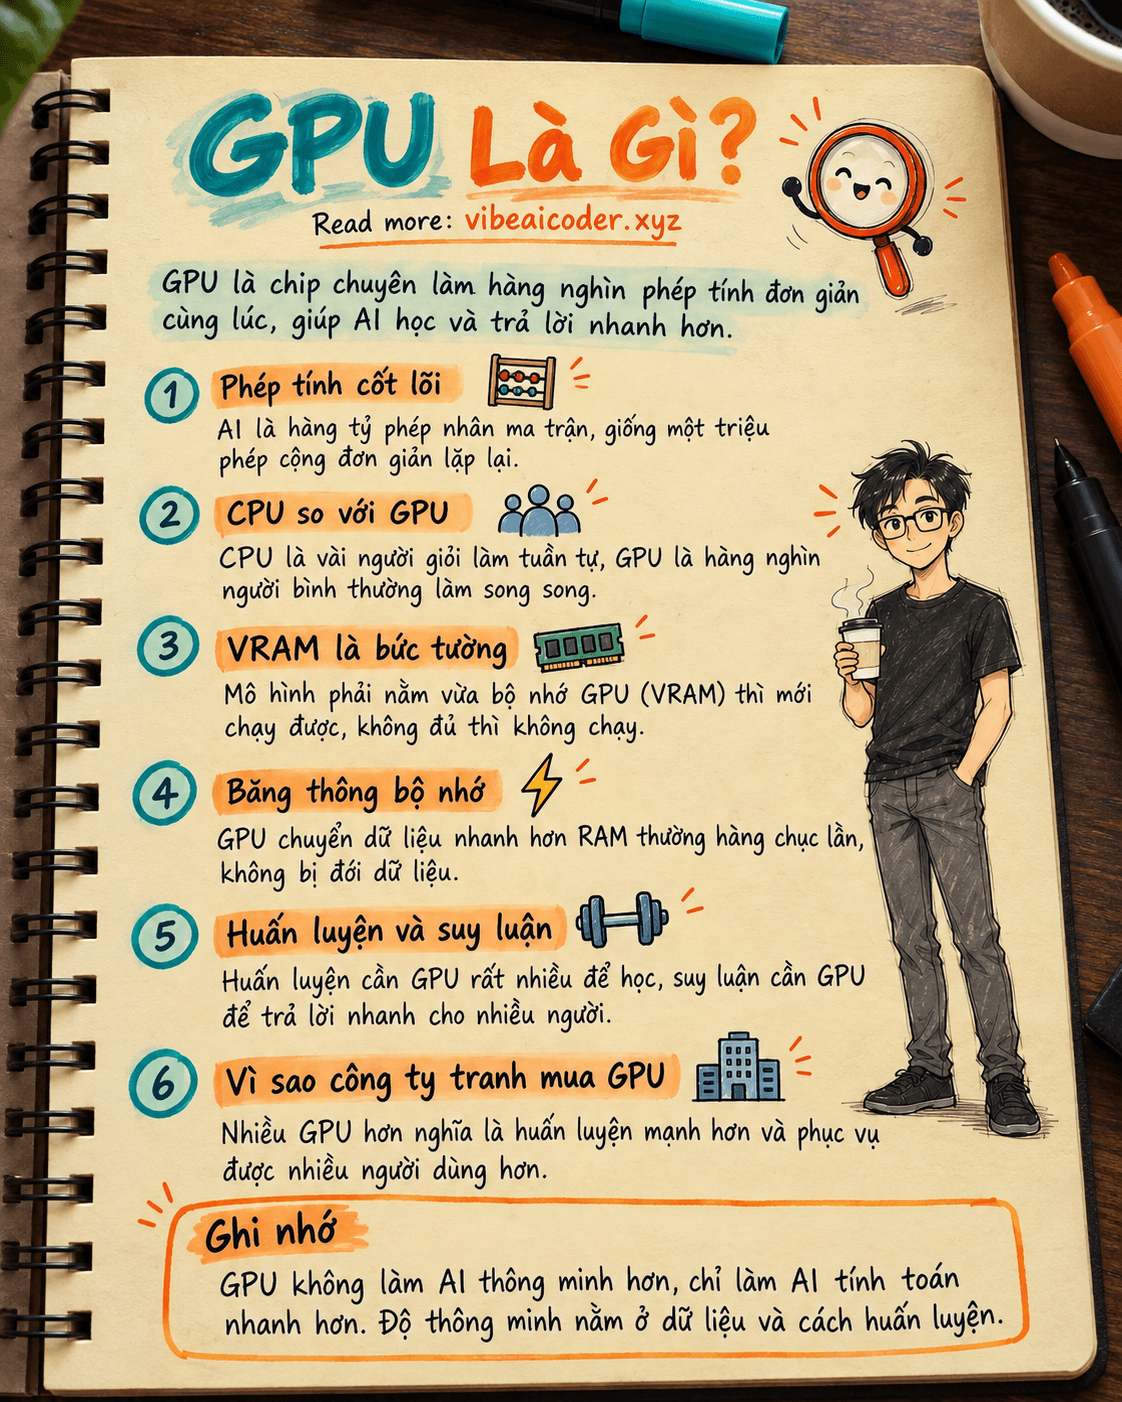
 GPU Là Gì? Vì Sao AI Cần Chip Đồ Họa Mạnh Để Huấn Luyện Và Chạy