🌫️ iLLaDA: Mô hình khuếch tán 8B của ByteDance bắt kịp Qwen2.5
Bạn quen với hình ảnh một mô hình ngôn ngữ "viết" từng chữ một, trái sang phải, như đang gõ phím vậy. Nhưng nếu có một AI sinh chữ theo kiểu... khử nhiễu một bức tranh mờ thành rõ nét thì sao? Đó chính là tinh thần của iLLaDA — mô hình ngôn ngữ khuếch tán 8 tỷ tham số vừa được nhóm nghiên cứu từ Đại học Nhân dân Trung Quốc (Renmin University) và ByteDance công bố ngày 24/6/2026. Và bất ngờ thay, nó bám sát được Qwen2.5 dù đi một con đường hoàn toàn khác.
🌫️ Mô hình khuếch tán ngôn ngữ là gì?
Hãy bắt đầu từ thứ quen thuộc. Các LLM "bình thường" như GPT hay Qwen là mô hình tự hồi quy (autoregressive): chúng đoán từ tiếp theo dựa trên tất cả các từ đứng trước, lần lượt từng token một. Giống như bạn kể chuyện mà mỗi câu chỉ được nói sau khi câu trước đã xong.
Mô hình khuếch tán (diffusion) thì khác hẳn. Ý tưởng vốn nổi tiếng từ thế giới sinh ảnh (như Stable Diffusion): bắt đầu từ một mớ nhiễu lộn xộn, rồi khử nhiễu dần dần cho đến khi ra hình rõ ràng. iLLaDA mang đúng tư duy đó sang văn bản: thay vì viết tuần tự, nó bắt đầu với một chuỗi đầy token bị che (masked), rồi qua nhiều bước dự đoán và "lấp chỗ trống" song song cho đến khi cả câu hoàn chỉnh hiện ra.
 Vì sao điều này thú vị?
Điểm hấp dẫn nhất là tính song song. Vì không bị ràng buộc "phải xong từ này mới tới từ kia", mô hình khuếch tán về lý thuyết có thể sinh nhiều token cùng lúc, mở ra tiềm năng tăng tốc độ sinh văn bản.
Thứ hai là ngữ cảnh hai chiều (bidirectional). LLM tự hồi quy chỉ được "nhìn" về phía sau (các từ đã sinh). iLLaDA bỏ luôn cái "mặt nạ nhân quả" (causal mask) đó, cho phép mô hình cân nhắc toàn bộ câu — cả trước lẫn sau — khi điền vào chỗ trống. Điều này rất hợp với những bài toán cần suy luận tổng thể.
Một chi tiết hay: iLLaDA dùng cơ chế re-masking thông minh — những token mà nó "không chắc" sẽ bị che lại và đoán lại ở bước sau, tạo ra một thứ tự sinh chữ linh hoạt thay vì cứng nhắc trái-qua-phải.
 iLLaDA đứng đâu so với Qwen2.5?
Đây mới là phần khiến cộng đồng AI nhướn mày. iLLaDA được huấn luyện từ đầu (from scratch) với mục tiêu khuếch tán xuyên suốt cả pre-training lẫn fine-tuning — không hề mượn kiến trúc tự hồi quy. Quy mô cũng không nhỏ: 12 nghìn tỷ token cho giai đoạn tiền huấn luyện, cộng thêm bộ chỉ dẫn 25 tỷ token tinh chỉnh qua 12 epoch.
Kết quả? Bản iLLaDA-Base vượt Qwen2.5 7B trên một số benchmark của mô hình nền, dù sử dụng các kỹ thuật tiết kiệm như grouped-query attention (giảm bộ nhớ inference) và tied embeddings (giảm số tham số). Nói cách khác, một mô hình khuếch tán giờ đây có thể đọ sức sòng phẳng với ông lớn tự hồi quy ở cùng tầm cỡ.
Công bằng mà nói: bản iLLaDA-Instruct trung bình vẫn còn bám đuôi Qwen2.5 — vốn được luyện trên lượng dữ liệu khổng lồ hơn. Nên đây là câu chuyện "bắt kịp ấn tượng", chưa phải "soán ngôi".
 Tiến bộ so với "đàn anh" LLaDA
iLLaDA là bản nâng cấp của LLaDA — mô hình khuếch tán ngôn ngữ đầu tiên đạt mức ngang ngửa các LLM tự hồi quy, ra mắt đầu năm 2025. So với đàn anh, iLLaDA tiến bộ rộng khắp ở mảng tổng quát, toán và lập trình. Vài con số minh họa:
- iLLaDA-Base: +21.6 điểm trên BBH, +14.9 điểm trên ARC-Challenge so với LLaDA.
- iLLaDA-Instruct: +14.5 điểm trên MATH, +16.5 điểm trên HumanEval.
(Lưu ý nhỏ cho bạn: những con số này là mức cải thiện so với LLaDA cũ, không phải khoảng cách với Qwen2.5 nhé.)
 Vì sao bạn nên để mắt tới?
Suốt nhiều năm, "LLM" gần như đồng nghĩa với "Transformer tự hồi quy". iLLaDA là một bằng chứng nữa cho thấy con đường khuếch tán hoàn toàn hai chiều, huấn luyện từ đầu, là một hướng đi cạnh tranh được để tạo ra mô hình ngôn ngữ mạnh.
Nếu hướng này tiếp tục mở rộng quy mô (và thực tế đã có những dự án đẩy diffusion LLM lên tới hàng trăm tỷ tham số), chúng ta có thể bước vào một kỷ nguyên nơi AI không còn "gõ chữ tuần tự" mà dựng cả đoạn văn cùng lúc — nhanh hơn, linh hoạt hơn. Còn quá sớm để nói khuếch tán sẽ thay thế tự hồi quy, nhưng iLLaDA cho thấy cuộc đua giờ đã có thêm một tay đua nghiêm túc.
Bạn nghĩ sao — liệu tương lai của LLM là "khử nhiễu" thay vì "gõ phím"?
#ByteDance #DiffusionLLM #iLLaDA #AI #Qwen #VibeAICoder #MoHinhNgonNgu
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
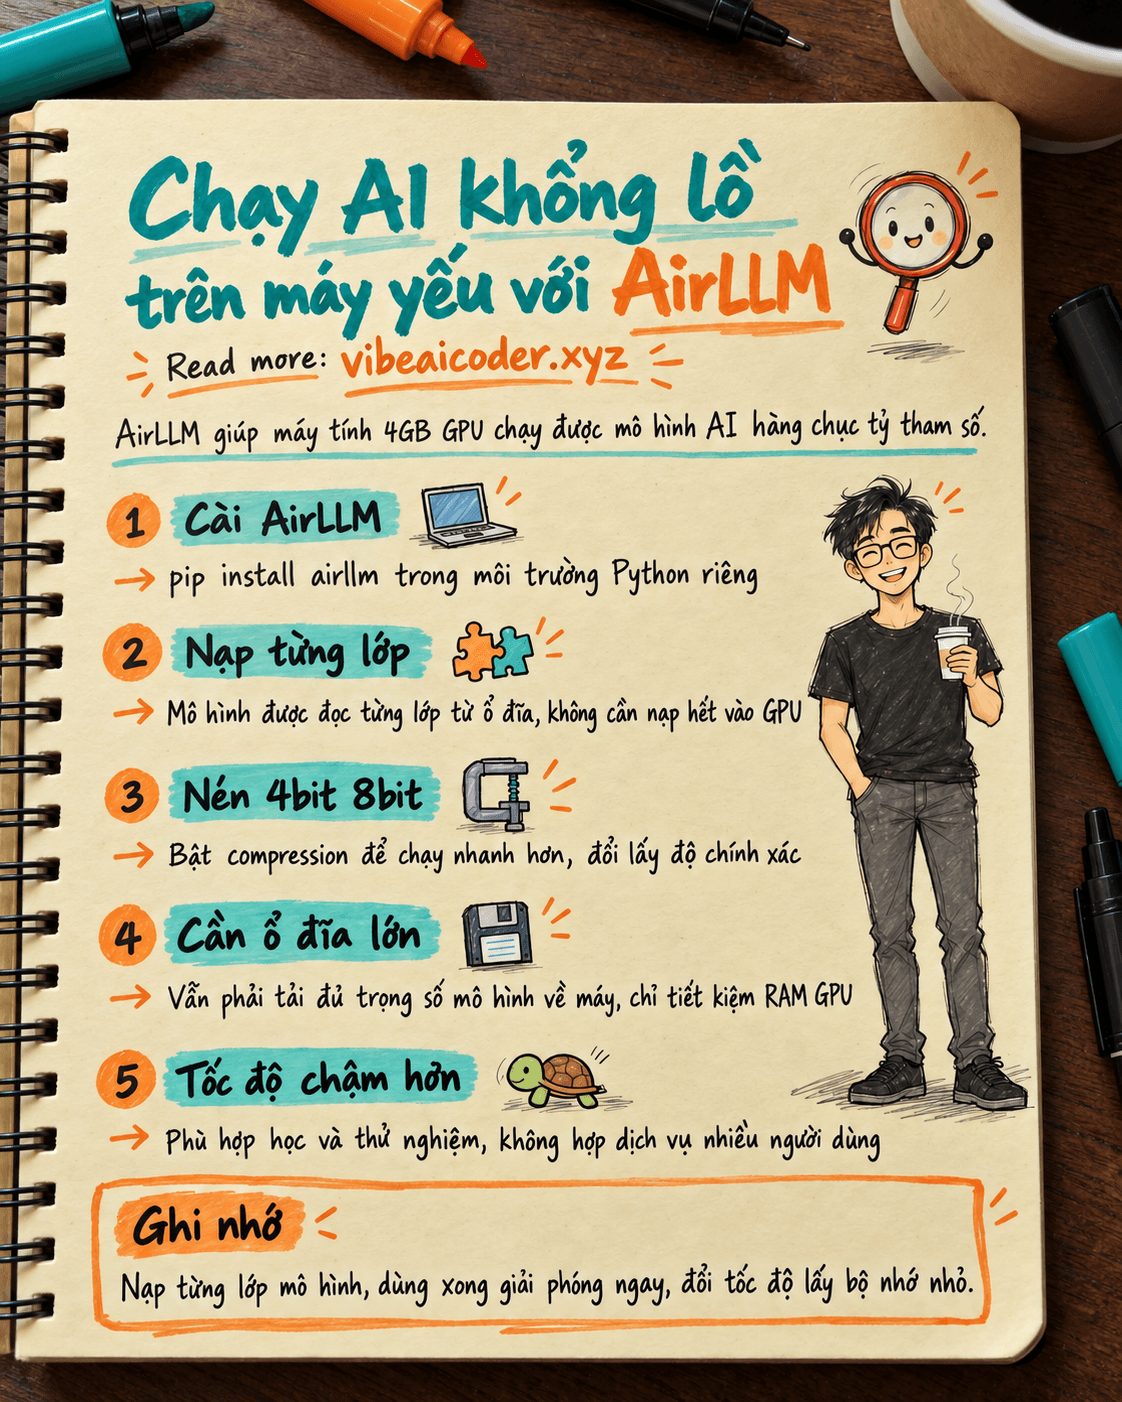
 Dùng AirLLM để chạy mô hình AI hàng chục tỷ tham số trên máy tính chỉ có 4GB card đồ họa
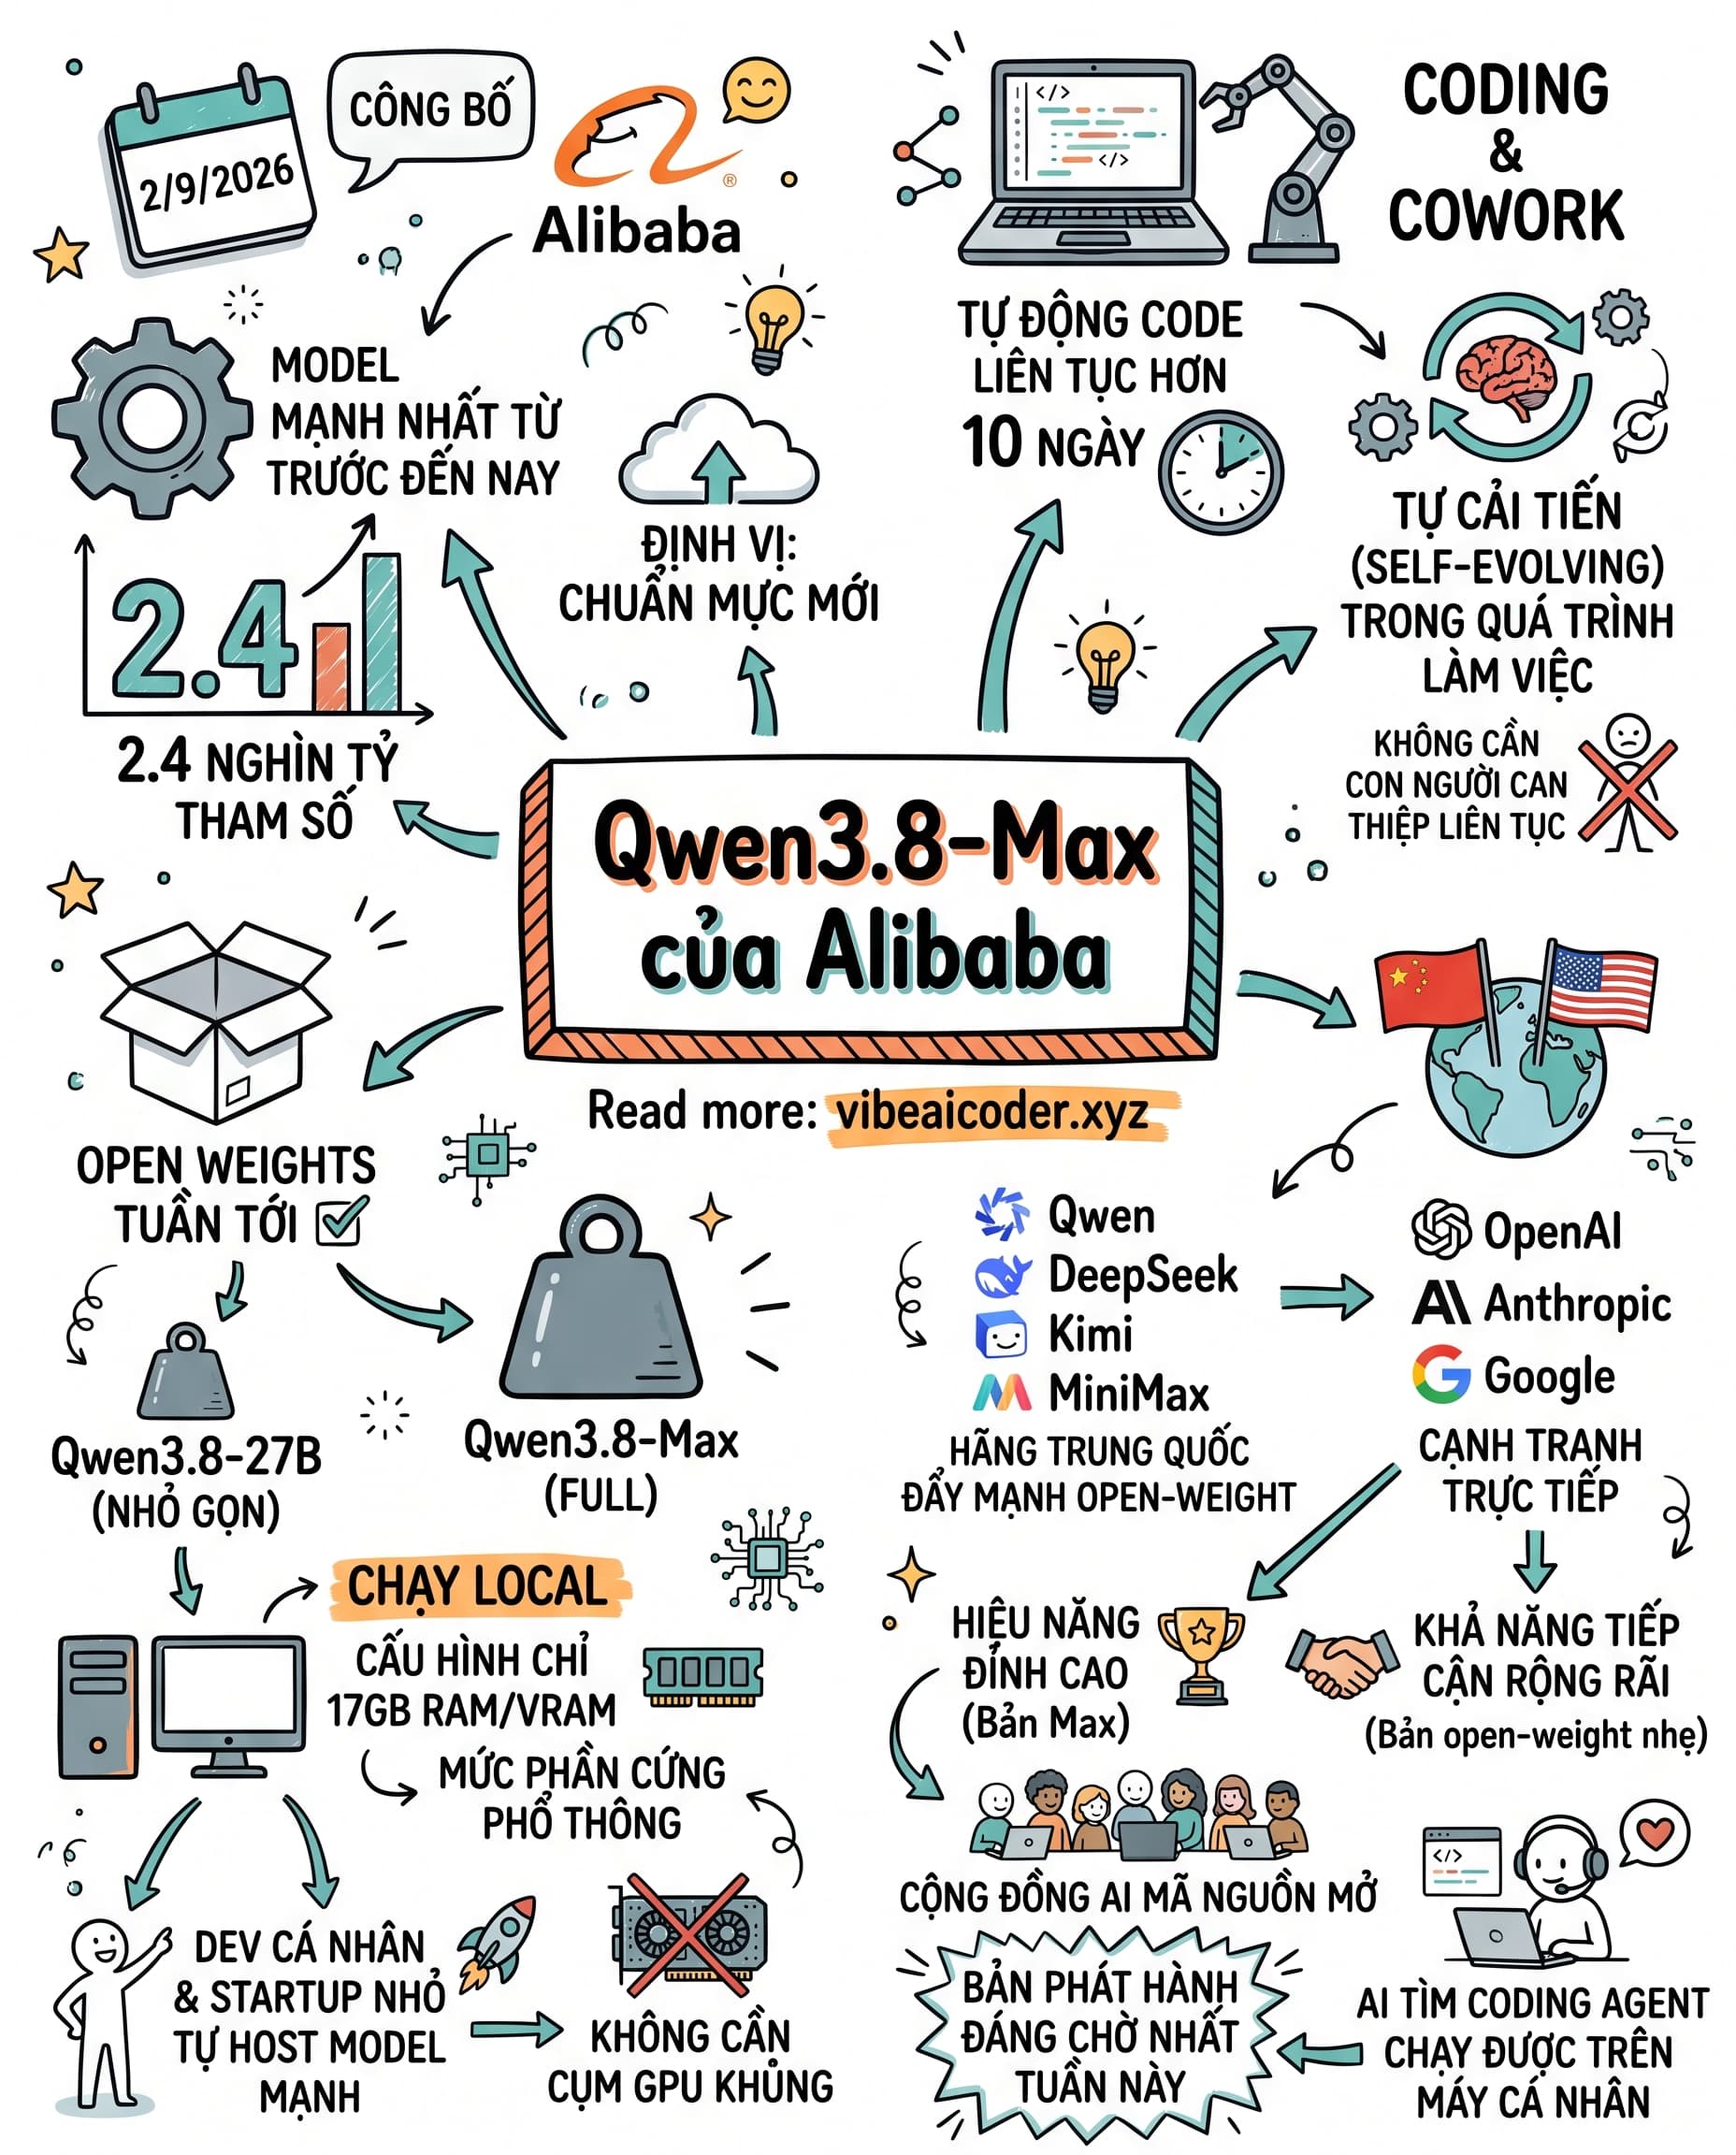
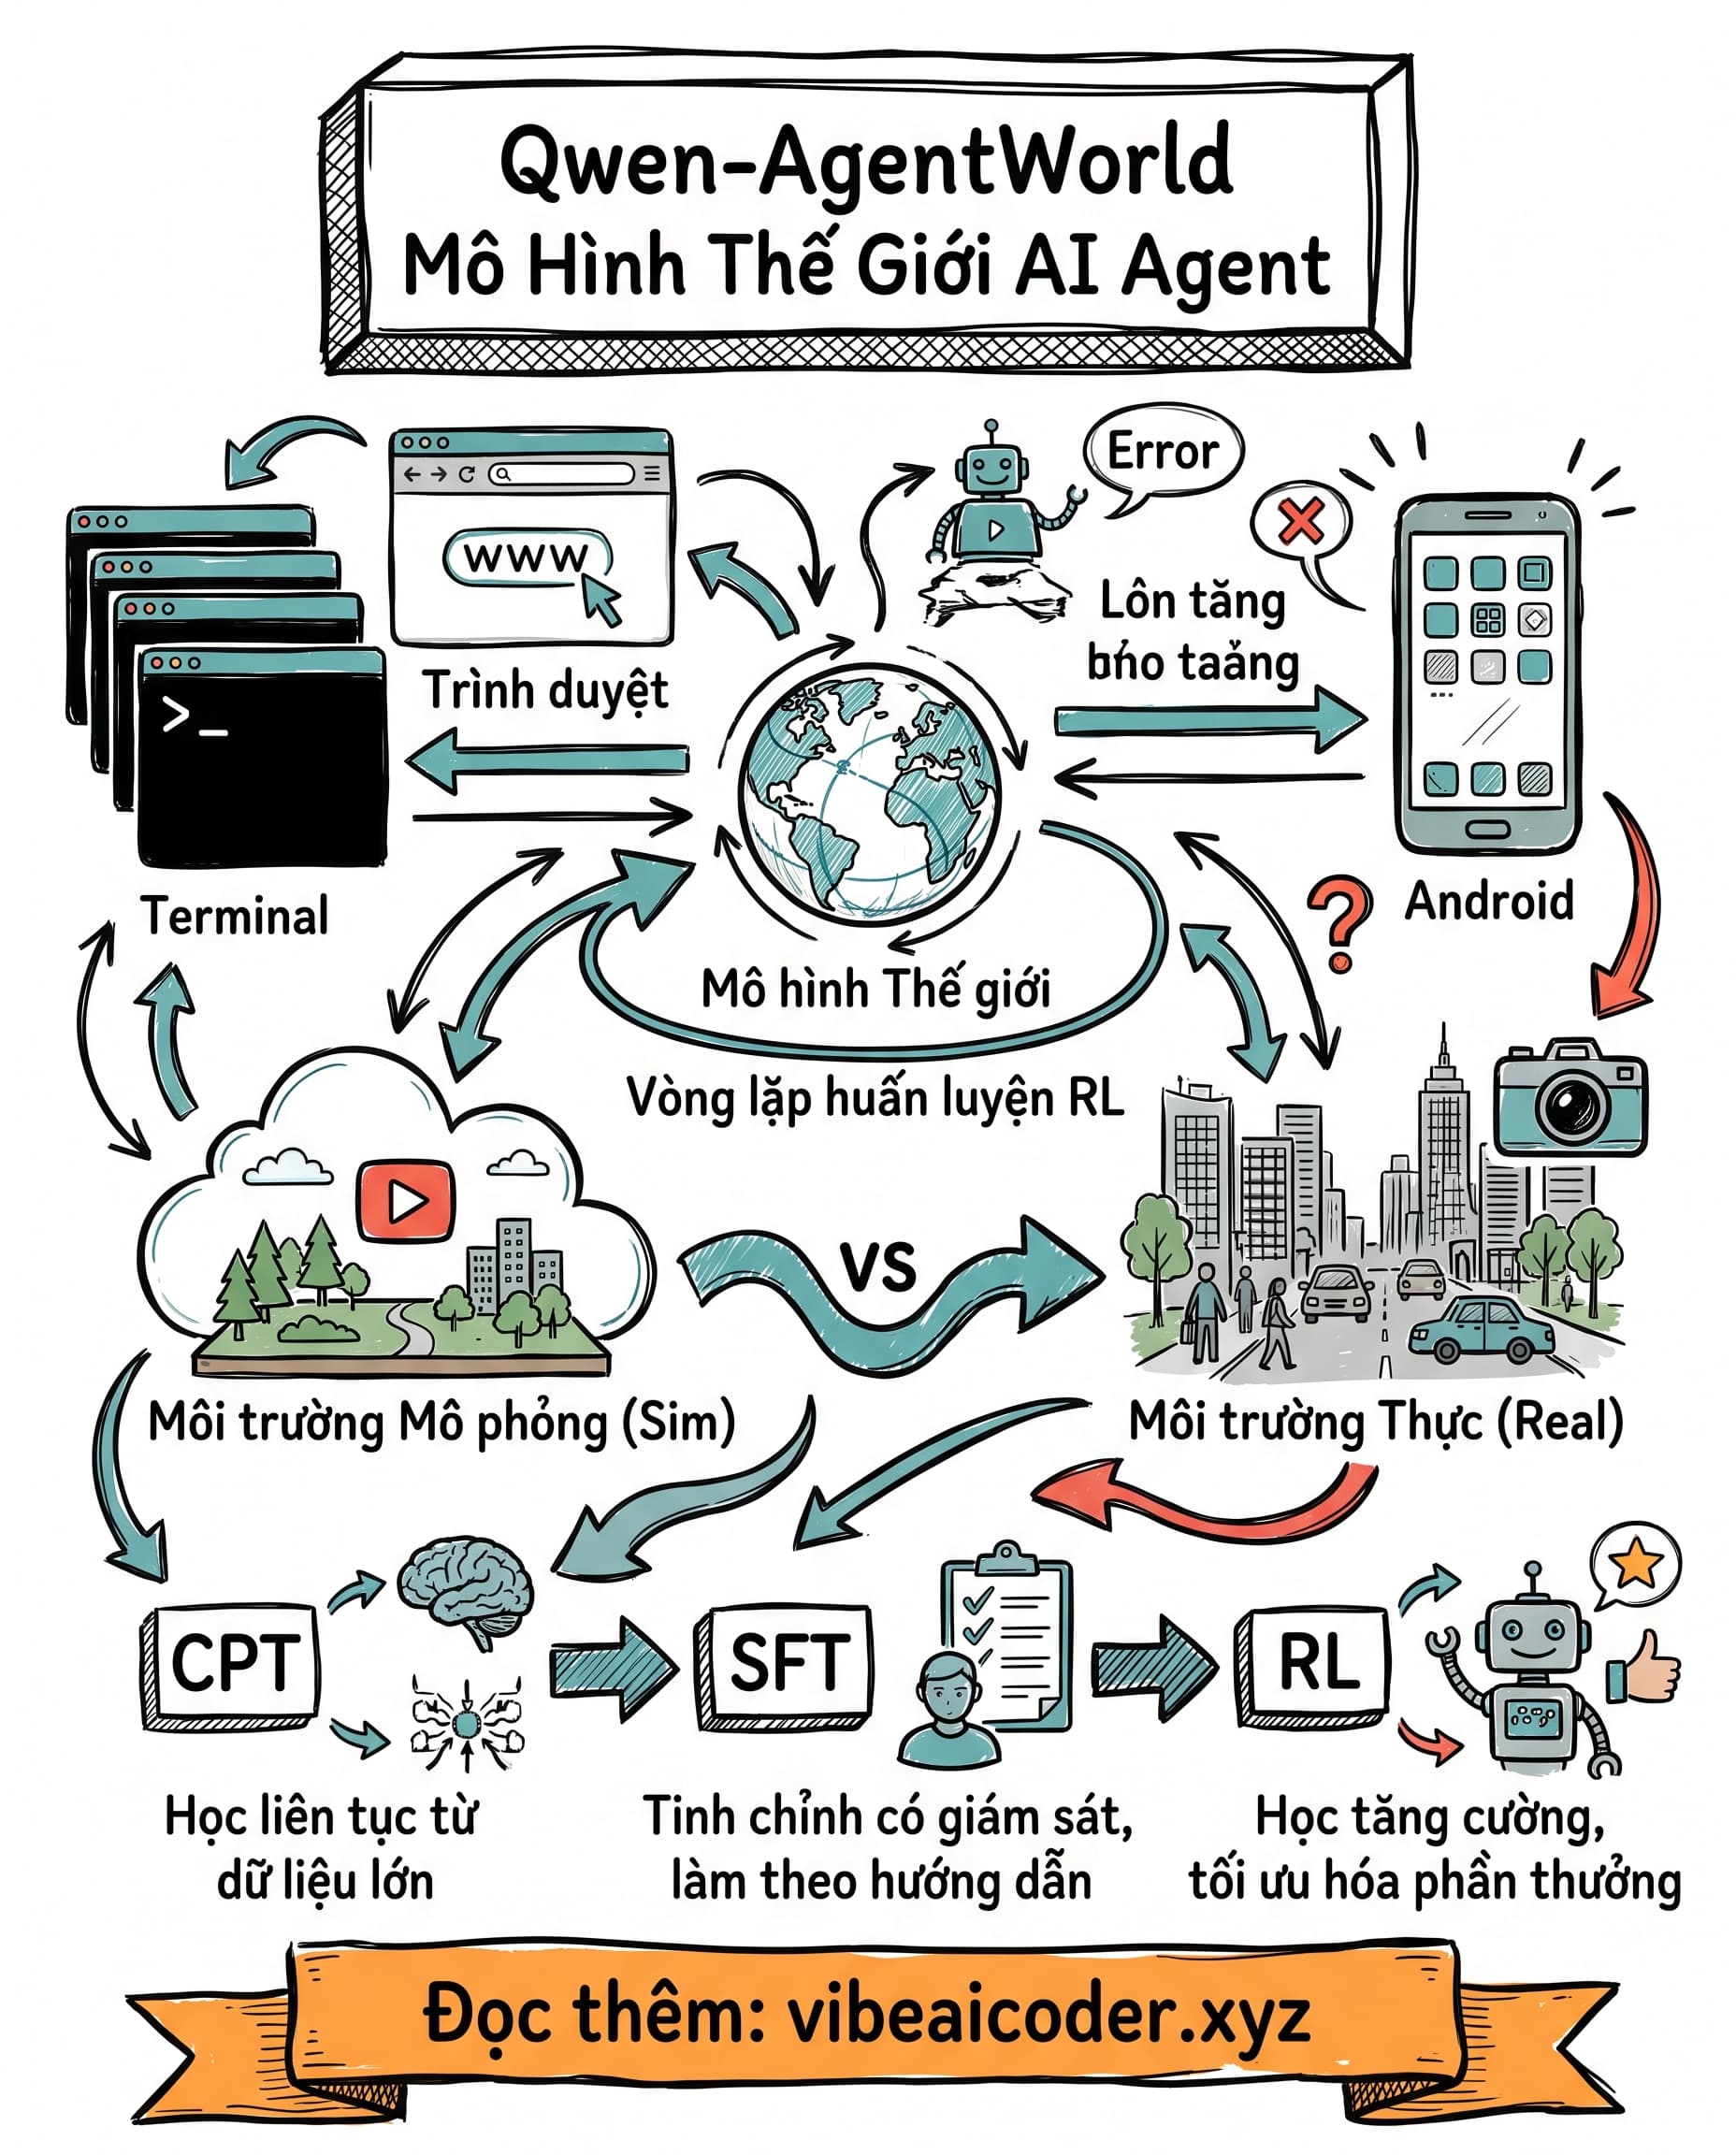
 Qwen-AgentWorld: Mô Hình Thế Giới Ngôn Ngữ Đầu Tiên Giúp AI Agent Tự Học Không Cần Hạ Tầng Thực