 Dùng AirLLM để chạy mô hình AI hàng chục tỷ tham số trên máy tính chỉ có 4GB card đồ họa
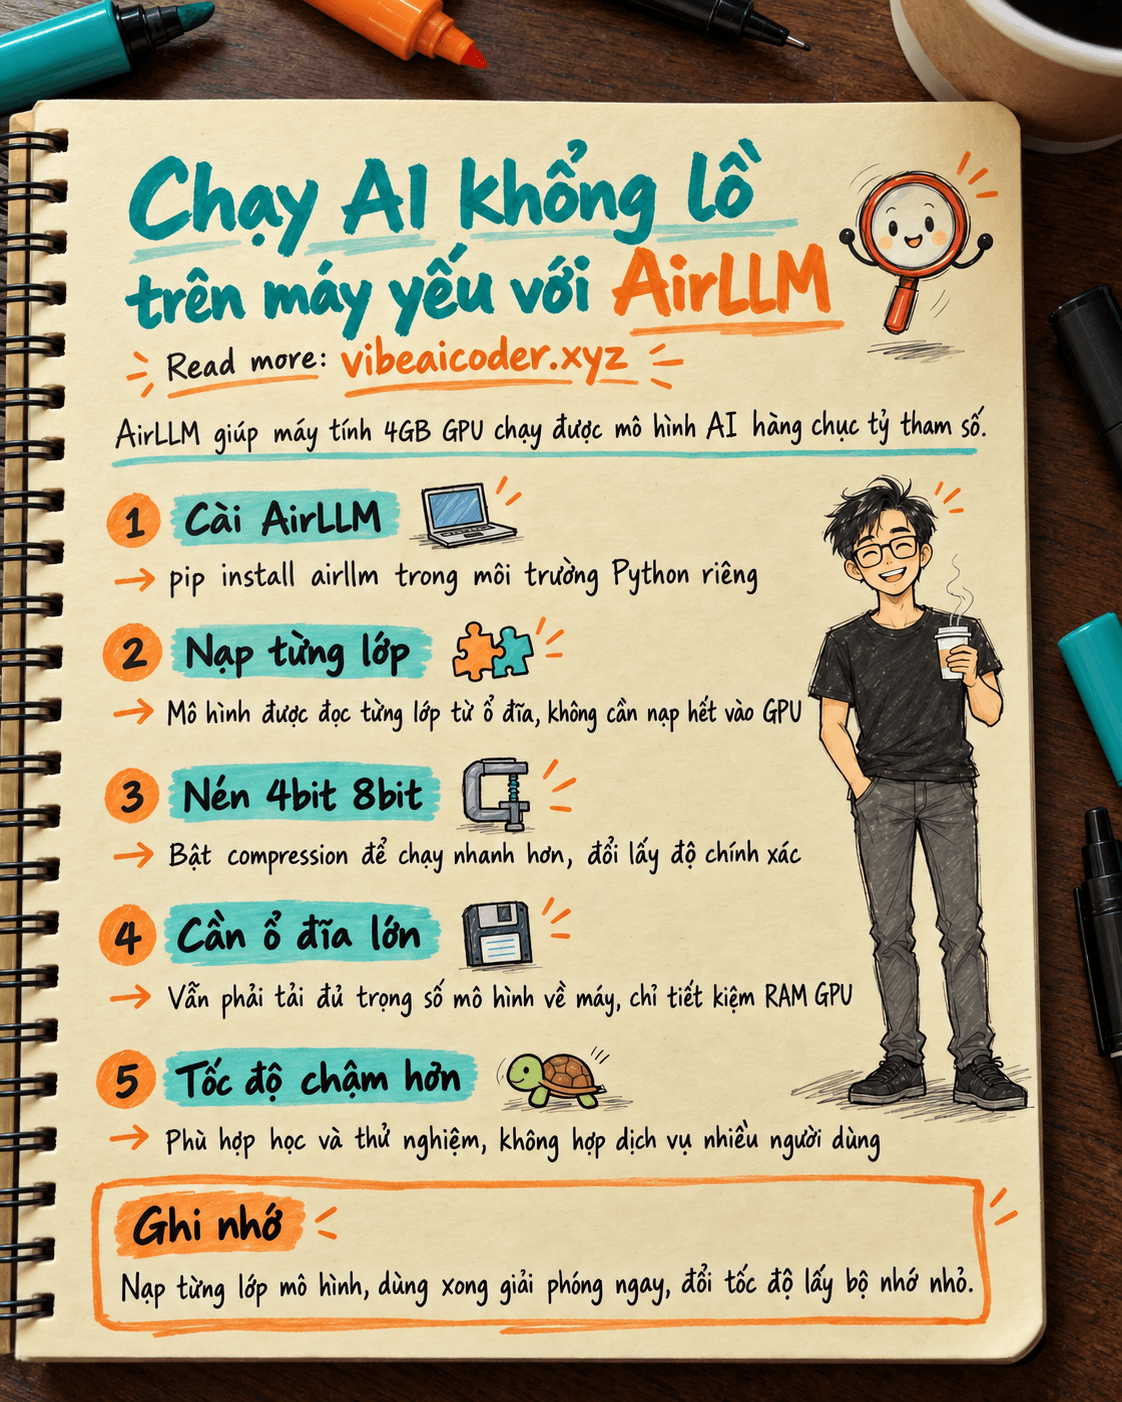
Bạn không cần một dàn máy chủ đắt tiền mới chạy được các mô hình AI mã nguồn mở cỡ lớn. Với công cụ miễn phí AirLLM, một chiếc laptop có card đồ họa chỉ 4GB vẫn có thể chạy được mô hình 70 tỷ tham số ngay trên máy, không cần internet sau khi đã tải model về. Bài này hướng dẫn bạn cài đặt và chạy thử trong khoảng 30 đến 60 phút, phần lớn thời gian là chờ tải mô hình.
 Chuẩn bị
- Máy tính chạy Linux hoặc Mac dùng chip Apple Silicon (M1 trở lên), đã cài sẵn Python 3.9 trở lên và
pip. - Một tài khoản Hugging Face (miễn phí) để tải mô hình về máy.
- Ổ cứng còn trống đủ chỗ cho mô hình bạn định chạy. Một mô hình 8 tỷ tham số (8B) chiếm khoảng 16GB ở định dạng gốc, mô hình 70 tỷ tham số (70B) chiếm hàng trăm GB, nên người mới nên bắt đầu với mô hình nhỏ.
- Card đồ họa (GPU) không bắt buộc phải mạnh. AirLLM chạy được cả khi GPU chỉ có vài GB bộ nhớ, miễn là máy đủ ổ đĩa và kiên nhẫn chờ.
 Làm từng bước
Bước 1: Tạo môi trường Python riêng
Mở terminal và tạo một môi trường ảo để không làm lẫn các thư viện khác trên máy:
python3 -m venv airllm-env
source airllm-env/bin/activate
Bước 2: Cài AirLLM
pip install airllm
AirLLM là thư viện mã nguồn mở, giấy phép Apache 2.0, miễn phí kể cả khi bạn dùng cho công việc kinh doanh nhỏ.
Bước 3: Viết một đoạn script chạy mô hình
Tạo file chay_ai.py với nội dung sau, thay chỗ có dấu ngoặc vuông bằng mô hình bạn muốn thử:
from airllm import AutoModel

model = AutoModel.from_pretrained("[tên mô hình trên Hugging Face, ví dụ Qwen/Qwen3-8B]")

input_text = ["[câu hỏi bạn muốn hỏi AI]"]
input_tokens = model.tokenizer(
    input_text,
    return_tensors="pt",
    return_attention_mask=False,
    truncation=True,
    max_length=256,
    padding=True,
)

output = model.generate(
    input_tokens["input_ids"].cuda(),
    max_new_tokens=100,
    use_cache=True,
)
print(model.tokenizer.decode(output[0]))
Cách hoạt động phía sau: thay vì nạp toàn bộ mô hình vào bộ nhớ GPU cùng lúc (cách này đòi hỏi hàng chục, hàng trăm GB bộ nhớ), AirLLM nạp từng lớp (layer) của mô hình, tính toán xong lớp đó rồi giải phóng bộ nhớ, sau đó mới nạp lớp tiếp theo từ ổ đĩa lên. Nhờ vậy bộ nhớ GPU chỉ cần giữ một phần rất nhỏ của mô hình tại một thời điểm.
Bước 4: Chạy script
python3 chay_ai.py
Lần chạy đầu tiên sẽ tải mô hình từ Hugging Face về máy, mất nhiều thời gian tùy tốc độ mạng và kích thước mô hình. Những lần chạy sau sẽ nhanh hơn vì mô hình đã được lưu sẵn trong máy.
Bước 5 (tùy chọn): Nén mô hình để chạy nhanh hơn
Nếu máy vẫn chạy chậm, bạn có thể bật thêm chế độ nén khi nạp mô hình:
model = AutoModel.from_pretrained(
    "[tên mô hình trên Hugging Face]",
    compression="4bit",
)
Chế độ nén 4bit hoặc 8bit làm mô hình nhẹ hơn, chạy nhanh hơn, đổi lại câu trả lời có thể giảm độ chính xác một chút.
 Kết quả mẫu
Sau khi chạy xong, terminal sẽ in ra câu trả lời của mô hình ngay bên dưới câu hỏi, ví dụ nếu bạn hỏi "Thủ đô của Việt Nam là gì?", mô hình sẽ in ra một đoạn văn bản có chứa câu trả lời "Hà Nội" kèm phần giải thích tùy theo mô hình bạn chọn. Tốc độ trả lời sẽ chậm hơn rõ rệt so với dùng ChatGPT hay Claude qua mạng, vì máy đang phải đọc từng phần mô hình từ ổ đĩa thay vì giữ sẵn trong bộ nhớ.
 Mẹo để kết quả tốt hơn
- Dùng ổ cứng SSD, tốt nhất là loại NVMe, thay vì ổ cứng cơ (HDD) vì AirLLM phải đọc dữ liệu từ ổ đĩa liên tục trong lúc chạy.
- Bắt đầu với mô hình nhỏ (8B hoặc nhỏ hơn) để làm quen trước khi thử mô hình lớn hơn.
- Đóng bớt các phần mềm nặng khác trên máy để dành bộ nhớ RAM và ổ đĩa cho mô hình.
- Nếu chỉ cần thử nghiệm nhanh, chọn mô hình đã có sẵn phiên bản nén (4bit) để tải về nhẹ hơn.
 Giới hạn cần biết
- Đây là công cụ cho mục đích học tập, thử nghiệm cá nhân, không phù hợp để làm dịch vụ chatbot phục vụ nhiều người dùng cùng lúc vì tốc độ xử lý chậm hơn nhiều so với chạy trên GPU đủ bộ nhớ hoặc gọi API đám mây.
- Bạn vẫn cần tải về toàn bộ trọng số của mô hình, nên tốn dung lượng ổ đĩa tương đương với kích thước gốc của mô hình, AirLLM chỉ giúp tiết kiệm bộ nhớ GPU lúc chạy, không giúp giảm dung lượng lưu trữ.
- Một số mô hình trên Hugging Face yêu cầu bạn đăng nhập và xin quyền sử dụng trước khi tải (mô hình "gated"), hãy đọc kỹ điều khoản sử dụng của từng mô hình trước khi dùng cho mục đích thương mại.
- Không phải mọi mô hình mã nguồn mở đều có giấy phép giống nhau, một số cấm dùng để kinh doanh, hãy kiểm tra trang Hugging Face của mô hình trước khi quyết định dùng lâu dài.
 Câu hỏi thường gặp
AirLLM có miễn phí không? Có. AirLLM là thư viện mã nguồn mở, giấy phép Apache 2.0, bạn có thể tải và dùng miễn phí. Bản thân mô hình AI (Llama, Qwen...) có giấy phép riêng, cần đọc kỹ trước khi dùng cho mục đích kinh doanh.
Không có card đồ họa rời thì có chạy được không? AirLLM hỗ trợ chạy trên Linux và trên máy Mac dùng chip Apple Silicon. Có GPU, dù chỉ vài GB bộ nhớ, vẫn giúp tốc độ nhanh hơn đáng kể so với chỉ dùng CPU.
Mô hình chạy quá chậm thì phải làm sao? Hãy thử bật chế độ nén compression="4bit", chuyển sang mô hình nhỏ hơn, hoặc đổi sang ổ SSD nếu bạn đang dùng ổ cứng cơ.
AirLLM có thay thế được việc dùng ChatGPT hay Claude qua mạng không? Không hẳn. AirLLM phù hợp khi bạn muốn tự chạy mô hình mã nguồn mở trên máy riêng để học hoặc thử nghiệm, còn các dịch vụ như ChatGPT, Claude vẫn nhanh và tiện hơn nhiều cho công việc hàng ngày.
Tôi cần biết lập trình giỏi mới dùng được AirLLM không? Không cần giỏi. Bạn chỉ cần biết mở terminal, chạy vài dòng lệnh và chỉnh sửa một đoạn script Python mẫu như bài này, phù hợp cả với người mới học lập trình muốn tìm hiểu cách AI chạy "bên trong".
Nếu bạn chưa quen với những khái niệm như tham số, lượng tử hóa hay AI chạy tại chỗ, có thể đọc thêm các bài nền tảng sau trước khi thực hành: AI là gì, lượng tử hóa (quantization) là gì, AI chạy tại chỗ (local AI) là gì và tham số (parameter) của AI là gì.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 7 Lệnh Claude Code Giúp Dân Vibe Coding Tăng Tốc Gấp Đôi Mỗi Ngày