 Haiku, Sonnet hay Opus: Chọn model Claude nào để không lãng phí tiền?
Nhiều người cứ mặc định dùng model mạnh nhất rồi ngạc nhiên khi hóa đơn API cuối tháng cao gấp 5 lần cần thiết.
 Ba model, ba mức giá rất khác nhau
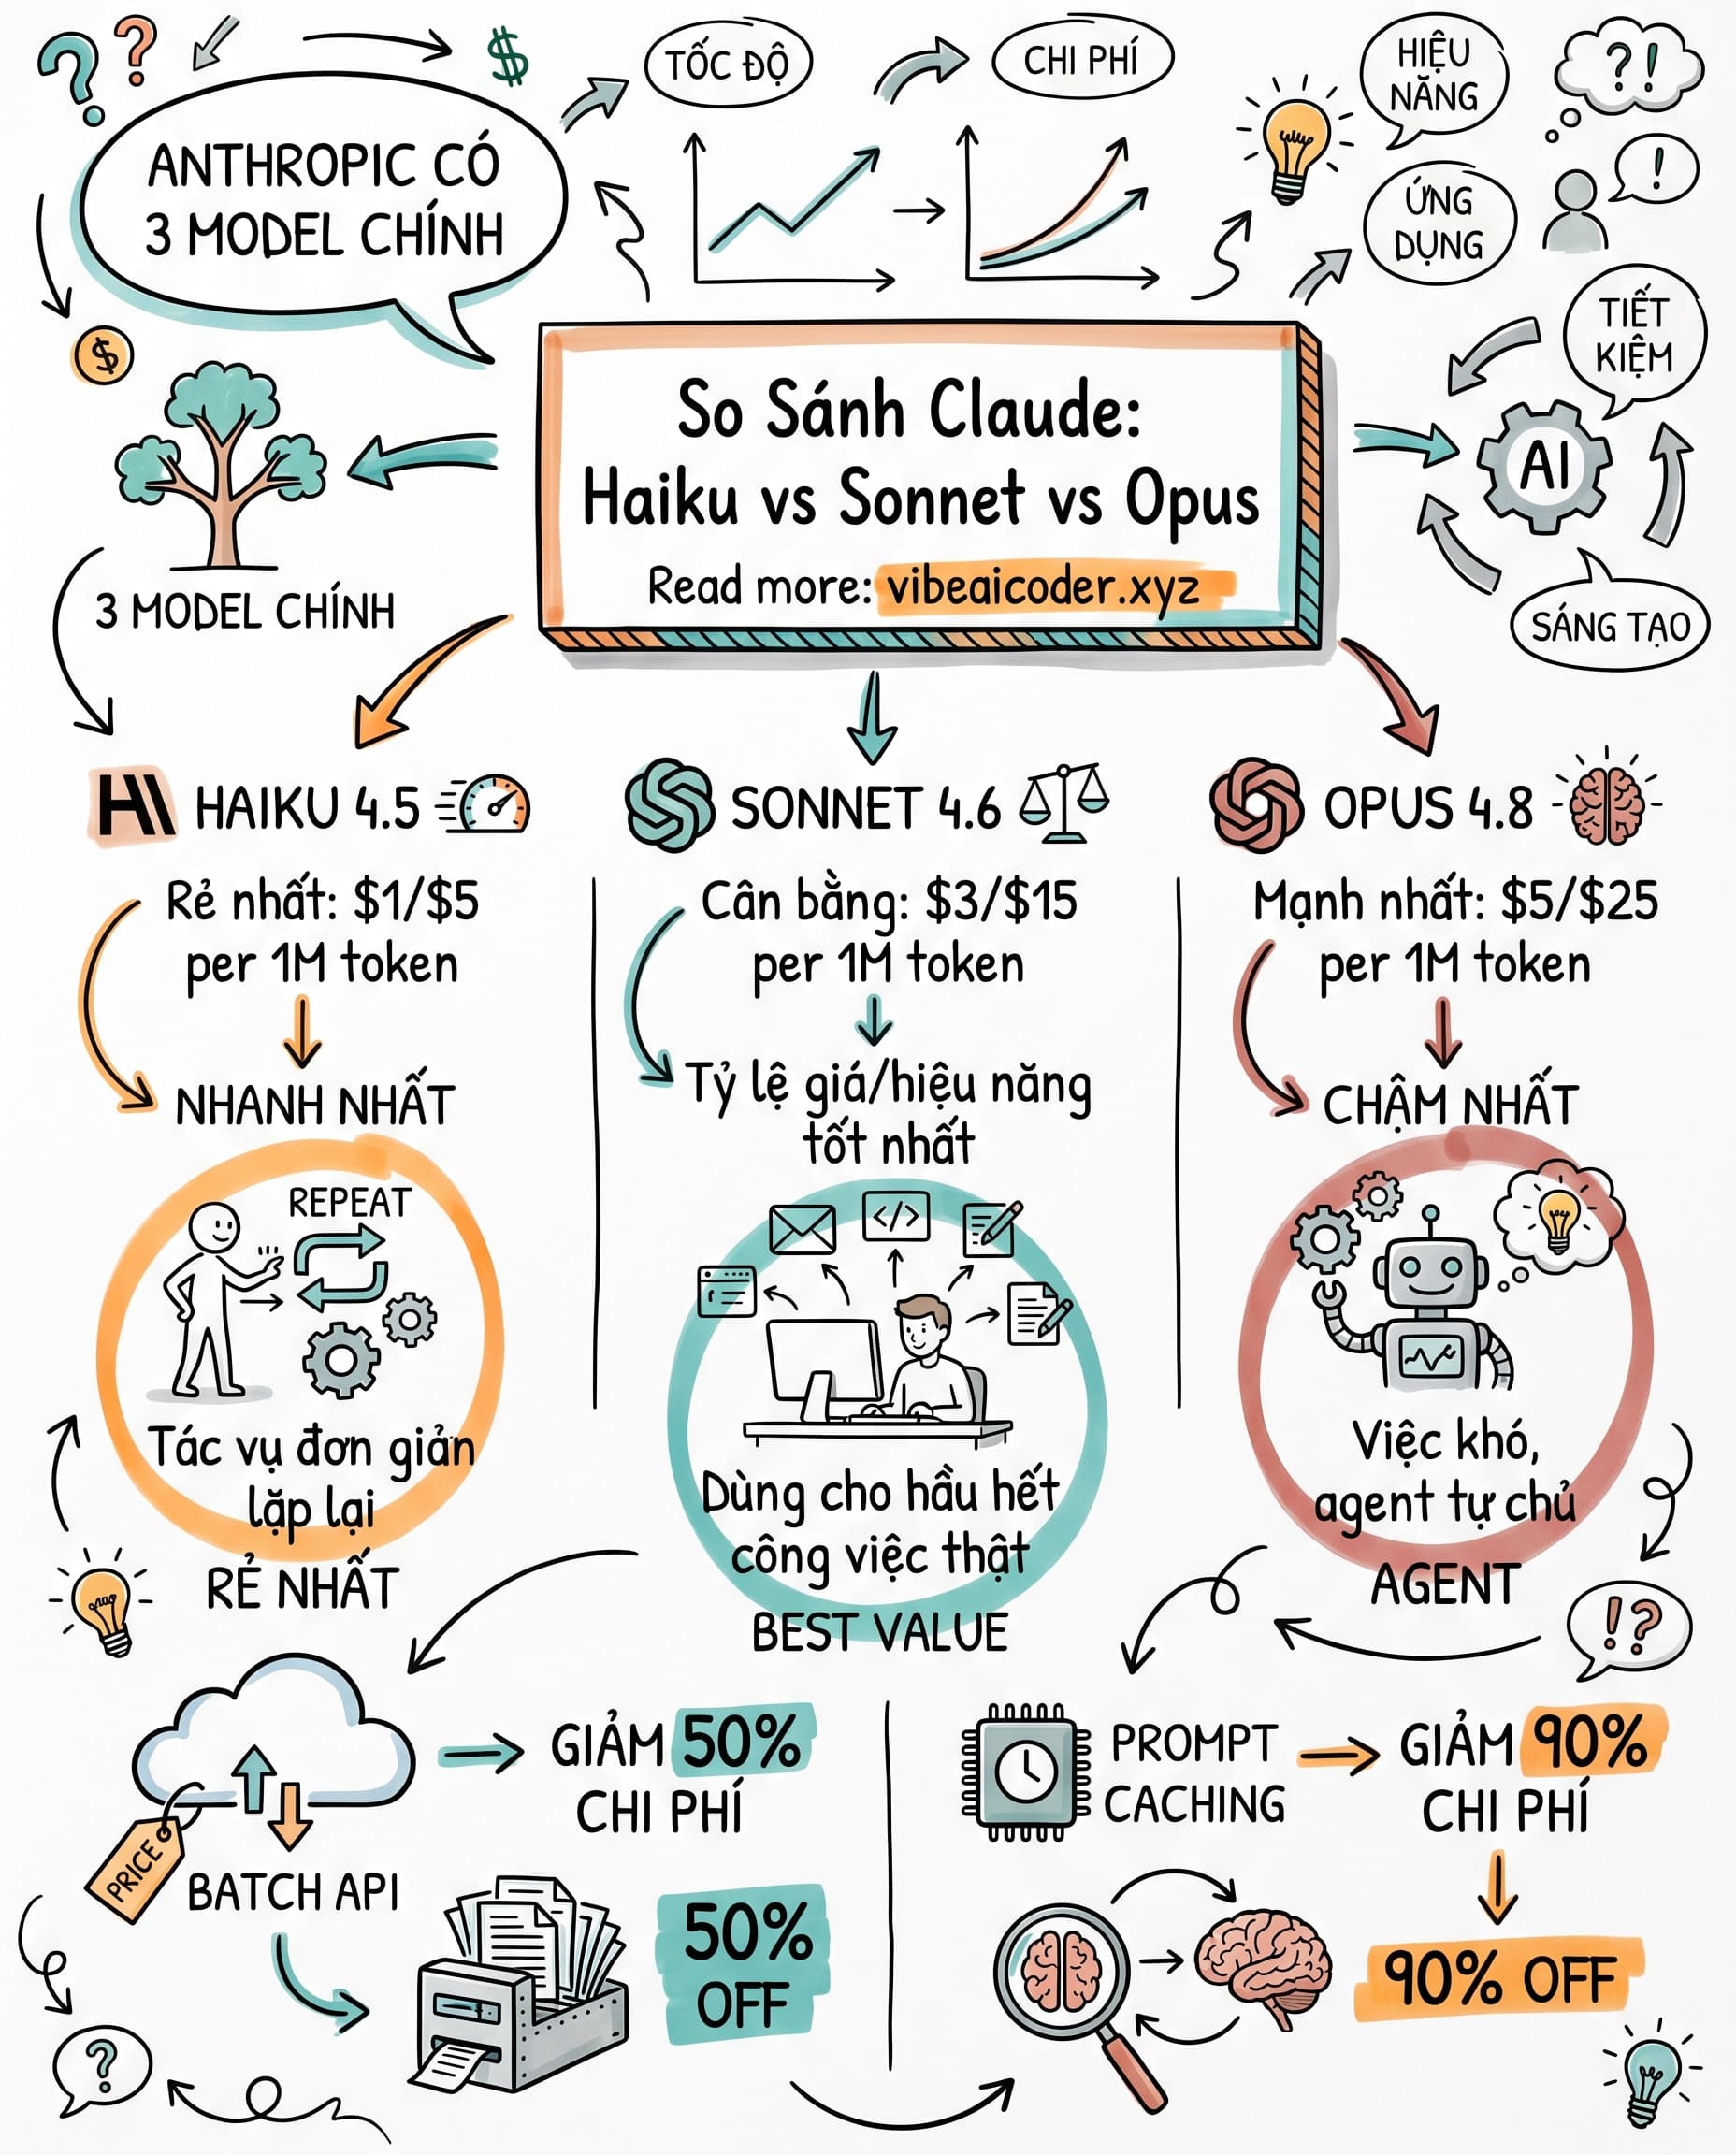
Anthropic năm 2026 có ba model chính: Haiku 4.5, Sonnet 4.6, và Opus 4.8. Giá tính theo mỗi 1 triệu token, và khoảng cách giữa chúng không hề nhỏ.
Haiku 4.5 chỉ tốn $1 input và $5 output, rẻ nhất trong ba. Sonnet 4.6 ở mức $3 input và $15 output, cân bằng giữa giá và sức mạnh. Opus 4.8 đắt nhất với $5 input và $25 output. Tức là nếu bạn dùng Opus thay vì Haiku cho cùng một tác vụ, bạn đang trả gấp 5 lần chi phí đầu vào và gấp 5 lần chi phí đầu ra mà không nhất thiết có lý do.
 Haiku 4.5: Nhanh, rẻ, dùng cho việc lặp đi lặp lại
Haiku sinh ra để xử lý khối lượng lớn, tốc độ cao, chi phí thấp. Nếu bạn cần phân loại hàng nghìn văn bản, trích xuất dữ liệu có cấu trúc, tóm tắt đoạn ngắn, trả lời FAQ chatbot, hay tiền xử lý dữ liệu trước khi đưa vào pipeline phức tạp hơn, đây là lựa chọn mặc định.
Điểm mạnh không phải ở độ sâu tư duy mà ở tốc độ phản hồi và chi phí cực thấp. Cứ nghĩ Haiku như nhân viên làm việc nhanh, không cần hướng dẫn phức tạp, hoàn thành tác vụ rõ ràng mà không phải suy nghĩ nhiều. Anthropic đã ra bản kế nhiệm Haiku 5.5 với chi phí vận hành thấp hơn nữa, xem số liệu cụ thể so với Sonnet 5.5 tại bài Haiku 5.5 đã đủ tốt để làm gì.
 Sonnet 4.6: Lựa chọn mặc định cho hầu hết công việc thực
Sonnet 4.6 có tỷ lệ giá trên hiệu năng tốt nhất trong ba model. Đây là model bạn nên dùng cho phần lớn công việc thực tế: viết code, xây dựng tính năng mới, phân tích tài liệu, viết nội dung có chiều sâu, hay các quy trình cần gọi tool nhiều bước.
Nó đủ mạnh để xử lý những bài toán có logic phức tạp, nhưng không quá đắt để bạn phải lo ngại khi dùng thường xuyên. Nếu bạn chưa biết nên chọn model nào, bắt đầu với Sonnet 4.6 luôn là câu trả lời an toàn.
 Opus 4.8: Chỉ dùng khi thực sự cần đến nó
Opus 4.8 là model mạnh nhất nhưng cũng chậm nhất và đắt nhất. Dùng nó khi bài toán thực sự đòi hỏi: lập luận nhiều bước phức tạp, refactor codebase lớn với nhiều phụ thuộc, agent tự chủ chạy dài hạn, hay các bài toán nghiên cứu cần suy luận sâu.
Có một điểm cần lưu ý: tokenizer thế hệ mới của Opus có thể sinh ra nhiều hơn tới 35% token so với các model cũ cho cùng một đoạn văn bản. Nghĩa là chi phí thực tế bạn trả có thể cao hơn đáng kể so với giá niêm yết. Hãy tính toán kỹ trước khi đẩy toàn bộ pipeline sang Opus.
Cả ba model đều hỗ trợ cửa sổ ngữ cảnh 1 triệu token, nên context length không phải yếu tố phân biệt ở đây.
 Bốn chiến lược giảm chi phí thực tế
Chọn đúng model chỉ là bước đầu. Có thêm vài kỹ thuật giúp giảm chi phí đáng kể mà không ảnh hưởng chất lượng output.
Batch API cho phép bạn gửi nhiều request cùng lúc và nhận kết quả sau, đổi lại bạn tiết kiệm được 50% chi phí token. Phù hợp với mọi tác vụ không cần phản hồi tức thì.
Prompt caching giảm tới 90% chi phí phần input được cache, cực kỳ hiệu quả khi bạn lặp lại cùng một khối ngữ cảnh lớn qua nhiều request, ví dụ một tài liệu dài hay một system prompt phức tạp.
Model routing trong pipeline là kỹ thuật dùng Haiku cho các bước đơn giản như phân loại, lọc, định dạng, rồi chỉ đẩy phần thực sự khó lên Sonnet hoặc Opus. Cách này giúp cả hệ thống rẻ hơn nhiều mà chất lượng đầu ra cuối vẫn giữ nguyên.
Quy tắc thực dụng để nhớ: bắt đầu với Sonnet 4.6, đo chất lượng kết quả, hạ xuống Haiku nếu thấy dư thừa, nâng lên Opus nếu thấy chưa đủ. Đừng đoán mò, hãy đo thực tế.
Bạn đang dùng model nào trong dự án hiện tại? Có bao giờ bị hóa đơn API "giật mình" chưa? Comment xuống dưới chia sẻ nhé!
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ

 AI Trung Quốc rẻ hơn 10 lần, hiệu năng ngang OpenAI GPT-5.5?