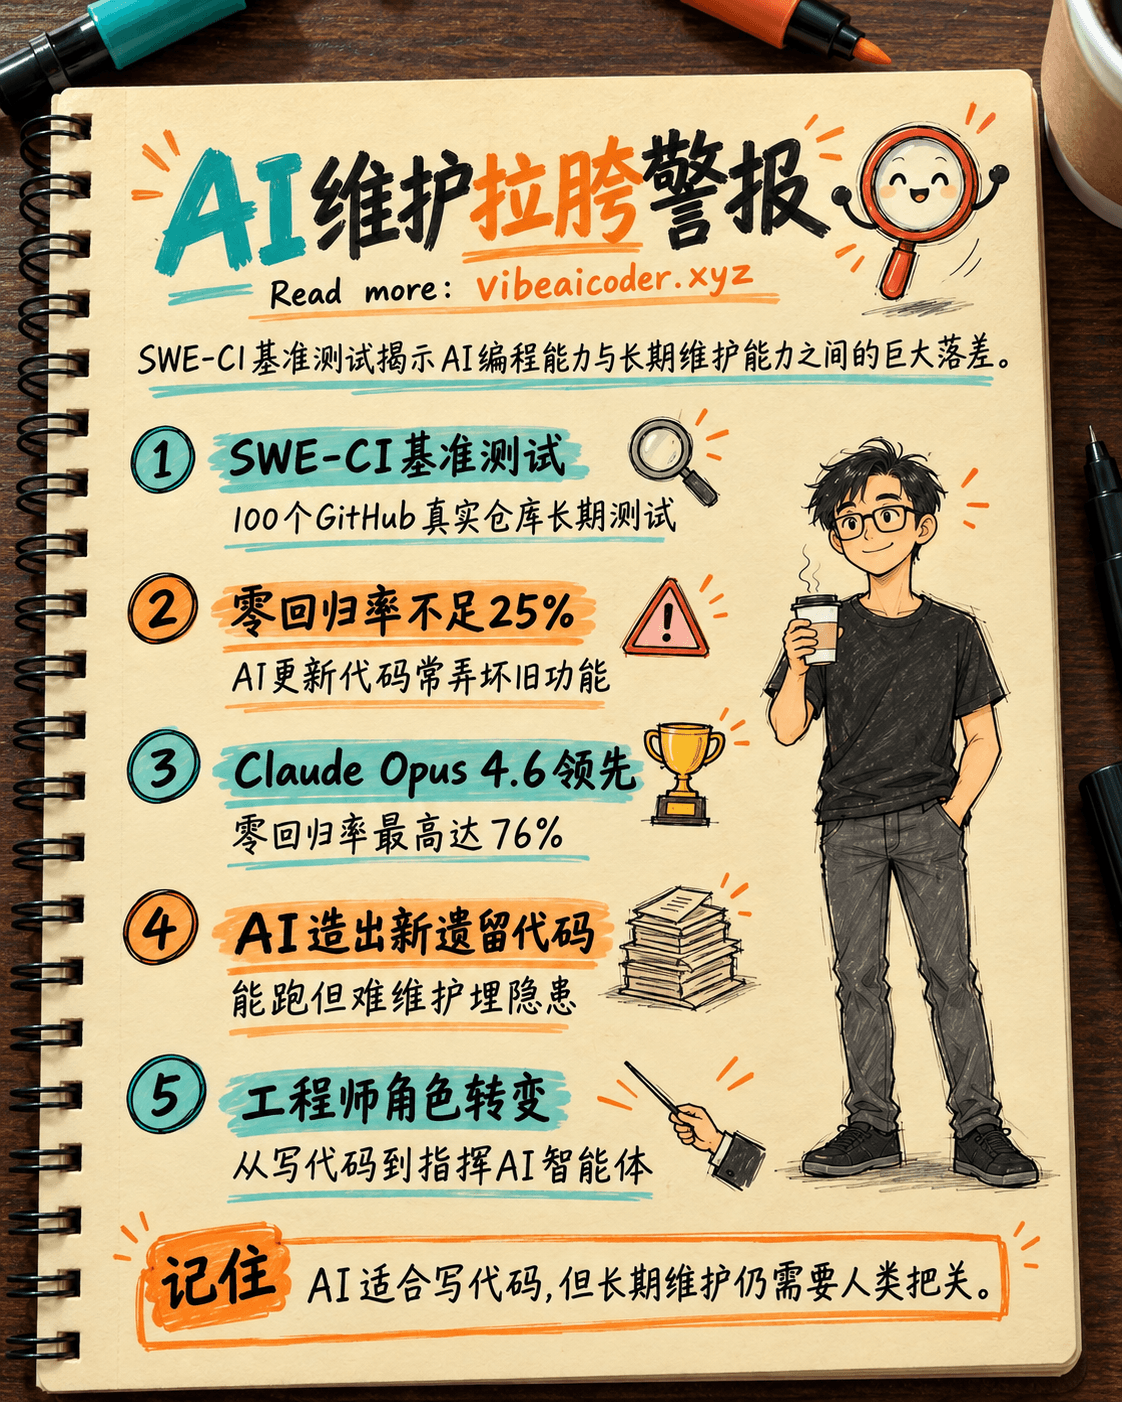
 震惊:AI写代码一流,维护代码却很拉胯
你以为AI已经能接手大型代码库的长期维护工作了?先别急着下结论。阿里巴巴联合多家机构在2026年3月公布的全新基准测试SWE-CI,狠狠给AI编程能力泼了一盆冷水。它提醒我们:只看AI能不能写出一小段漂亮代码远远不够,长期维护的真相才更值得警惕。
 SWE-CI基准测试到底是什么?
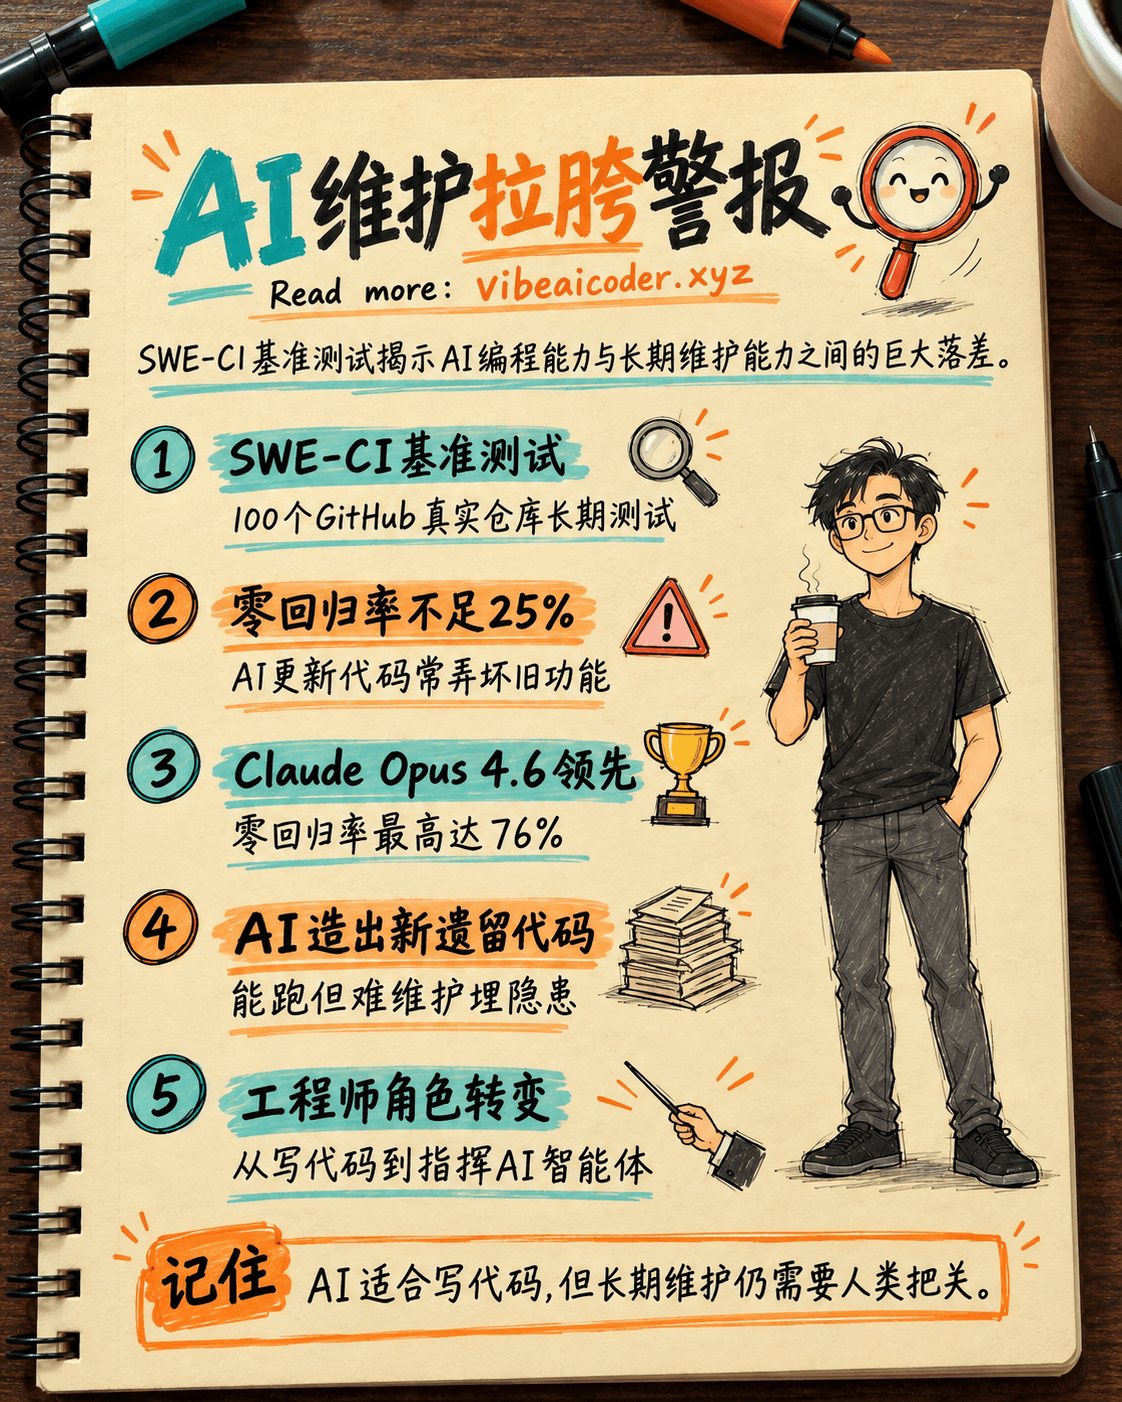
和传统的"一次性"编程测试不同,SWE-CI不只检验AI能不能修复一个bug,还要评估AI能不能在很长一段时间里持续维护同一个代码库。它模拟的是真实软件开发中的持续集成(CI)流程,而不是孤立的一次性任务。
为了让测试尽量贴近真实世界,研究团队挑选了100个来自GitHub的真实代码仓库,筛选标准相当严格:star数超过500,且已经持续维护3年以上,确保代码质量和维护流程都经得起推敲。每个仓库平均要经历233天的开发周期,每个任务平均需要连续提交71次commit,工作量一点也不轻松。
测试采用"双智能体"(Dual-Agent)架构:一个扮演"架构师",负责分析问题、制定方案;另一个扮演"程序员",负责具体写代码,整体上很贴近真实开发团队的协作方式。这些具体数字能帮你更直观地理解这个基准测试的规模和严谨程度。
 结果令人震惊:AI长期维护依然"拉胯"
虽然现在的AI模型写短代码的能力很强,但研究发现,它们在维护系统、不破坏原有功能这件事上还差得远。参与测试的18个主流模型(来自OpenAI、Anthropic、阿里巴巴、智谱AI等8家头部厂商)中,大多数模型的"零回归率"(Zero-regression rate,即更新代码后不破坏已有功能测试的比例)得分都不到25%。
换句话说,在75%的情况下,AI在更新代码时会不小心弄坏已有功能的测试用例。这意味着开发者在使用AI生成的代码时必须格外小心,尤其是在大型项目里。
目前只有Anthropic的Claude Opus(4.6版本)和智谱AI的GLM-5(中国团队出品)这两个模型的零回归率超过了50%这道门槛。部分报告甚至指出,Claude Opus 4.6在某些具体指标上能达到76%,这算是一线希望。但总体来看,大多数模型仍停留在25%上下,长期维护能力依然是一道难题。
 新问题:AI制造的"遗留代码"
AI居然也会制造"技术债"!不少开发者反映,AI正在制造一种全新的"遗留代码"(legacy code):当下能跑通,但后续维护起来很困难,甚至会给未来的更新埋下隐患。
这对任何正在用AI辅助开发的人来说都值得警惕。如果不重视架构设计和长期可扩展性,后果可能很严重,会让未来的维护变得更难、更贵。这也进一步说明,对AI生成的代码做人工审查(review)有多重要。
🧑💻 这对软件工程师意味着什么?
这项研究再次证明,短期内AI还无法完全取代人类,尤其是在维护大型系统这件事上。人类在代码审查(Review)、测试(Testing)以及处理AI在系统规模扩大后经常忽略的边界情况(Edge Cases)方面,仍然至关重要。这些边界情况往往相当复杂,需要人类的实际经验才能准确识别和处理。
程序员的角色正从"逐行写代码的人"转变为"指挥AI智能体的乐队指挥",更多精力放在系统架构上,而不是具体细节。这也给软件工程师带来了新的机会,可以转向系统架构和管理方向发展,而不只是埋头写代码。
研究中用到的关键指标,比如EvoScore(衡量代码在未来修改中的准确性)和回归率(regression rate),也被详细记录下来,方便大家全面了解整套评估方法,进一步看懂这个基准测试背后的技术细节。
你觉得AI会很快解决这个长期维护的问题吗?欢迎留言说说你的看法。
常见问题
SWE-CI基准测试和普通的编程测试有什么不同? 普通测试大多是"一次性"任务,只看AI能不能一次性把代码写对或修好一个bug。SWE-CI则模拟真实的持续集成流程,考察AI在几百天的开发周期里能不能持续维护代码而不破坏已有功能。
为什么"零回归率"这么重要? 零回归率反映的是AI更新代码后,有没有不小心弄坏已有功能的测试用例。大多数模型得分不到25%,说明AI在修改代码时经常"拆东墙补西墙",这对长期维护中的代码质量是很大的风险。
哪些模型在SWE-CI中表现最好? 目前只有Anthropic的Claude Opus 4.6和智谱AI的GLM-5零回归率超过50%,其中Claude Opus 4.6在部分具体指标上甚至达到76%,明显领先其他参测模型。
这是不是说AI不适合用来写代码了? 不是。AI在写短代码、快速实现功能上依然很强,只是在长期维护、保证系统稳定性方面还不够成熟。更现实的做法是让人类负责代码审查、测试和架构把关,AI负责具体实现。



 Claude Opus 5.5 发布:速度提升30%,价格降低40%,防止AI大脑被复制