Claude Sonnet 5.5とGPT-6.1 Solの比較:同じ価格でどちらが良いか
大手2社が1日違いで新モデルを発表、価格も同じ
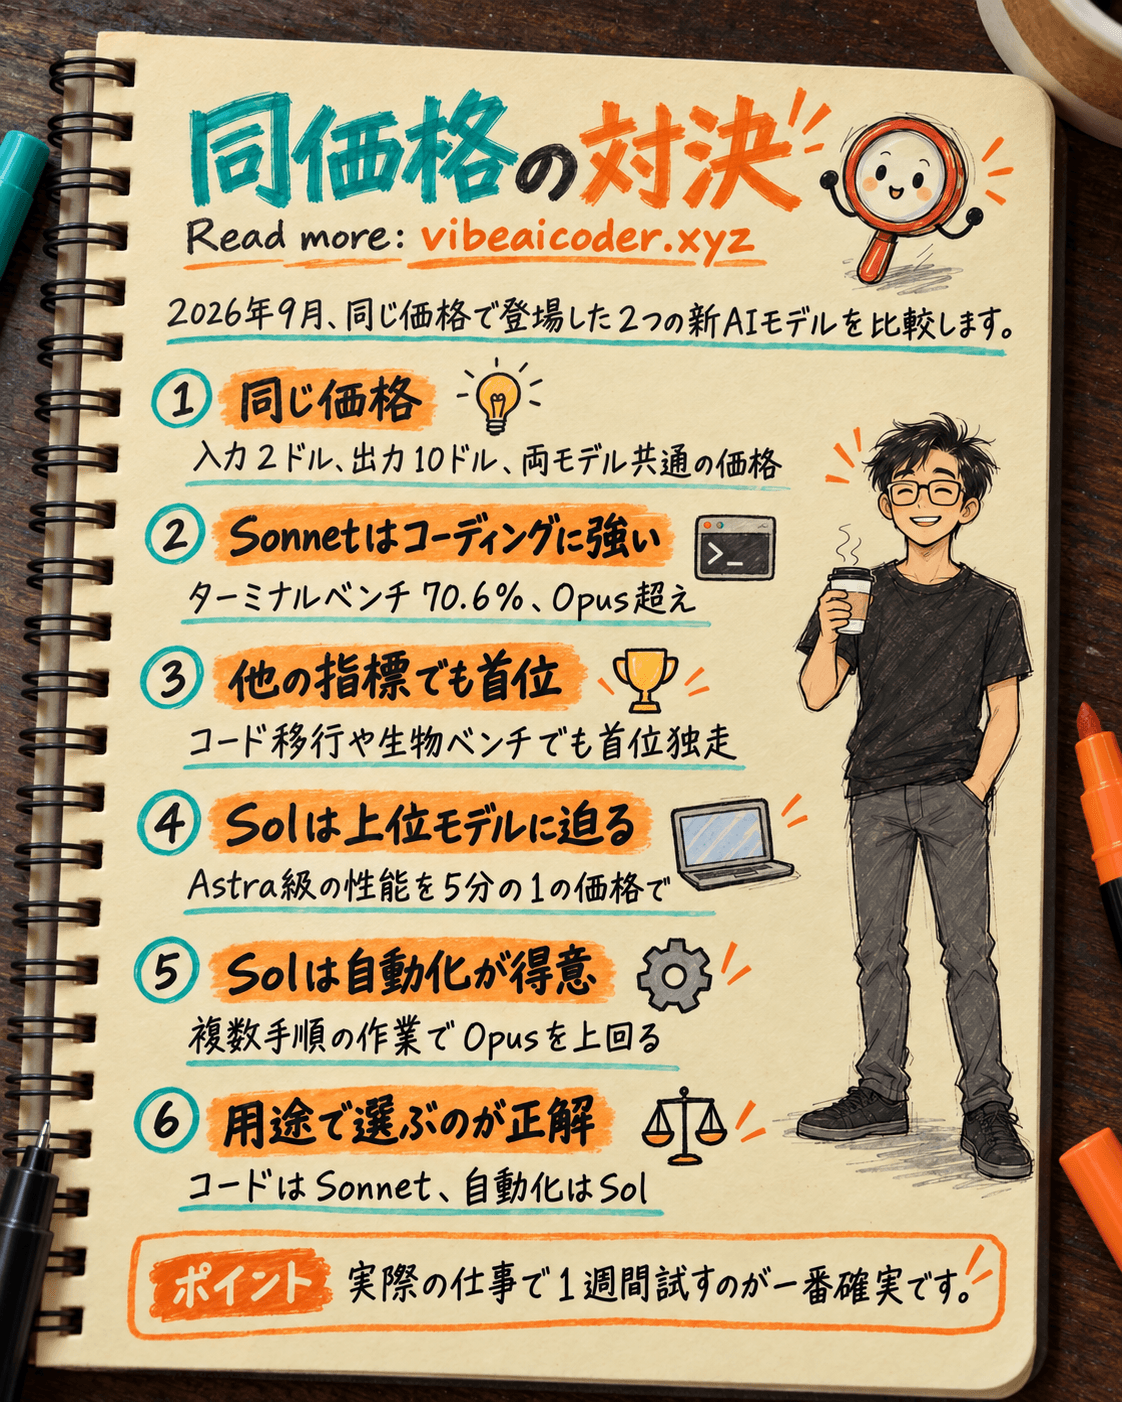
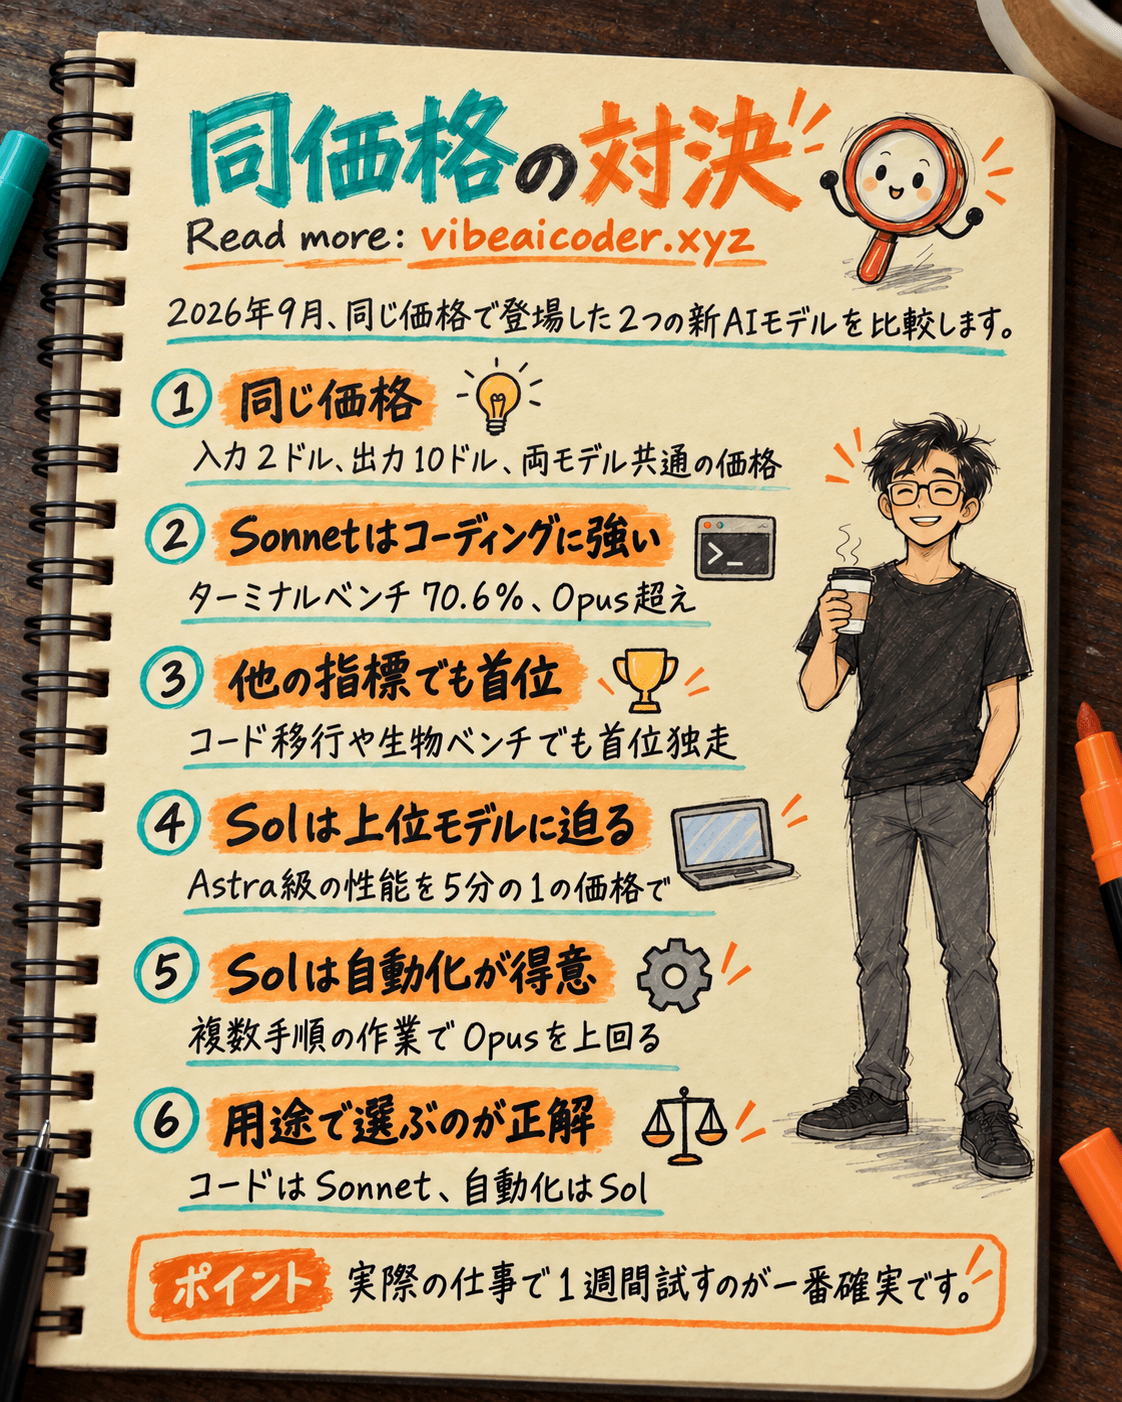
2026年9月28日と29日、AnthropicとOpenAIがそれぞれ新しいフラッグシップモデルを発表しました。Claude Sonnet 5.5とGPT-6.1 Solです。興味深いことに、両モデルの価格はまったく同じで、入力100万トークンあたり2ドル、出力100万トークンあたり10ドルでした。予算は同じでも、得意分野はまったく違います。この記事では、それぞれのモデルが何に強いのかを整理し、コーディング、作業の自動化、日常的な質問応答など、用途に合った方を選べるようにします。
Claude Sonnet 5.5、コーディングとコンピュータ操作が大きく進化
Sonnet 5.5はSonnet 5の後継モデルで、処理速度は30%以上向上、タスクあたりのコストは最大30%削減、それでいて価格は従来と同じという触れ込みで登場しました。
最大の注目点は、ターミナル上で直接作業できる能力です。質問に答えるだけでなく、コマンドを実行して実際の技術的な操作をこなせます。Terminal Benchというテストでは、Sonnet 5.5が70.6%を記録した一方、旧モデルのSonnet 5はわずか10.3%でした。さらに、Anthropicの上位モデルであるClaude Opus 5.5(66.4%)をも上回っています。つまり、少なくともこのベンチマークに関しては、高価なOpusにお金を払わなくても強力なコーディング性能が得られるということです。
Sonnet 5.5は他にも3つのランキングで首位に立っています。文章による指示だけでアプリを作る能力(Vibe Code Bench)、プログラミング言語間のコード移行(Code Migration)、複雑な生物学の問題を解く能力(BioMysteryBench)です。詳しくはClaude Sonnet 5.5の詳細記事をご覧ください。
GPT-6.1 Sol、最上位モデルに迫る性能を5分の1の価格で
OpenAI側のGPT-6.1 Solは、DevDay 2026で発表されました。メッセージは明確で、OpenAIの最上位モデルであるGPT-6 Astraに迫る性能を、約5分の1の価格で提供するというものです(Astraの価格は入力100万トークンあたり10ドル、出力100万トークンあたり50ドル)。
ソフトウェアのバグ修正を測るDeepSWEのテストでは、SolはAstraと同等のスコアを5分の1のコストで達成しました。コンピュータ操作の自動化を測るOSWorldでは、SolはAstraにわずか2.1ポイント差で迫りながら、価格は約7分の1です。特に、複数ステップの作業を自律的にこなす能力を測るAutomationBenchでは、SolがAnthropicのOpus 5.5を2.2ポイント上回りました。さらに、過去に使った内容を再利用する場合(キャッシュ)、価格は最大95%割引され、100万トークンあたりわずか0.10ドルになります。詳しくはDevDay 2026とGPT-6.1 Solのまとめ記事をご覧ください。
では、どちらが強いのか
この2つのモデルを直接対決させたベンチマークはまだ存在しないため、正直な答えは「やりたいことによる」です。
- コーディング、バグ修正、コマンドライン作業が中心の人には、Sonnet 5.5が非常に印象的な結果を出しており、Anthropic自身の上位モデルOpus 5.5さえも上回っています。
- 複数ステップの自動化、画面操作、限られた予算で大量の作業をこなす必要がある人には、GPT-6.1 Solが有力な選択肢です。OpenAIの最上位モデルに迫る性能を、はるかに低い価格で得られるからです。
両モデルとも、2026年の大きな流れを裏付けています。AI企業はもはや最強モデルの開発だけを競っているのではなく、大企業だけでなく誰もが使える「強くて安い」モデルを作る競争をしているのです。
どちらのモデルを選ぶべきか
AIをまだあまり理解していない、Claudeが何なのかもよく分からないという人は、より深い比較に進む前に初心者向けClaude AIガイドを読んでおくことをおすすめします。すでにコーディング作業でAIを活用している人は、両方のモデルを実際の仕事で1週間試してみるのが一番早い方法です。ベンチマークのスコアはあくまで参考にすぎず、実際に使ってみた感覚こそが最も重要だからです。
 Claude Opus 5.5登場:30%高速化、40%値下げ、AIの頭脳コピーを防止